
 语音小管家
论文链接:https://arxiv.org/abs/2409.00750
Demo展示:https://modelscope.cn/studios/amphion/maskgctAmphion地址:https://github.com/open-mmlab/Amphion
模型下载:https://modelscope.cn/models/amphion/MaskGCT
项目地址:https://github.com/open-mmlab/Amphion/tree/main/models/tts/maskgct
公测版地址(趣丸千音):voice.funnycp.com
现有大规模文本到语音(TTS)系统通常分为自回归和非自回归系统。自回归系统隐式地建模持续时间,但在鲁棒性和持续时间可控性方面存在一定缺陷。非自回归系统在训练过程中需要显式的文本与语音对齐信息,并预测语言单元(如音素)的持续时间,这可能会影响其自然度。
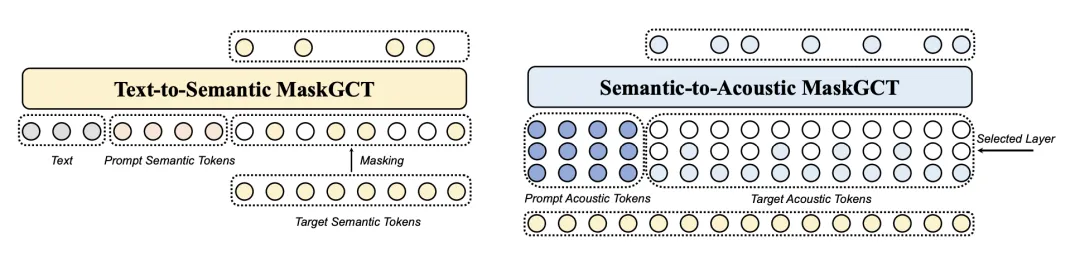
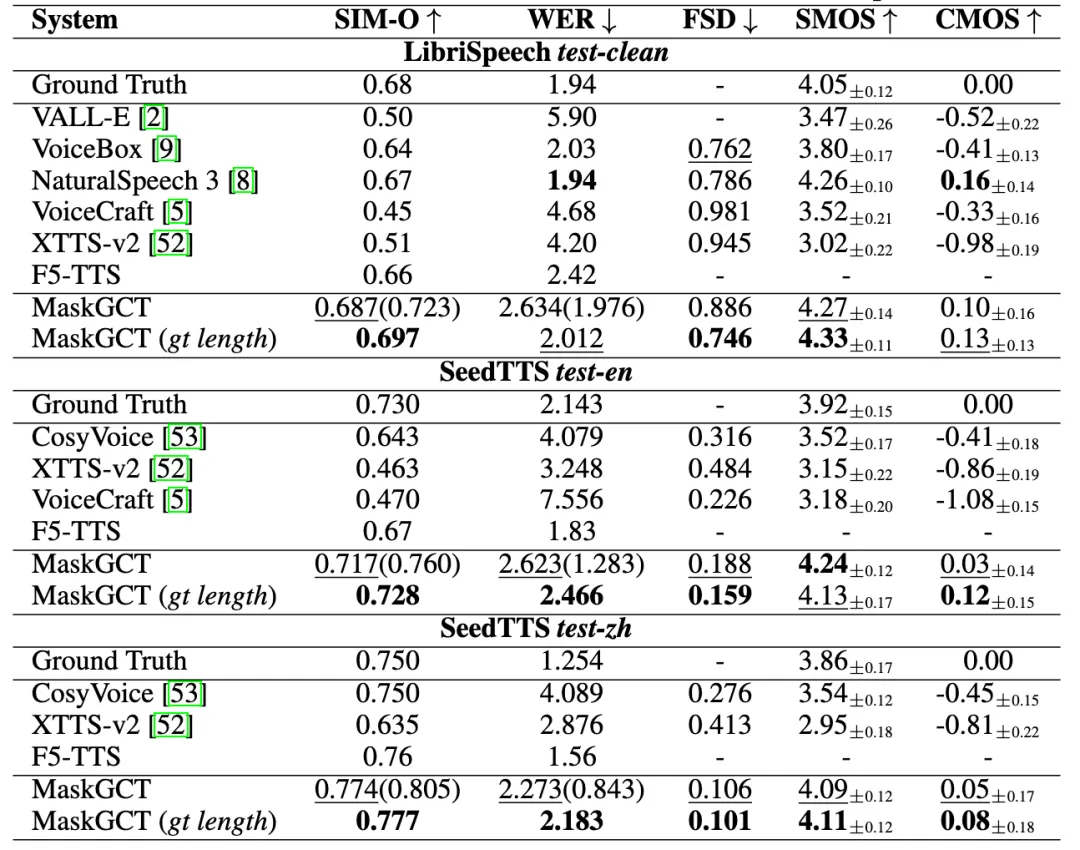
本文介绍了一种名为Masked Generative Codec Transformer(MaskGCT)的全非自回归TTS模型,该模型消除了文本与语音监督之间的显式对齐需求,以及音素级持续时间预测。MaskGCT是一个两阶段模型:在第一阶段,模型使用文本预测从语音自监督学习(SSL)模型中提取的语义标记;在第二阶段,模型基于这些语义标记预测声学标记。MaskGCT遵循掩码预测学习范式。在训练过程中,MaskGCT学习根据给定的条件和提示预测掩码的语义或声学标记。在推理过程中,模型以并行方式生成指定长度的标记。通过对10万小时的自然语音进行实验,结果表明MaskGCT在质量、相似度和可理解性等方面是业内领先的零样本TTS系统。
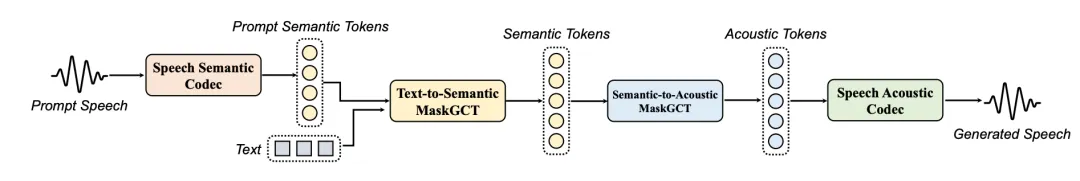
MaskGCT模型由四个主要组件组成:
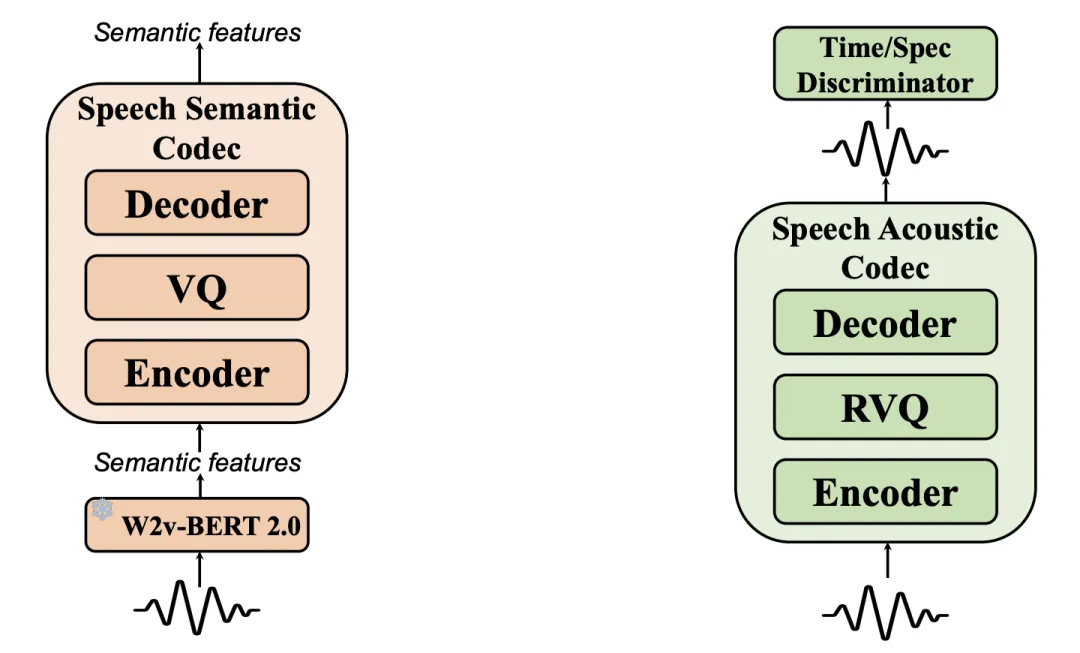
语音语义表示编解码器:将语音转换为语义标记。
语音声学编解码器:从声学标记重建波形。
文本到语义模型:使用文本和提示语义标记预测语义标记。
语义到声学模型:基于语义标记预测声学标记。
语音声学编解码器旨在将语音波形量化为多层离散标记,同时尽可能保留语音的所有信息。本文采用残差向量量化(Residual Vector Quantization, RVQ)方法,将24K采样率的语音波形压缩为12层的离散标记。此外,模型使用Vocos架构作为解码器,以提高训练和推理效率。
语义到声学模型同样采用非自回归掩码生成Transformer,该模型以语义标记为条件,生成多层声学标记序列以重建高质量语音波形。
实验结果
应用场景
总结
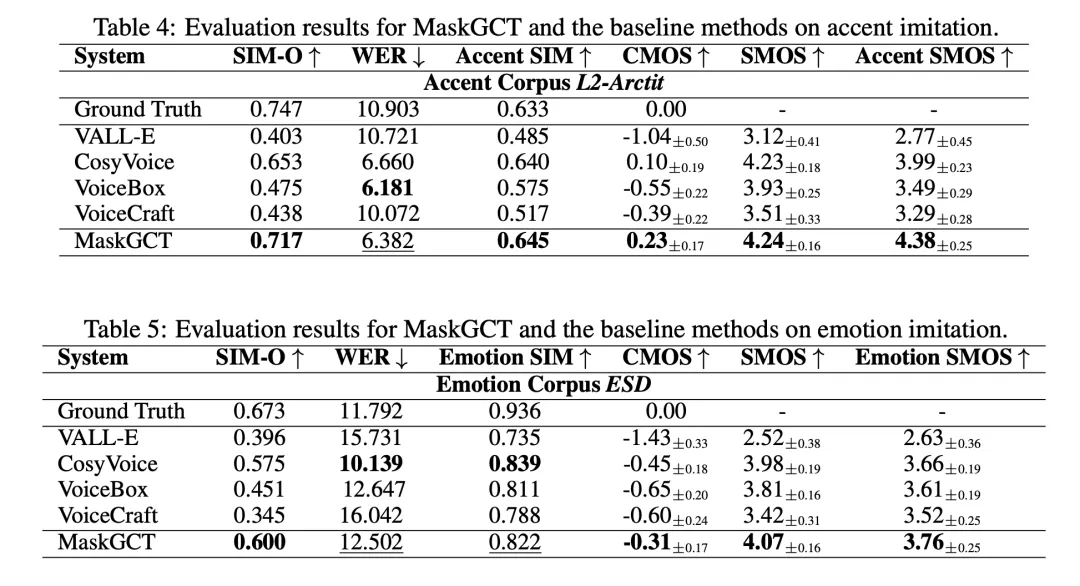
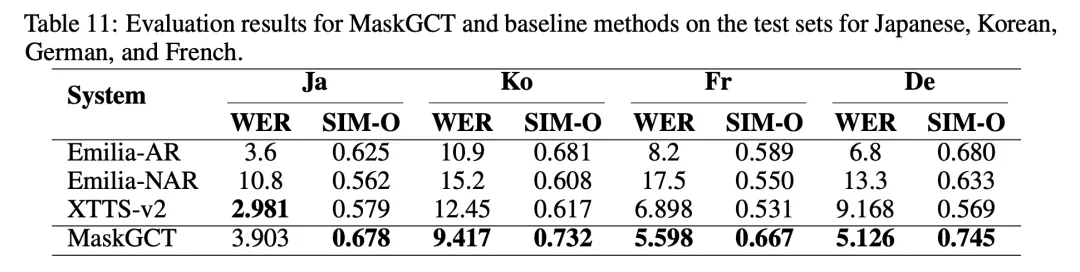
MaskGCT是一个大规模的零样本TTS系统,利用全非自回归掩码生成编解码器Transformer,无需文本与语音的对齐监督和音素级持续时间预测。MaskGCT通过文本预测从语音自监督学习(SSL)模型中提取的语义标记,然后基于这些语义标记预测声学标记,实现了高质量的文本到语音合成。实验表明,MaskGCT在语音质量、相似度和可理解性方面优于最先进的TTS系统,并且在模型规模和训练数据量增加时表现更佳,同时能够控制生成语音的总时长。此外,我们还探索了MaskGCT在语音翻译、语音转换、情感控制和语音内容编辑等任务中的可扩展性,展示了MaskGCT作为语音生成基础模型的潜力。
