
 语音小管家
CTC常用解码方式
CTC常用的解码方式有以下几种:
Greedy Search:贪心搜索,每一帧选择输出最大值,随后对结果进行规整处理。 CTC字符串上的Beam Search:束搜索,在CTC解码中进行Beam Search,输出 n n Prefix Beam Search:前缀束搜索,在规整的字符串上进行Beam Search,在解码过程中直接应用语言模型(First Pass LM)。 FST静态解码:使用有限状态机(FST)进行静态解码,可结合语言模型和词典模型进行解码。
前缀束搜索算法的核心思想是逐步构建可能的前缀序列,并根据概率选择最可能的前缀。其具体的算法步骤:
初始化:算法首先将前一时刻的前缀集
A_ prev 迭代扩展:对于每个时间步(例如语音识别中的每一帧)和当前前缀集
A_ prev ℓ Σ 如果添加的字符是空字符(blank),则不扩展前缀。
如果字符是空格,则会引入语言模型约束,即根据语言模型的概率影响预测。
否则,扩展前缀并结合网络的输出对前缀进行打分。
更新前缀集:所有新的活跃前缀被添加到下一个前缀集
A_ next A_ prev A_ next k 输出结果:最终输出是最可能的1个转录结果(即概率最大的前缀),不过算法也可以很容易地扩展为返回前 n
为了方便理解我们定义
ctc_prefix, 网络输出组成的序列,包含blank和repeat norm_prefix, 对ctc_prefix去除blank和repeat后的序列
在CTC搜索过程中扩展路径有以下几种情况(黑色为ctc_prefix,红色和蓝色为norm_prefix):
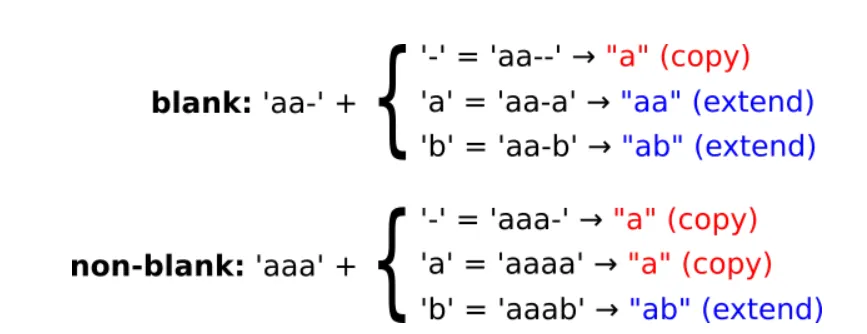
扩展为blank:当路径通过添加blank进行扩展时,前缀保持不变。也就是说,路径没有增加任何新的字符,只是对现有的前缀进行了“延续”,例如:"a" → "a"。
扩展为重复最后一个字符:当路径通过重复最后一个字符进行扩展时,前缀会增加一个相同的字符,形成重复,例如:"a" → "aa"。这是因为norm_prefix 'a'里包含一部分blank结尾的一些ctc_prefix的概率(比如"a-"),所以可以扩展出aa。
扩展为其他字符:当路径通过添加一个不同的字符进行扩展时,前缀会增加一个新字符,例如:"a" → "ab"。
因此前缀束搜索在扩展过程中的每一步,标签序列的概率都会使用两个变量存储,一个负责累加以字符结尾的原生序列概率,另一个负责累加以blank结尾的原生序列概率,两者相互独立,互无交集。增长后,再将这两个概率相加(log_sum_exp)表示这一个标签序列的总概率。然后取top beam_size后再往下增长。
下面以一个例子来模拟上述流程,横轴是时间,纵轴是字典,圆里面的是对数概率:lp=log(softmax(logits)),取beam_size=2,我们定义候选结果格式为:前缀: (后接blank的概率, 后接非blank),当前时刻后接blank的概率和后接非blank的概率记为p_b,p_nb,下一时刻后接blank的概率和后接非blank的概率记为n_p_b,n_p_nb。
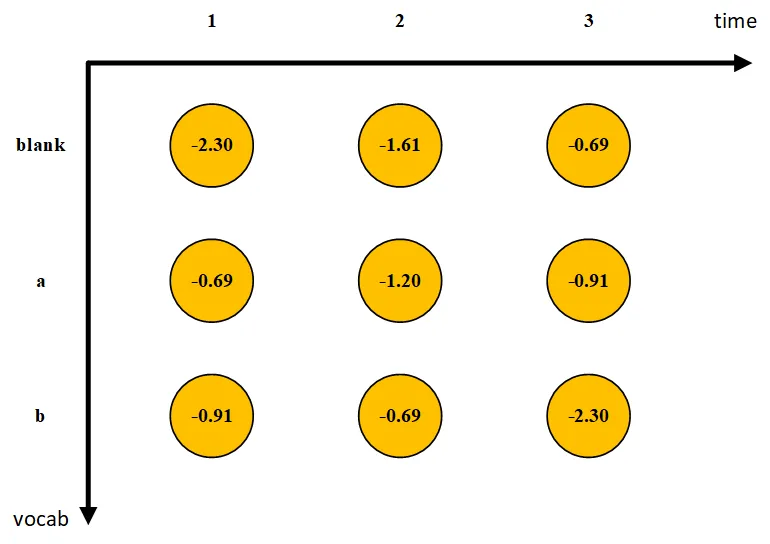
prefix | p_b | p_n_b |
-2.30 | -inf | |
a | -inf | -0.69 |
b | -inf | -0.91 |
此时,前缀束搜索结果为[((a,): (-inf, -0.69)), ((b,): (-inf, -0.91))]。
当t=2,对beam中(a,): (-inf, -0.69)进行路径扩展时,有以下三种情况:
1)当前字符为blank,前缀保持不变,仍为(a,),更新后接blank的概率为
n_p_b = logsumexp(n_p_b, p_b + p, p_nb + p) =
2)当前字符为a,由于当前字符和前缀最后一个字符重复,更新后接非blank的概率,因为CTC算法会合并没有用blank隔开的相同字符,因此这里不用包括前一时刻后接非blank的概率,更新后的后接非blank的概率为n_p_nb = logsumexp(n_p_nb, p_b + p) =
log(softmax([-inf, -inf+(-1.20)])) = -inf
此时前缀为(a,a);如果我们合并当前字符,即前缀变为(a,),那么后接非blank的概率为
n_p_nb = logsumexp(n_p_nb, p_nb + p) =
3)当前字符为b,当前字符和前缀最后一个字符不重复,更新前缀为(a,b,),因为是后接非blank,只需要更新后接非blank的概率
n_p_nb = logsumexp(n_p_nb, p_b + p, p_nb + p) =
prefix | p_b | p_n_b |
a | -2.30 | -1.89 |
b | -2.52 | -1.61 |
aa | -inf | -inf |
ba | -inf | -2.12 |
ab | -inf | -1.39 |
bb | -inf | -inf |
此时,前缀束搜索结果为[((b,): (-2.53, -1.61)), ((a,): (-2.30, -1.90))]。
prefix | p_b | p_n_b |
b | -1.96 | -3.91 |
a | -2.08 | -2.81 |
ba | -inf | -2.19 |
aa | -inf | -3.21 |
bb | -inf | -4.83 |
ab | -inf | -3.69 |
此时,前缀束搜索结果为[((a,): (-2.08, -2.81)), ((b,): (-1.97, -3.91))]。最后需要把,后接blank和后接非blank的概率相加,然后取最大者,因此,最终前缀束搜索结果为a,其得分为-log(softmax(-2.08, -2.81))=1.69。
本文相关代码:
参考文献:
[1]. https://medium.com/corti-ai/ctc-networks-and-language-models-prefix-beam-search-explained-c11d1ee23306
[2]. https://placebokkk.github.io/asr/2020/02/01/asr-ctc-decoder.html
[3]. https://arxiv.org/pdf/1408.2873
