
 语音小管家
模型仓库:https://huggingface.co/Revai
数据训练
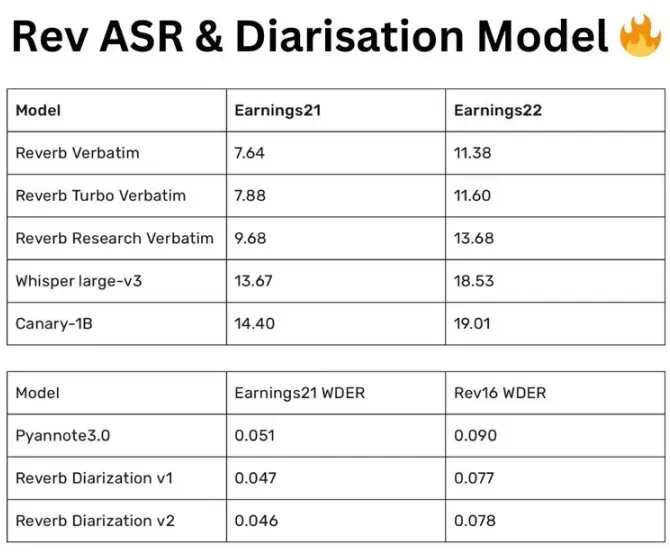
说话人分离模型
Rev团队通过2.6万小时的标注数据,对pyannote模型进行了微调,推出了两个版本的说话人分离模型:
v1版本:基于pyannote3.0架构,经过17轮训练;
v2版本:更先进的版本,用WavLM取代了SincNet特征,实现了更精准的说话人分离。
Reverb ASR模型架构
结构:采用的CTC/注意力混合架构,包含18个conformer层和6个transformer层,总参数量6亿;
语言特定层:用于控制逐字输出,确保转录的准确性和灵活性;
多种解码模式:支持CTC、注意力和联合CTC/注意力解码,适应不同场景需求。
WFST波束搜索:提高解码效率;
Unigram语言模型:优化语言理解;
注意力重新评分:进一步提升准确性
并行处理:确保快速输出;
后处理:生成格式化输出,直接可用于生产环境。
