本文介绍了由腾讯天籁实验室和清华大学合作发表在Interspeech 2024的论文——《Pinyin Regularization in Error Correction for Chinese Speech Recognition with Large Language Models》。
文章首先构建了一个专门针对中文语音识别(ASR)文本纠错的基准数据集ChineseHP,其包含72.4万条纠错数据对,涵盖多种复杂场景和多层次的纠错难度。然后,基于该数据集,使用两种方式(即直接提示问答和有监督微调)对大语言模型(LLM)分别进行了纠错评估。接着,提出了一种用于提示词的拼音正则化方法,通过结合发音信息对LLM的纠错进行适当启发和约束。实验结果表明,拼音正则化有效提升了LLM的纠错性能和稳定性。
论文地址:https://arxiv.org/pdf/2407.01909
ASR纠错领域对英文的研究较为广泛,而针对中文的纠错数据集相对较少。为此,文章构建了一个专门针对中文ASR纠错的基准数据集ChineseHP,其包含72.4万条纠错数据对,涵盖的场景较为全面,从简单到复杂,对应不同层次的纠错难度。该数据集综合考虑了场景的多样性和复杂度,基于多个开源语音数据集,通过开源ASR系统生成识别结果,并与标注结果形成纠错数据对。数据集信息如下: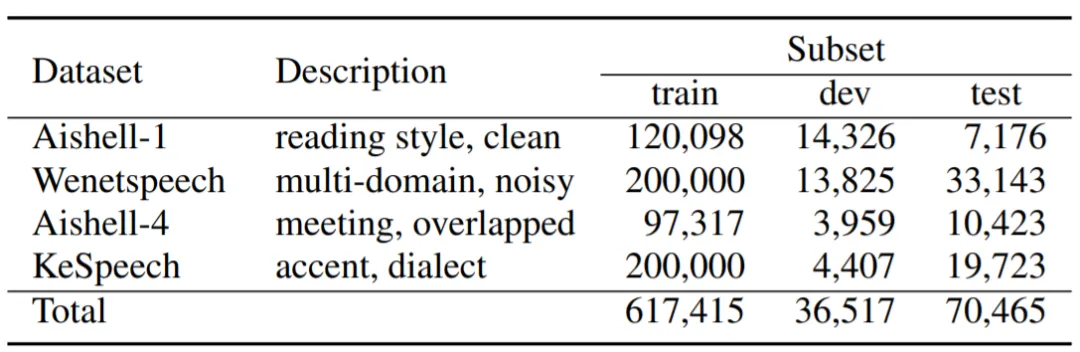
● 规模较大:包含训练集、开发集与测试集,共计72.4万个纠错数据对;● 场景丰富:涵盖多种真实场景,包括标准录制、会议、方言、口音、多领域、噪声环境等;● 挑战性强:纠错难度分布广泛,能有效训练和评估纠错系统,促进纠错算法研究。
一方面,拼音在中文学习和使用中具有重要地位,比如拼音是汉语学习的常规手段、拼音输入法是中文主流输入方式。拼音的广泛应用丰富了LLM的训练语料,使其在预训练时就已充分学习了拼音与汉字间的对应关系。如果在使用 LLM 进行纠错时,激发它的拼音能力则可对纠错产生正向影响。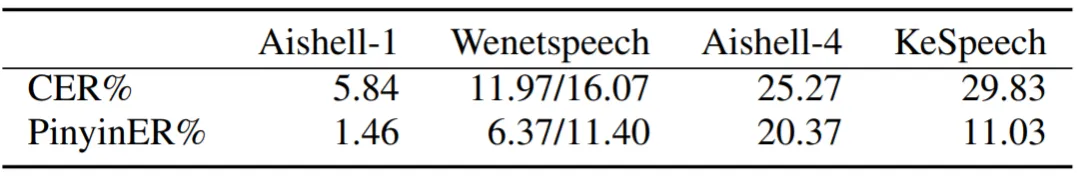
另一方面,上图实验表明,即使拼音是直接从识别文本中转录而来的,拼音的识别正确率仍然远高于汉字,这说明拼音可以作为辅助信息,帮助LLM更好地理解并纠正输入文本中的错误。如下几种典型情况,汉字本身提供的信息较为有限,而拼音可以提供较为明显的关联信息:
● 同音异义字:如“桌”和“捉”都发音为“zhuo1”。● 多音字:如“都”可发音为“dou1”和“du1”。● 头韵:如“桌(zhuo1)”和“助(zhu4)”声母相同。● 韵脚押韵:如“都(dou1)”和“狗(gou3)”韵母相同。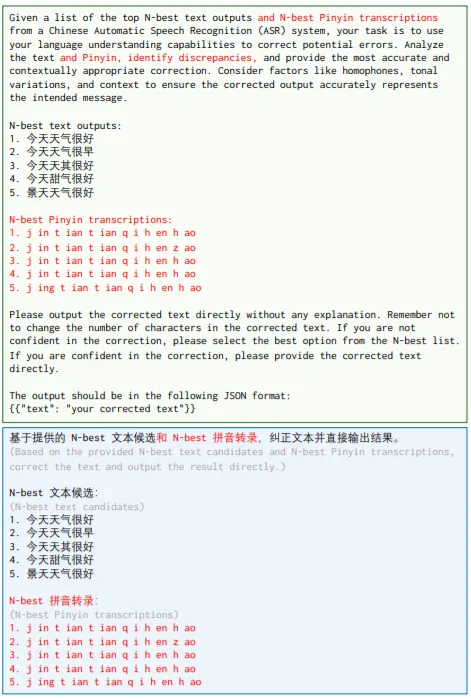
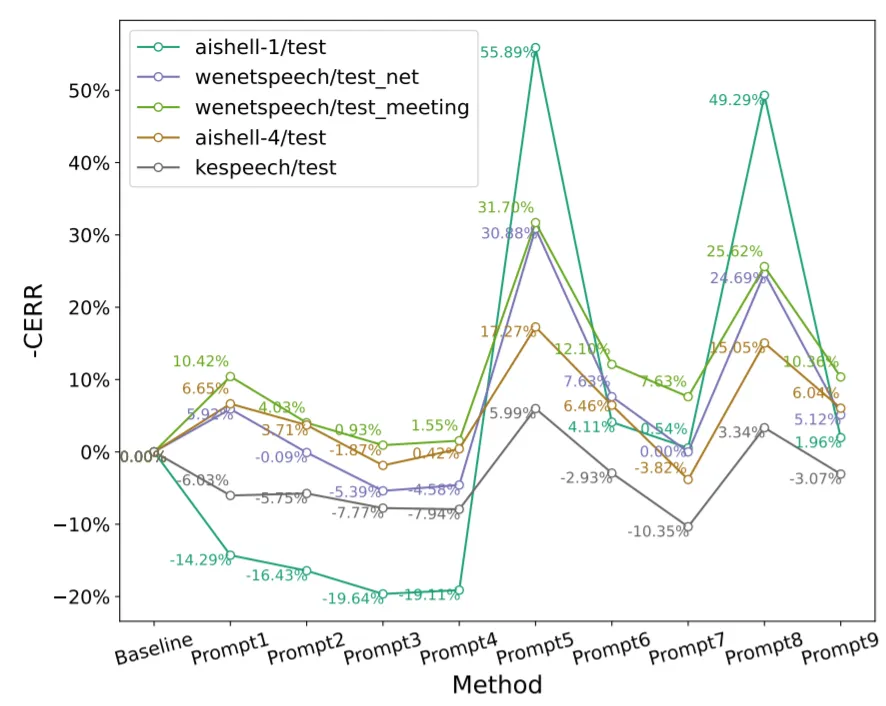
基于拼音在日常使用中的普遍性以及其信息对汉字的互补性,文章提出一种用于提示词的拼音正则化方法,上图示例展示了分别用于ChatGPT的直接提示词(上)和对ChatGLM有监督微调的提示词(下)。首先,基于 ChatGPT(GPT3.5),使用包含拼音正则化的提示词直接对n-best文本进行纠错,上图实验结果表明该方法能有效提升LLM的纠错性能和稳定性,即Prompt2优于Prompt1。在仅使用1-best纠错时,性能提升更为显著,即Prompt6优于Prompt5。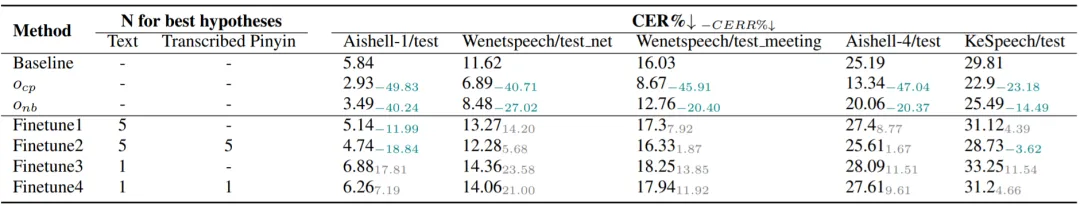
其次,对ChatGLM3-6b进行有监督微调, 上图结果表明拼音正则化能够有效提升有监督微调的纠错性能。在n-best输入情况下,Finetune2优于Finetune1;在1-best输入情况下,Finetune4优于Finetune3。在常规场景下,拼音正则化使纠错性能相对提升可达18.84%;即使在复杂场景下,拼音正则化也能有效避免纠错性能的大幅下降。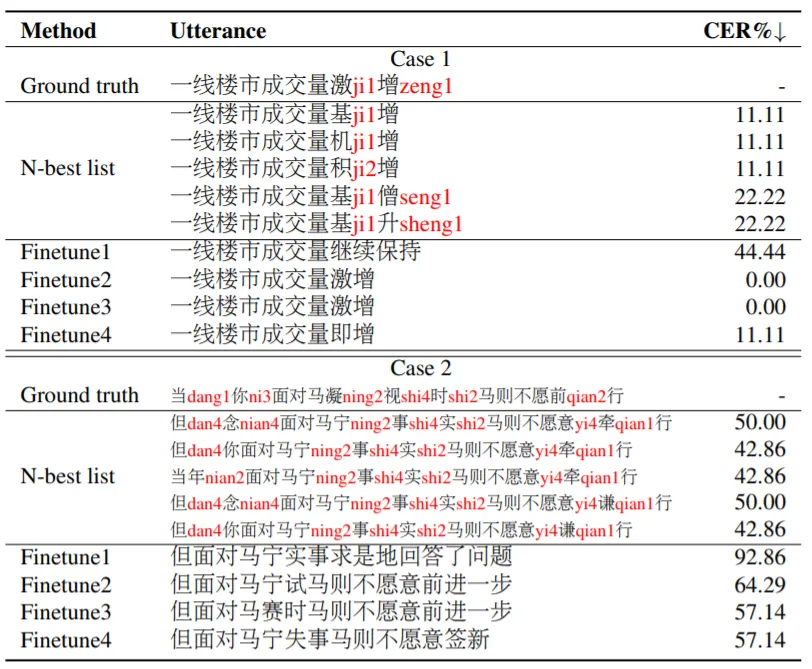
上图展示了两个纠错案例,一个来自标准录制(Aishell-1/test),错误较简单;一个来自口音场景(KeSpeech/test),即使人工纠错也较难完成。可以看到,拼音正则化方法在简单场景下能有效纠错,在复杂场景下也能有效限制幻觉,避免过度纠正。
文章发布了一个针对中文的大规模纠错数据集ChineseHP,具备数据规模大、场景覆盖广的特点,能有效训练和评测纠错系统的性能。此外,提出的拼音正则化方法利用拼音在中文使用环境中的普遍性,有效提升了LLM的纠错性能和稳定性。
 语音小管家