
 语音小管家
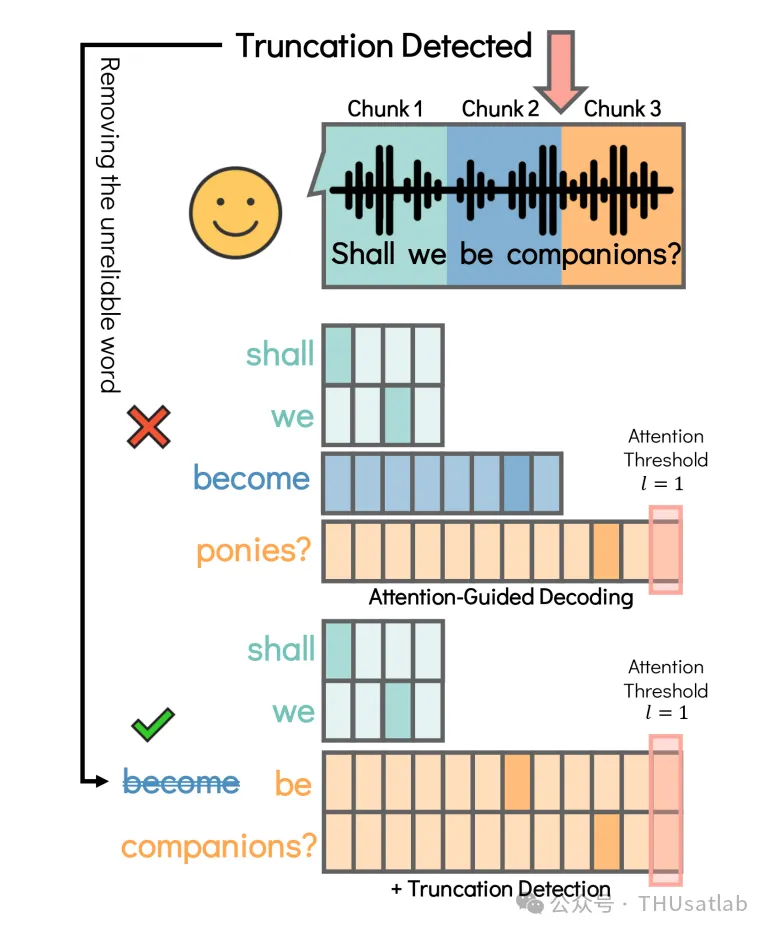
作为一个具有强大鲁棒性的大规模端到端多语言语音识别模型,Whisper在很多低资源和分布外的场景下,不需要经过任何微调就可以表现出不错的识别性能,然而Whisper使用了Transformer架构,编码器-解码器的结构限制了它在流式语音识别中的使用。本文介绍了清华大学语音与音频技术实验室(SATLab)在Interspeech 2024上发表的论文Simul-Whisper: Attention-Guided Streaming Whisper with Truncation Detection。作者利用交叉注意力提供的时间对齐信息来指导自回归解码,在不对预训练模型进行微调的情况下实现了基于块的流式语音识别,并设计了基于IF (Integrate-and-Fire) 的截断检测模块,用于解决语音分块造成的词语分割问题。在多种语言和多个尺寸的Whisper架构下进行的实验表明,该方法明显优于当前最先进的对Whisper流式化改造的基线系统。
01、流式语音识别
02、注意力指导的解码策略
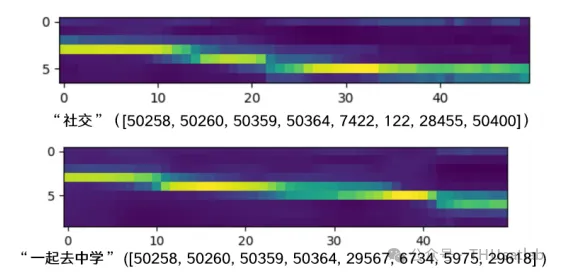
在Whisper的训练过程中,交叉注意力模块的一些注意力头表现出了比较好的时间对齐特性,如下图所示,在注意力矩阵的第t行,其注意力较大值出现的位置与第t个token对应的音频段的位置基本重合,在Whisper中,这些注意力头被挑选出来,称作对齐头(alignment heads)。
在此基础上,我们对Whisper的对齐头进行进一步的后处理,即
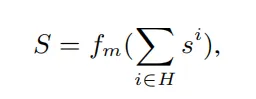
其中H表示所有对齐头的集合,fₘ是一个窗长为7的中值滤波器。
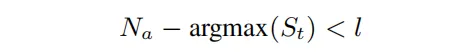
即最后一个token的注意力最大值位置接近当前输入块的末端时(l为预先设定的参数,默认设置为12帧,即240毫秒),认为该token获取的上下文信息不足,很有可能是错误或重复的token,此时将提前停止解码,等待下一次的输入。
03、基于IF的截断检测模块
模型每次推理时接收固定长度的语音片段(比如固定为1s),这些片段可能包含被截断的语音单元,比如包含多个音节的字词被分割到前后两个片段中,进而被识别成两个错误的词,这会影响分割处附近甚至整个句子的识别结果。
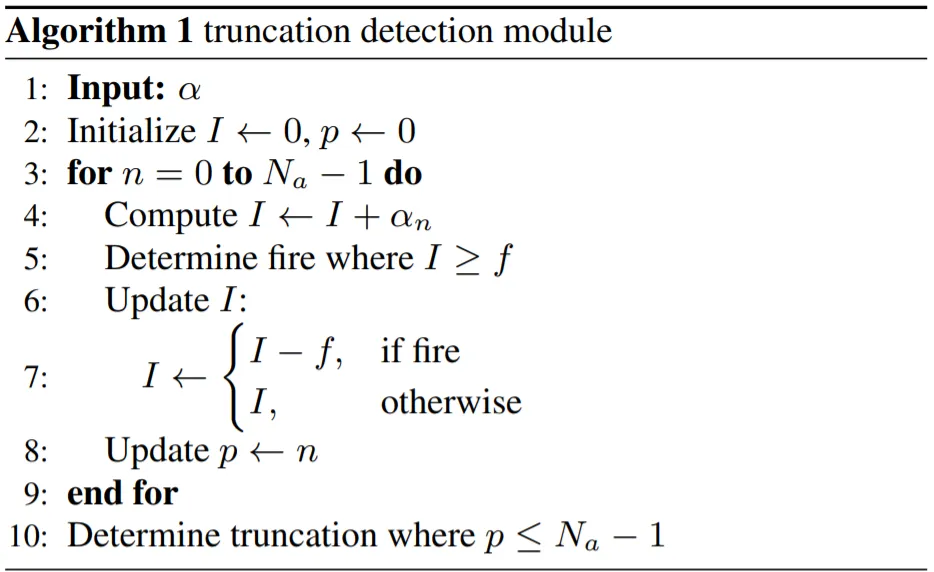
针对这个问题,我们设计了一个基于IF的截断检测模块,如果在识别过程中没有检测到截断现象,那么识别结果将被保留,否则会移除末尾的不可靠结果,等待下一次输入。
具体来说,如下给出的算法所示,该模块对每个输入的音频帧计算一个信号值α并进行累加,当累加值超过一个预先设定的阈值时,会进行一次激发并重置累加值。经过训练之后,该模块在一次输入中激发的次数对应输入音频中的单词数。在截断检测中,我们使用该模块记录最后一次激发的位置,即最后一个词尾的位置,若该位置不在当前输入块的末端,则判定为存在截断现象。
04、实验结果
我们在Librispeech的测试集、评估集和Multilingual Librispeech中包含的7种语言的测试集上对提出的方法进行了实验验证,并与此前采用Local Agreement进行流式解码的基线系统进行了比较,结果如下表所示:
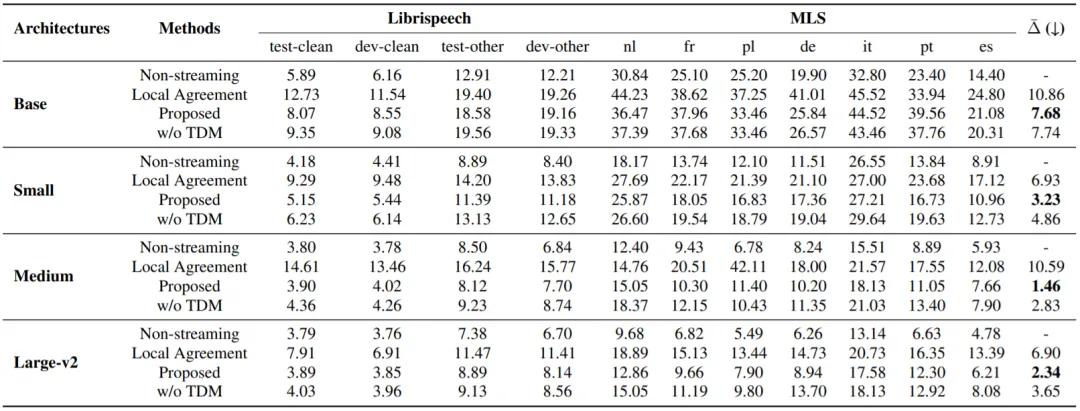
其中Non-streaming表示使用Whisper进行非流式推理,Proposed是我们提出的方法,w/o TDM则是不使用截断检测模块的情形,用于比较说明截断检测模块发挥的作用。
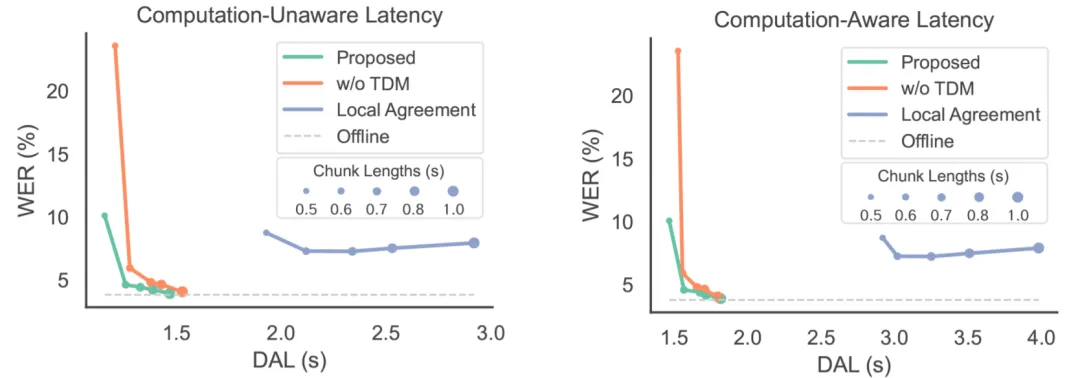
由上表可以看出,我们提出的方法在Medium和Large两种架构下流式化带来的性能损失相比Base和Small更小,这说明流式性能损失可能与初始模型的性能有关,初始模型具有较好的鲁棒性时会更适应短块长、存在随机截断的流式输入场景;从各个数据集上的平均性能损失来看 ,我们提出的方法在各个架构下的平均性能损失都明显小于基线系统;此外,基于IF的截断检测模块几乎在所有的架构和语言上都存在正收益。
05、总结
在本文中,我们介绍了Simul-Whisper,在不对预训练模型进行任何微调的情况下实现了流式语音识别。我们使用交叉注意力提供的时间对齐信息来指导解码过程,并设计了基于IF的截断检测模块来避免块边界处的不可靠识别,在多种语言和多个尺寸的Whisper架构下进行的实验表明,该方法明显优于当前的基线系统。
