论文地址:https://arxiv.org/abs/2407.13292
开源代码:https://github.com/thu-spmi/CAT/tree/master/egs/IuMien
主流的自动语音识别(ASR,automatic speech recognition)技术,通常需要数百到数千小时的带标注语音数据。对于低资源语音识别,基于音素监督预训练、基于子词监督预训练、自监督预训练,是三种常用多语言预训练方法。勉语是中国瑶族的主要民族语言,由于带标注的语音数据非常有限,勉语属于低资源语言。我们在不到10小时的勉语语音标注数据上,研究并比较了这三种方法用于勉语语音识别的效果。我们的实验基于最近发布的三种预训练模型,这些模型是在CommonVoice数据集的10种语言(CV-Lang10),共计4096小时上预训练的,分别对应于低资源ASR的三种方法[1]。研究发现,音素监督取得了比子词监督和自监督更好的性能,表现出数据高效性。Whistle(weakly-supervised phoneme-based multilingual pre-training)模型,即通过弱监督的基于音素的多语言预训练获得的模型,在测试集上取得了最好的结果。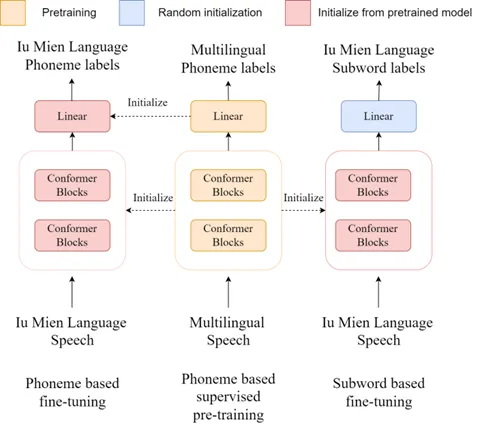
Whistle模型[1]是近期开源的与Whisper类似的采用弱监督方式训练得到的ASR基座模型。但不同于Whisper[2]采用基于子词(subword based)弱监督,Whistle采用基于音素(phoneme based)弱监督—使用含有少量噪声的音素标注数据进行有监督训练。子词是语言文本的记录符号,而音素则是记录了语言的发音,更适合于作为语音建模单元。通过实验比较发现,Whistle模型能更高效的学习各语言之间共享的语音特征,更适合于跨语言ASR,并且该模型具有数据高效性,在训练数据受限的情况下,相比其他预训练方法往往能取得更好的效果。因此,本文[3]研究了将Whistle模型,应用到少数民族语音语音识别中来,并与其他预训练模型进行比较。在本文中[3],我们使用不到10小时的勉语语音标注数据,来研究比较不同预训练方法用于勉语语音识别的效果。如图1所示,我们构建了基于CTC架构的语音识别模型,并使用多国预训练的Whistle模型初始化声学编码器。在声学编码器之上,添加了一个线性层,用于将编码器输出的特征向量映射到目标预测空间中。对于基于音素建模的语音识别模型,因为其预测目标音素集和预训练时预测目标音素集可能存在部分重合,在微调时,我们可使用预训练时的线性层中的部分参数来初始化微调时的线性层。对于基于子词建模的语音识别模型,我们随机初始化微调时的线性层。
勉语是瑶族瑶语的一个主要分支,其书写文字勉文现在被用来作为瑶语的标准书写文字。当前所使用的勉文书写方案,是在1984年由中国和美国相关学者所制订的一套标准勉文书写方案。标准勉文使用26个基本拉丁字母来组成不同的单词,同时每一个基本勉文书写单位都对应一种基本发音,因此勉文可以直接根据其书写进行准确的拼读,因此可以说,勉文是一种既表音也表意的文字。如表1,勉文的单词书写,按其拼读规则划分,可以分为一个或多个音节,每一个音节可以分为声母和韵母两部分,其中韵母又可以细分为韵头韵腹韵尾。勉语单词的最后一位字母一般用来表示声调,勉语共8个声调,现在用5个字母来区分表示(分别是h、v、z、x、v),塞音韵尾只能配合两个入声调,其他韵尾只能配合舒声调。如果单词末尾没有音调表示字母,则该单词为勉语中的一声,阴平声调。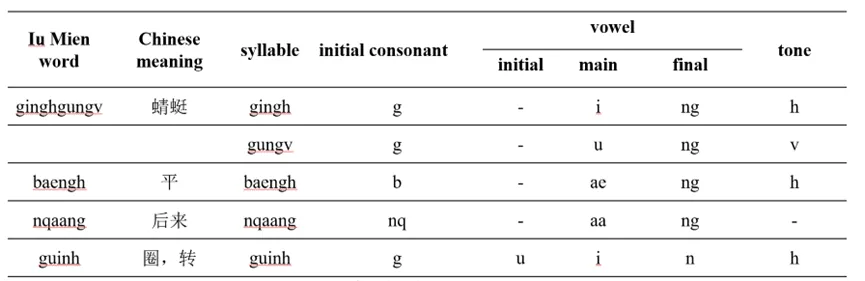
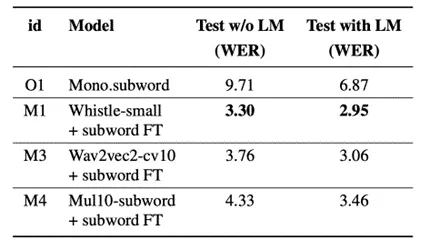
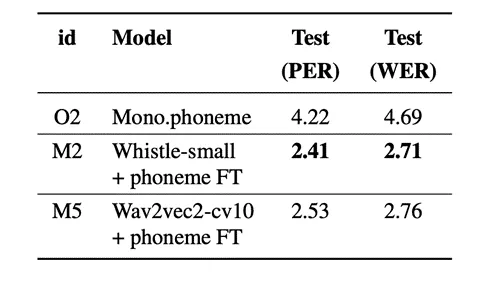
我们利用CAT工具包[A],基于Whislte中开源的一系列模型[B],在不到10小时的勉语转录数据上[C],研究并比较了基于音素预训练、基于子词预训练、自监督预训练这三种方法用于勉语语音识别的效果。如表2和表3所示,在同等模型规模(90M)条件下,无论是基于子词建模的勉语语音识别模型,还是基于音素建模的勉语语音识别模型,在Whistle预训练模型的基础上进行微调的方法,都取得了相比于其他预训练方法更好的识别准确率。
我们主要研究和比较了使用不同预训练方法和少量勉语数据进行勉语语音识别模型微调的效果。得益于不同语言之间存在许多共有的基本发音,基于音素预训练的Whistle模型表现出优秀的跨语言迁移能力和数据高效性,实验测试也证明该模型可以显著提升勉语语音识别模型的准确率,效果优于其他预训练方法。未来的工作,可以结合勉语等少数民族语言的特色,即丰富的音调,进一步改进Whistle模型的预训练方法,使得Whistle模型能够在勉语等带调语言上取得更好的效果。
[1] S. Yusuyin, T. Ma, H. Huang, W. Zhao, and Z. Ou, “Whistle: Data-efficient multilingual and crosslingual speech recognition via weakly phonetic supervision”, arXiv preprint arXiv:2406.02166, 2024.
[2] A. Radford, J. W. Kim, T. Xu, G. Brockman, C. McLeavey, and I. Sutskever, “Robust speech recognition via large-scale weak supervision”, International Conference on Machine Learning (ICML), 2023.
[3] L. Dong, D. Qin, F. Bai, F. Song, Y. Liu, C. Xu, and Z. Ou, “Low-resourced speech recognition for iu mien language via weakly-supervised phoneme-based multilingual pre-training”, arXiv preprint arXiv:2407.13292, 2024.

 语音小管家