语音小管家
Advanced Long-Content Speech Recognition with Factorized Neural Transducer
作者列表:龚勋,吴俣,李锦宇,刘树杰,赵蕤,陈谐,钱彦旻
合作单位:微软
背景动机
近年来,利用历史信息的语音识别(ASR)技术受到了越来越多的关注,因为它能够在解码当前语句时捕捉到连续历史语句之间的关系。然而,传统的端到端(E2E)自动语音识别模型通常在没有考虑句子间相关性的情况下单独训练模型,导致在实际应用场景如对话和会议中,识别精度存在提升空间。这些场景中的语音通常以历史内容形式出现,这种富含上下文的信息能够比单独的短句更好地提升识别精度。 本研究提出了两种新方法,将历史内容信息集成到基于因子分解的神经网络Transducer(Factorized Neural Transducer, FNT)架构中,分别用于非流式(称为LongFNT)和流式(称为SLongFNT)场景中。我们首先探讨了历史内容转录是否能够提升传统的转导器模型(C-T)性能,实验结果显示由于C-T模型的预测网络未能完全作为语言模型,使用历史内容转录并未显著改善性能。相反,FNT显示了其利用历史内容信息的潜力,因此我们提出了LongFNT模型,分别探索了在文本(LongFNT-Text)和语音(LongFNT-Speech)中历史内容信息的影响。这两种方法相互补充,以实现更好的性能,此外,我们将LongFNT模型扩展到流式场景,命名为SLongFNT,通过使用历史内容文本和语音信息来改进流式ASR系统。总体而言,我们提出的LongFNT和SLongFNT模型强调了在改进非流式和流式语音识别系统时,考虑历史内容语音和转录文本的重要性。
首先,我们给出一个样例用于直观理解使用历史信息对当前ASR系统带来的改善. 图1,图2说明了LongFNT如何利用历史内容的文本部分信息来纠正普通FNT的结果。在图1中,使用真实转录作为历史时,LongFNT成功利用了历史词“WADIAK”,并进行了适当的修改。然而,当使用假设转录作为历史(即“WADIAC”)时,由于错误解码,LongFNT使用了错误的历史信息,无法纠正“WADIAC”的错误。在图2,3中,当假设历史是正确时,LongFNT也能够利用历史词并成功进行修改。
同时,我们通过分析模型中的注意力分数,可以看出底层注意力表现出基于列的模式,表明无论输入位置如何,历史内容文本中的特定输入都起到了关键作用。此外,相比于历史语句p−1,历史语句p−2的注意力得分较小。顶层注意力更关注于连接历史中出现的关键词并纠正当前词“WADIAK”,这与表VII中的示例相对应。这些结果表明,提出的历史内容注意力机制可以有效地捕捉长程上下文,从而提高系统性能。
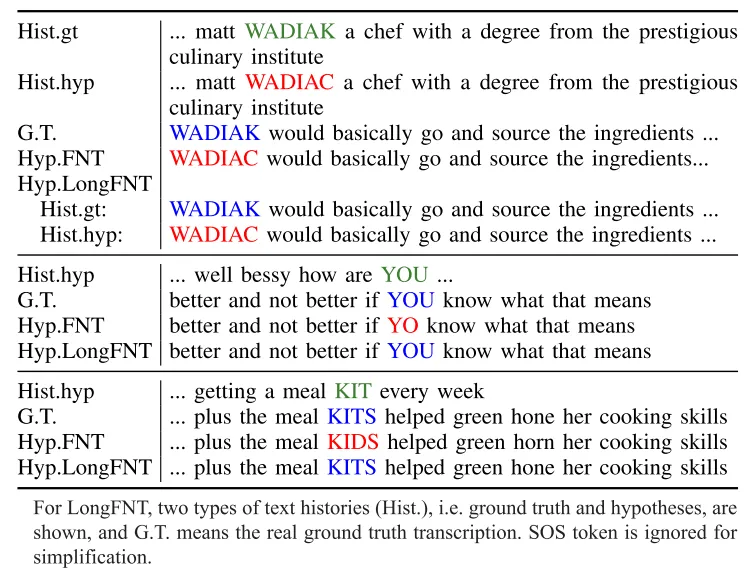
图1:样例
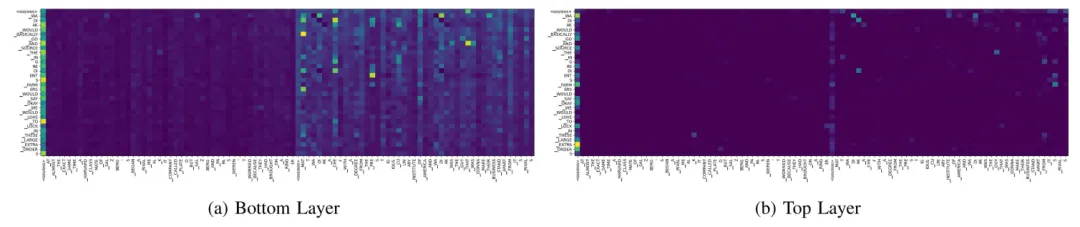
图2:样例的Attention Score
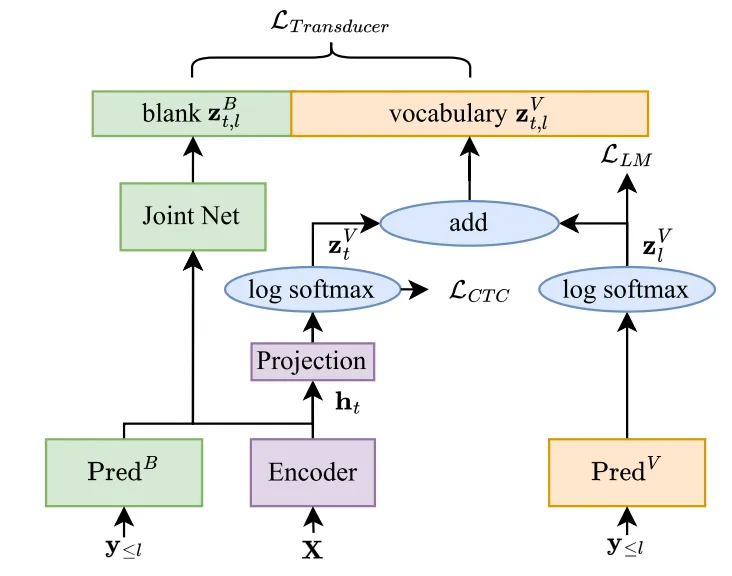
图3:标准FNT结构
图3是一个常规的FNT结构。首先,从声学编码器Encoder中,我们获得 用于计算 CTC 损失,并且因为 CTC 需要一个额外的blank符号,因此 长度为 U+1。其中值得注意的是CTC 中的空白符(ψ)与 RNN-T 中的空白符(ϕ)不同。对于RNNT的损失,我们将声学编码器的输出和语言模型部分的输出加起来,即得到词汇表对应的输出,再加上额外的对应的输出。
最终,我们可以计算RNNT的后验概率:
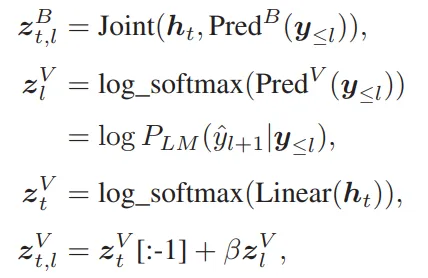
方案
相关工作:
首先,从声学编码器Encoder中,我们获得 用于计算 CTC 损失,并且因为 CTC 需要一个额外的blank符号,因此 长度为 U+1。其中值得注意的是CTC 中的空白符(ψ)与 RNN-T 中的空白符(ϕ)不同。对于RNNT的损失,我们将声学编码器的输出和语言模型部分的输出加起来,即得到词汇表对应的输出,再加上额外的对应的输出。
最终,我们可以计算RNNT的后验概率:
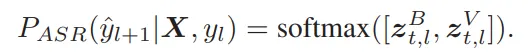
非流式场景:LongFNT:
基于上述的FNT架构,我们首先针对离线模型提出了LongFNT-Text(作用于文本部分)和LongFNT-Speech(作用于语音部分),如图4所示。在文本部分的LongFNT-Text,我们首先使用context encoder将历史标签序列编码为Embed Sequence:, 随后,使用Token-level和Sentence-level的两种融合方式,将历史信息以不同维度融入部分。
在语音部分的LongFNT-Speech,我们扩增了Encoder的感受野,让声学部分的编码器能够看到更多的历史信息。
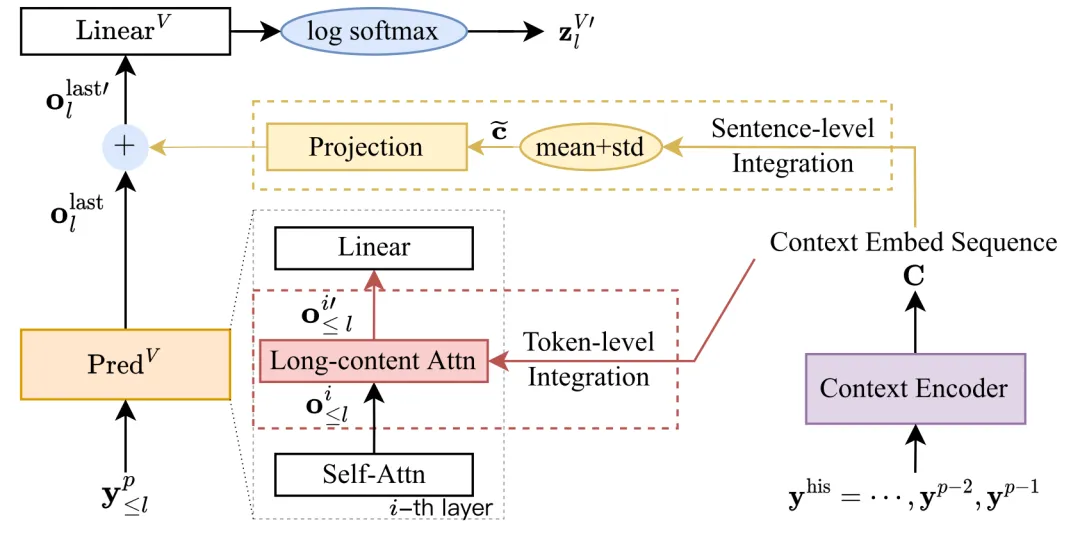
图4:LongFNT
流式场景:SLongFNT:
在流式识别的FNT结构中,我们对于实时性有了更高的要求。进而我们针对上述离线结构进行了改进,类似的也分为了SLongFNT-Text和SLongFNT-Speech部分。
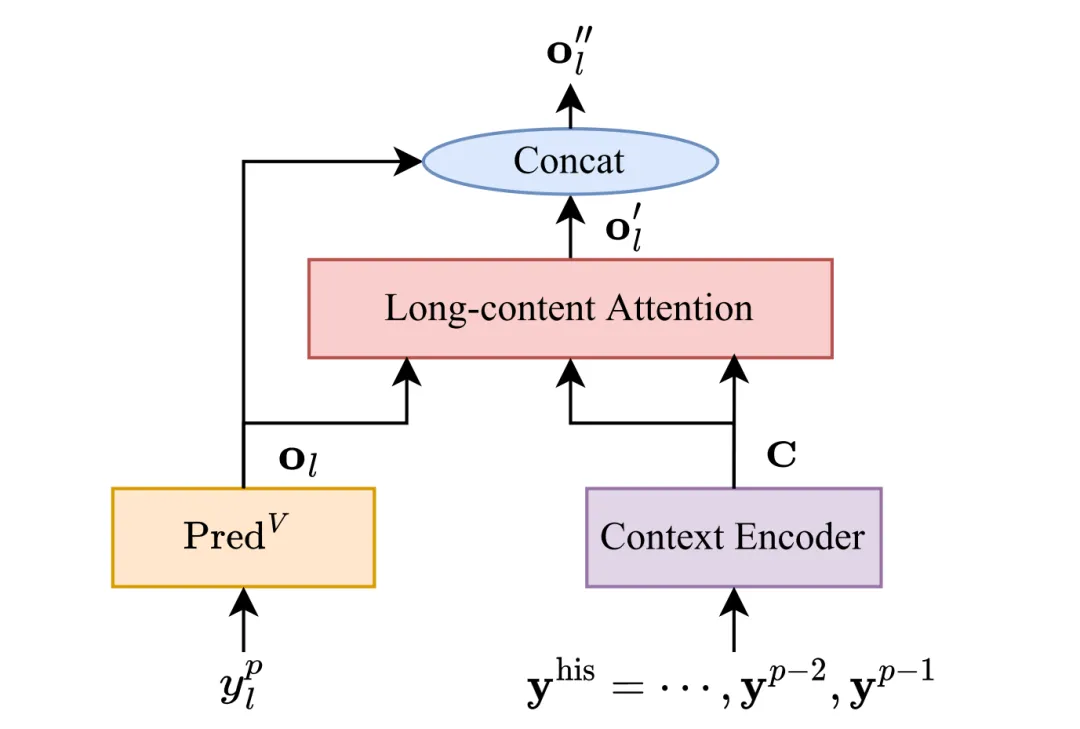
图5:SLongFNT-Text
如图5所示,在SLongFNT-Text中,我们改进了前文的Token-level Integration的方法,将其从简单的全连接操作改为了基于内容的Attention,其中,query变为的输出,key和value则是context-encoder的输出。
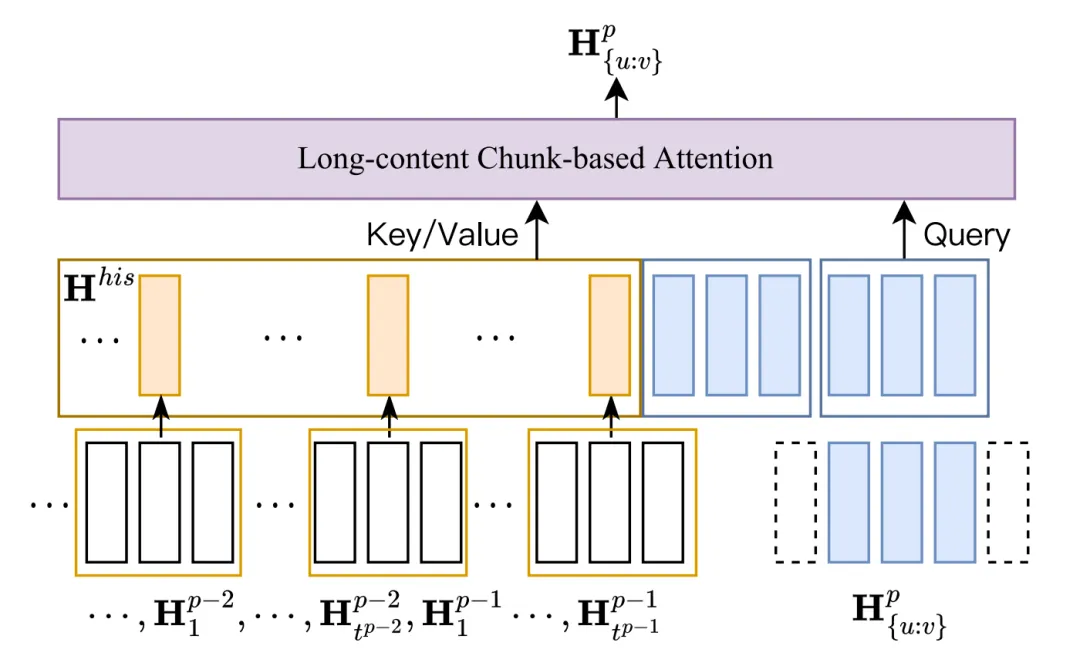
图6:SLongFNT-Speech
如图6所示,对于SLongFNT-Speech,我们采用分组压缩的方式,对历史的语音片段的高维特征进行K倍压缩,进而大大减小了计算量。
实验
1. 数据集构建
在实验部分,我们分别采用了LibriSpeech和GigaSpeech-M(1000h)这两个中等规模的数据集,根据数据集内部的语音连续性,我们将原有的句子级别的语音-文本对扩展为包含多句历史的数据。具体信息量如图7:
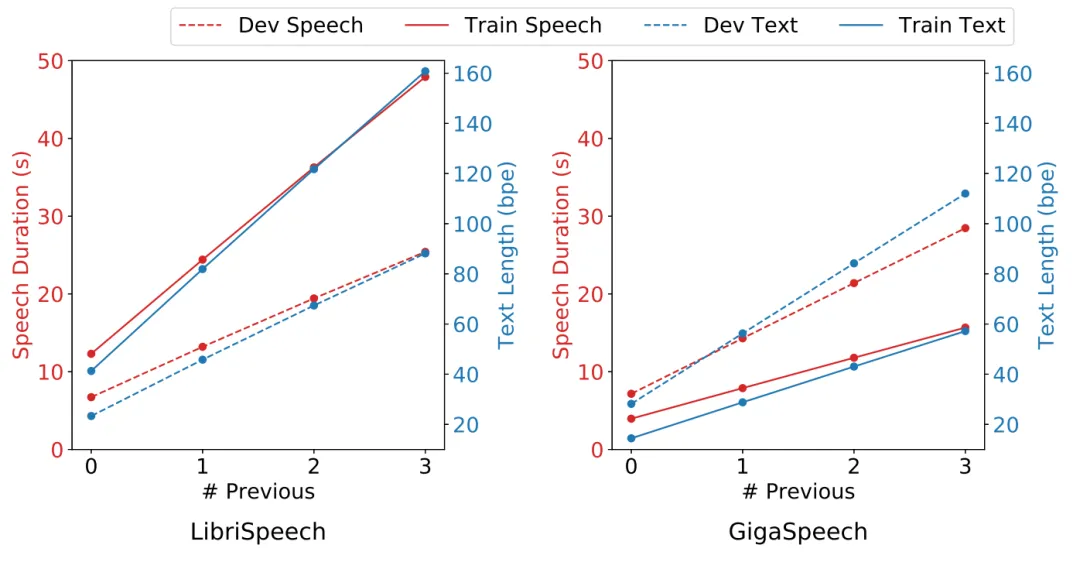
图7:数据集分布
2. 非流式场景下的长时历史增强实验
在初步实验中,我们研究了通过引入历史内容转录历史(“+ long text”)是否能提升传统C-T模型的性能。表1的第一部分显示,使用扩展的历史内容文本或语句级集成时,即使使用oracle转录,传统C-T模型的性能提升也非常有限。此外,当引入假设转录时,系统性能实际上下降了。这一结果可以归因于传统神经转导器模型中的预测网络不是纯粹的语言模型,无法轻松利用较长的历史来实现性能提升。
随后对新提出的LongFNT模型进行了评估,结果显示在表1的最后一部分。与之前的C-T和FNT系统相比,使用历史内容信息的所有新模型都显著改善了性能,这表明新模型更好地利用了历史内容历史信息。相比于“FNT + long speech”,LongFNT-Speech表现更优,这种提升归因于我们限制了梯度回传的策略。为了进一步验证LongFNT-Text的效果,我们复现了跨语句的Transformer语言模型(LM)。然而,需要注意的是,这些方法与LongFNT-Text并不完全相同。主要区别在于它们依赖浅融合,而LongFNT-Text独立于这种融合机制。表1显示,跨语句LM融合(hyp)相对于传统融合和基线有改善。而LongFNT-Text在GigaSpeech上的表现优于跨语句LM融合,可能由于其增强的鲁棒性。此外,当LongFNT-Text与浅融合结合使用时,其性能显著超过“+跨语句LM融合(hyp)”。这种协同效应有效捕捉了历史内容文本信息。同时,文本和语音两种历史信息都对历史内容语音识别有帮助,且LongFNT-Text略优于LongFNT-Speech。最终,结合文本和语音历史知识的LongFNT模型实现了最佳系统性能,与C-T和FNT中单纯使用长文本的有限提升相比,新提出的LongFNT在LibriSpeech和GigaSpeech上分别实现了约20%和10%的相对WER降低。
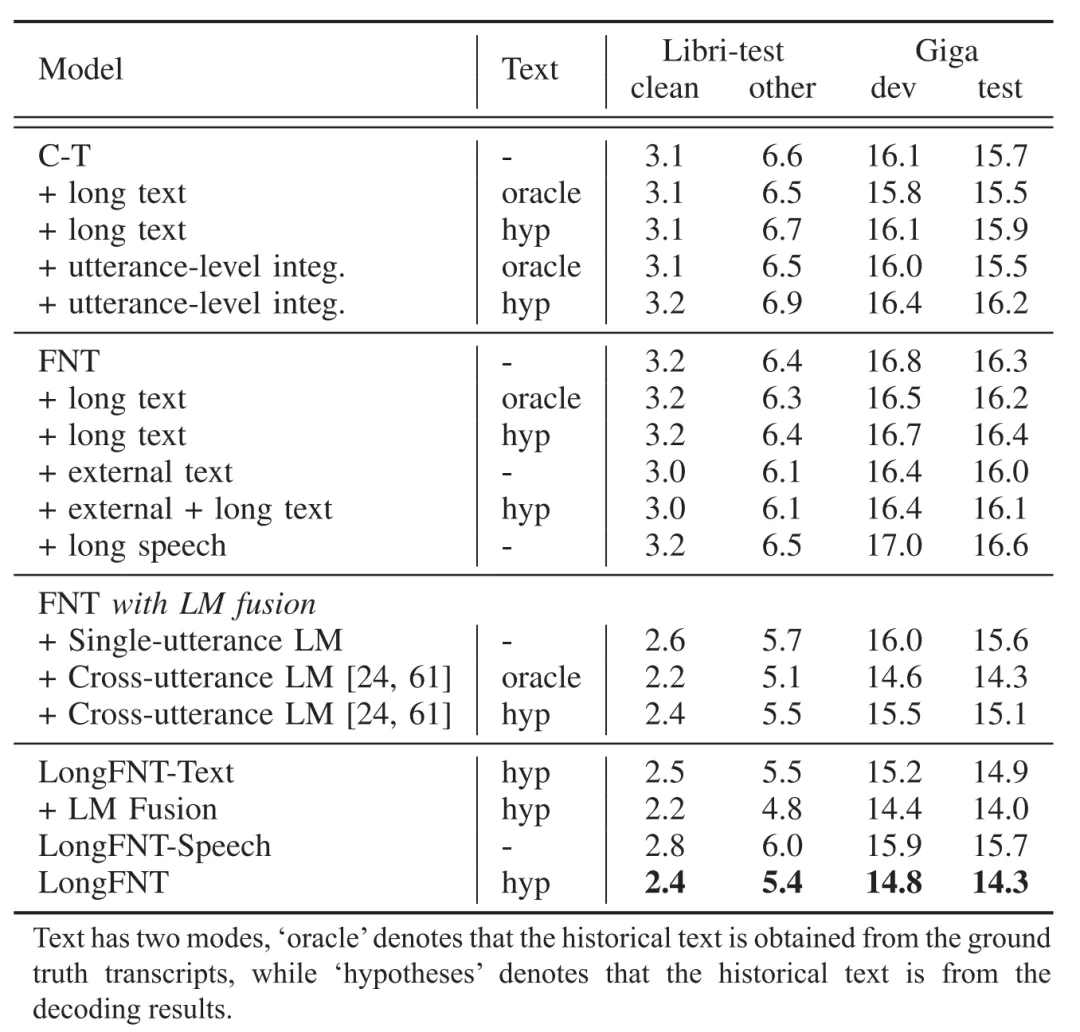
表1:非流式识别结果
此外,我们针对不同超参数进行了消融实验的研究。
关于历史信息数量的结果如表II所示。如表2所示,我们观察到历史语句数量与识别错误率(WER)之间的相关性,随着Nhis增加,当前语句的WER逐渐降低,但是在Nhis>2后,改进效果有限,但训练资源消耗很大。因此,使用前两个历史语句是LongFNT在准确性和成本之间的最佳平衡点。
关于LongFNT-Text的不同的融合方式,我们在表3进行了分析,结果表明Token-level的性能提升优于Sentence-level,并且使用RoBERTa作为信息提取器的性能更加的好。
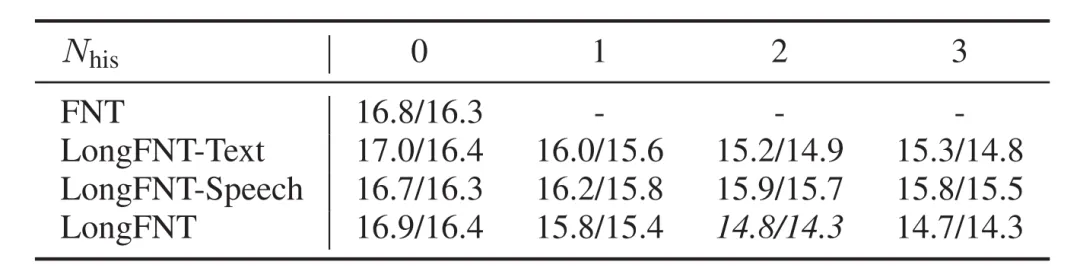
表2:历史数量分析
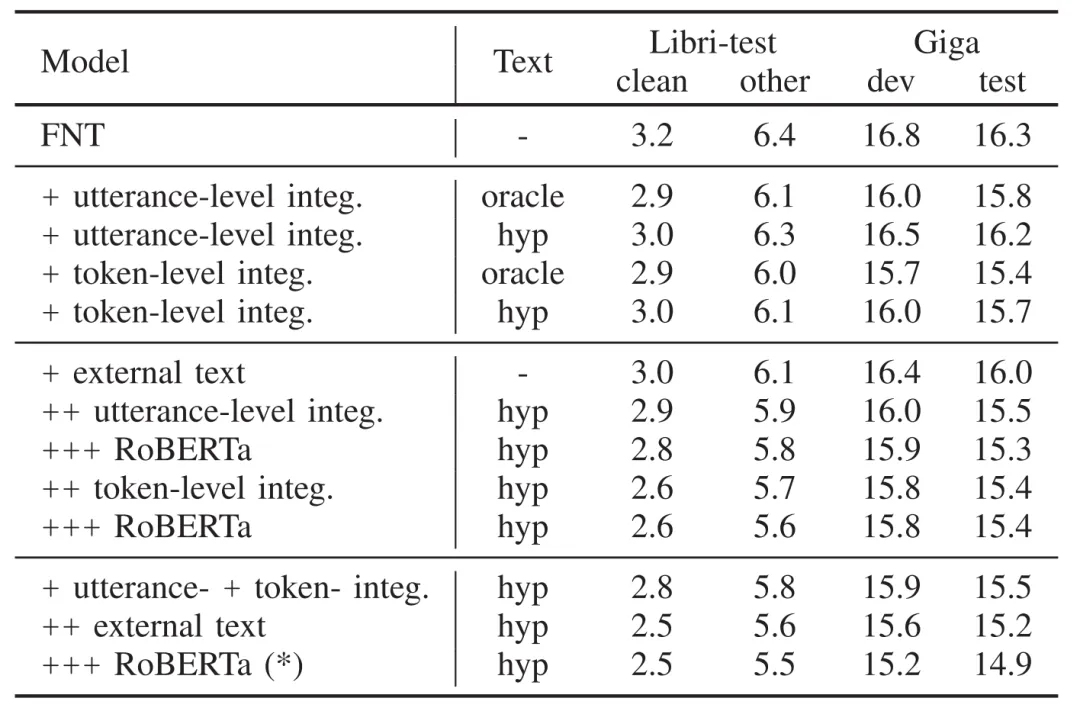
表3:LongFNT的消融实验
3. 流式场景下的历史信息增强实验
表4展示了在流式场景中的性能比较,我们首先基于历史内容文本对原始FNT模型的影响设定了基准,与表1中的非流式FNT模型相比,基本流式FNT(SFNT)有明显的性能下降。借助外部文本,无论是否有历史内容文本,流式FNT模型都得到了持续改进,尽管改进相对较小。表4的第二部分展示了我们提出的SLongFNT模型的单独性能。对于历史内容转录的利用,即SLongFNT-Text,在LibriSpeech/GigaSpeech上分别实现了11%和8%的相对WER降低,这与非流式LongFNT-Text的改进相当。对于历史内容语音的利用,即SLongFNT-Speech,降采样率设定为K=4,以平衡推理速度和准确性,在LibriSpeech/GigaSpeech上分别观察到了15%和14%的相对WER降低。发现SLongFNT-Speech的改进比LongFNT-Speech更大,这可能是因为在流式条件下语音编码器的重要性更大。最后,结合文本和语音历史知识的SLongFNT系统相比基线流式FNT系统,在LibriSpeech上实现了约25%的相对WER降低,在GigaSpeech上实现了约17%的相对WER降低。
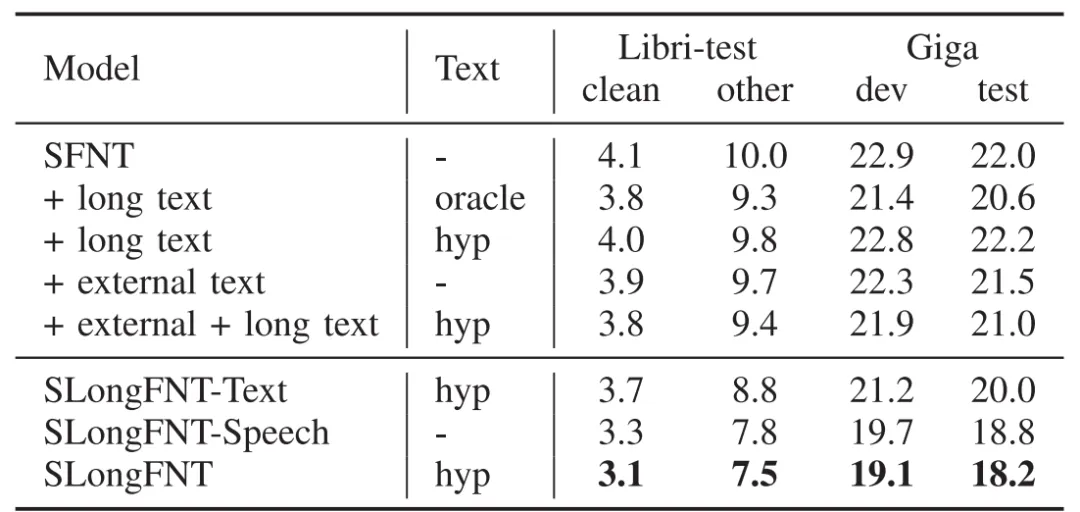
表4:流式场景SLongFNT性能
类似的,我们针对SLongFNT-Text和SLongFNT-Speech做了如表5的消融实验用以研究最佳的网络结构,具体内容可以在论文中看到。
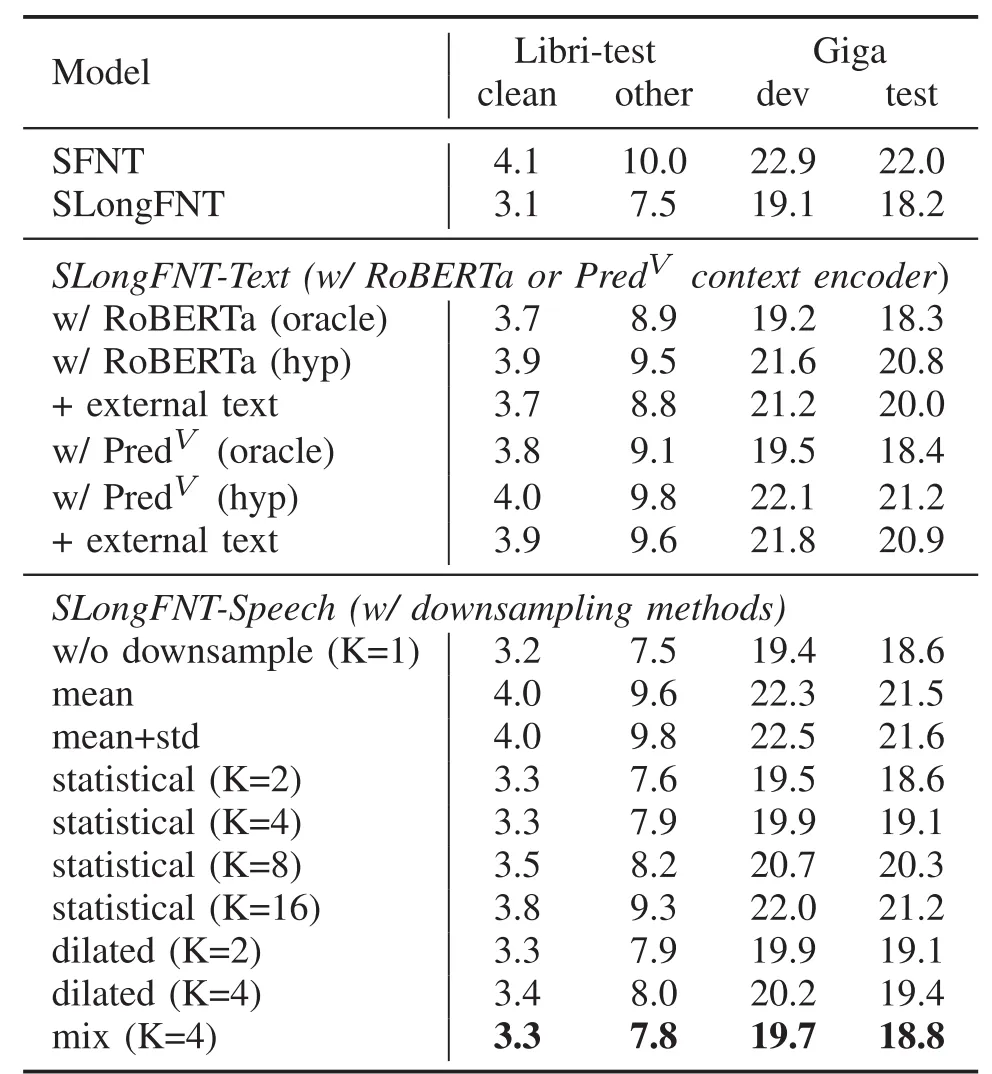
表5:SLongFNT消融实验
最后,在流式识别模型中,一个更重要的是对于识别延迟不能大幅增长。图8中展示了我们对提出的SLongFNT系统在不同历史语句数量(Nhis = 0, 1, 2, 3)和不同降采样率(K = 1, 2, 4, 8, 16, ∞,其中 ∞ 表示均值池化)下的端到端延迟进行了评估。结果表明,随着词错误率(WER)的降低,延迟增加。我们可以通过选择Nhis=2和K=4来平衡延迟和模型准确性(WER),这种设置下的延迟为545毫秒。在此设置下,SLongFNT-Text的延迟记录为473毫秒,而SLongFNT-Speech的延迟约为497毫秒。
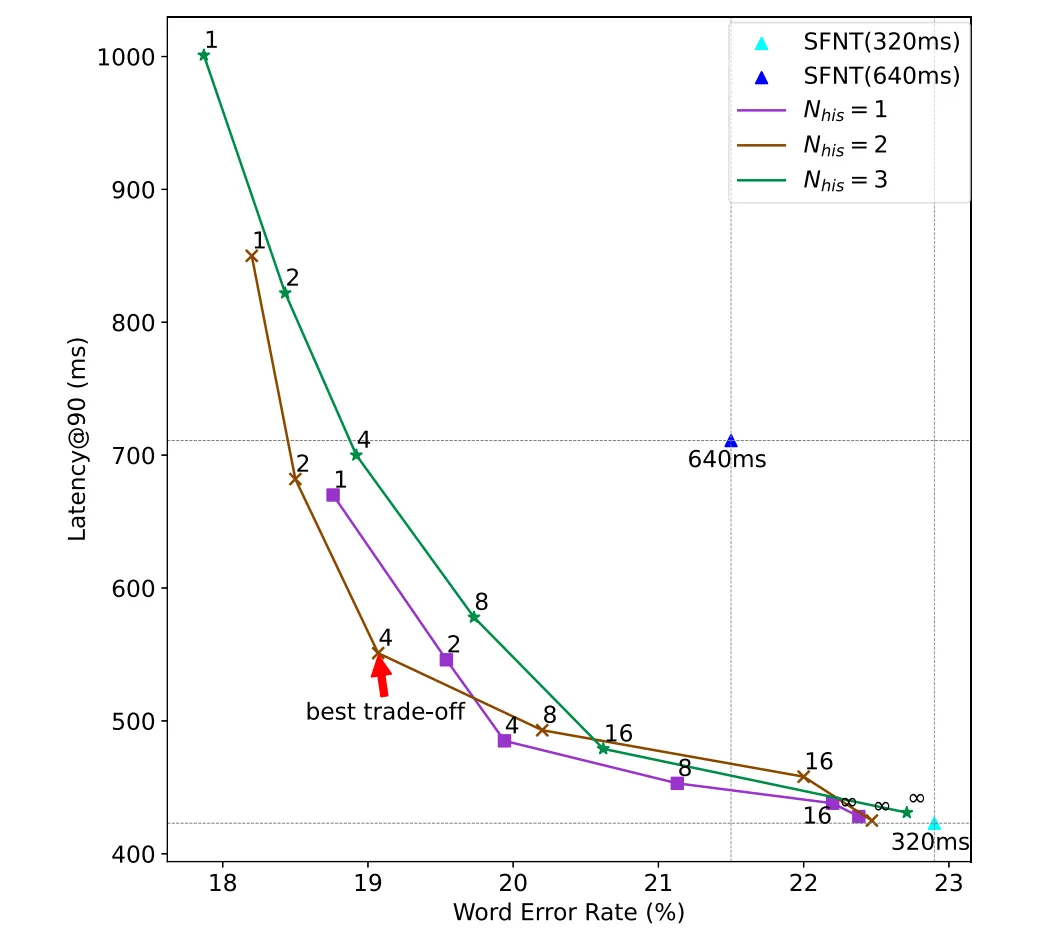
图8:SLongFNT性能曲线
总结
在本文中,我们介绍了两种新方法:LongFNT和SLongFNT,它们将历史内容信息集成到FNT架构中,并在非流式和流式语音识别场景中取得了显著改进。首先,我们研究了将历史内容历史引入到Conformer转导器模型中的有效性,发现改进甚微。随后,我们基于FNT进行了实验,探索了一种有效利用历史内容历史的网络。我们提出了LongFNT,使用两种集成方法来利用历史内容文本(LongFNT-Text)和历史内容语音(LongFNT-Speech),在LibriSpeech和GigaSpeech上分别实现了19%和12%的相对词错误率降低(相对WERR),优于FNT和CT基线。然后我们将LongFNT扩展到流式场景,提出了SLongFNT,在LibriSpeech和GigaSpeech上分别实现了26%和17%的相对WERR,优于流式FNT基线。实验表明,集成历史内容信息可以显著提高ASR性能,我们提出的模型为在现实世界中改善历史内容语音识别提供了一个有前途的解决方案,适用于非流式和流式两种情况。
参考文献
[7] X. Gong, Y. Wu, J. Li, S. Liu et al., “Longfnt: Long-form speech recognition with factorized neural transducer,” in 2023 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 2023.