分享5篇上海交通大学听觉认知与计算声学实验室被INTERSPEECH 2024录用的论文,论文方向涵盖语音增强、语音识别、语音合成、模型压缩等。以下是发表论文的相关信息:
01、Beyond Performance Plateaus: A Comprehensive Study on Scalability in Speech Enhancement
论文作者:张王优,Kohei Saijo,Jee-weon Jung,李晨达,Shinji Watanabe,钱彦旻
完成单位:上海交通大学 ,早稻田大学,卡耐基梅隆大学论文亮点:
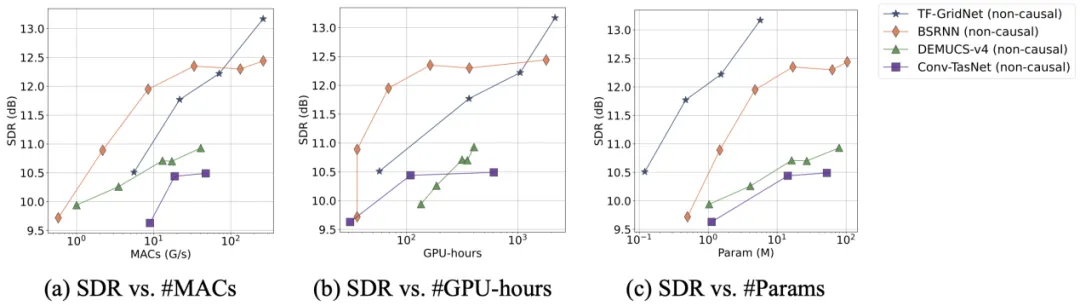
该论文深入探究了不同架构的语音增强模型(BSRNN、Conv-TasNet、DEMUCS-v4、TF-GridNet)在不同模型复杂度、不同训练数据量、因果/非因果模式等情况下的规模化能力。相关实验采用了来自多个领域的公开数据(VCTK+DEMAND、DNS-2020、WHAMR!、CHiME-4、REVERB),以评估模型的泛化能力和处理不同声学环境的通用性。实验结果揭示了不同模型架构在语音增强规模化能力上的显著差别,也指出了语音增强领域当前尚待探索的研究方向,如构建大规模多领域数据集和设计可高效规模化的模型架构。大部分语音增强的研究局限于较小数据量(如VCTK+DEMAND)或单一领域(如DNS-2020)的数据集,且性能评估往往仅在相应划分的测试集上进行,这使得研究者难以了解不同语音增强模型的实际泛化性和规模化能力。为填补这一研究空白,此论文针对语音增强领域常见的若干个模型架构展开探究,通过广泛实验比较和分析语音增强模型关于模型复杂度、训练数据量的规模化能力。论文首先在BSRNN架构上进行了系统性探究,实验结果表明该模型架构的非因果模式具有显著好于因果模式的规模化能力和泛化能力,且语音增强性能与模型复杂度呈现较为一致的正相关,但在训练数据较少(如仅采用9小时VCTK+DEMAND数据)时模型性能呈现出“双下降”现象,这表明较少数据量难以准确反应语音增强模型的真实能力。另一方面,当通过合并来自不同领域数据来扩充训练数据量时,BSRNN语音增强性能同样随着训练数据量增长而呈现一致改进的趋势。但通过仿真大量单一领域数据来进一步扩充语音数据规模时,语音增强性能反而出现下降,这表明在扩充数据量的同时保证数据的多样性对于语音增强模型的泛化性十分重要。最后,论文比较了不同模型架构关于模型复杂度、训练时间、参数量的规模化能力。结果如下图所示,其中BSRNN和TF-GridNet分别在较低和较高复杂度的情况下展现出最强的规模化能力,它们均采用了时频域双路建模的网络架构,这体现出这一架构的强大表示能力。但另一方面,这些模型架构均基于RNN进行设计,随着模型复杂度不断增大,其并行化能力的缺陷逐渐显现,导致很低的训练效率。因此,设计具有更高计算效率和强大规模化能力的语音增强架构是亟待解决的问题。
02、URGENT Challenge: Universality, Robustness, and Generalizability For Speech Enhancement
URGENT挑战赛:语音增强的通用性、鲁棒性和泛化性
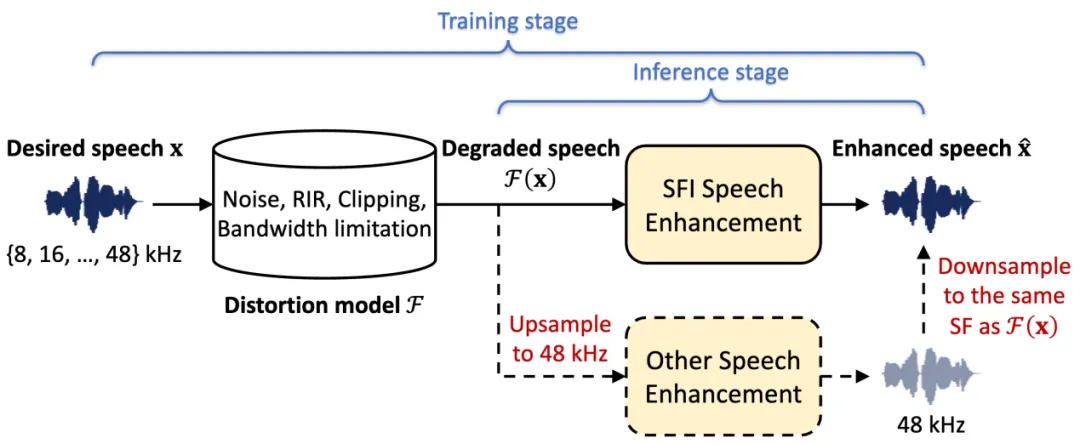
论文作者:张王优,Robin Scheibler,Kohei Saijo,Samuele Cornell,李晨达,倪兆衡,Anurag Kumar,Jan Pirklbauer,Marvin Sach6,Shinji Watanabe,Tim Fingscheidt,钱彦旻完成单位:上海交通大学,卡耐基梅隆大学 ,LY Corporation,早稻田大学,Meta,布伦瑞克工业大学该论文介绍了一项全新的语音增强比赛——URGENT 2024,其着重关注语音增强模型的通用性、鲁棒性和泛化性,旨在构建单个通用模型来同时处理具有不同失真和不同采样率的语音信号。区别于大部分现有语音增强比赛,URGENT 2024采用了更广义的语音增强任务定义(包含多种子任务)、大规模多领域数据(且约束了可用训练数据以保证公平性)以及十分多样的评估指标(四大类)。该论文还介绍了针对所提出的全新任务的通用语音增强框架,并基于多种常见语音增强模型进行了验证性实验。URGENT 2024是人工智能顶级会议NeurIPS 2024的官方比赛之一,旨在构建通用的语音增强模型统一处理具有不同失真和不同采样率等情况的输入语音信号,并评估模型在多样化测试数据上的鲁棒性和泛化性。作为URGENT 2024比赛的初期探索,此论文首先描述了比赛的主旨和设计思路(即致力于构建具有强泛化性的通用语音增强模型,并为相关研究提供初步的基准、公开数据集与评估手段),并针对比赛的任务定义、训练框架、数据准备和评估准则依次进行了详细介绍。与以往的绝大多数语音增强比赛的任务定义不同,URGENT 2024要求语音增强模型能够同时处理具有不同语音失真(如加性噪声、混响、削顶失真、频带受限等)和不同采样率的语音信号,从而构建通用语音增强模型。
接着,论文介绍了针对这一任务设计的语音增强框架,通过所设计的统一数据格式和采样率无关(Sampling-Frequency-Independent, SFI)的模型处理过程,该框架能够利用任意现有的语音增强模型实现对不同语音失真和不同采样率信号的统一处理。
由于缺少能够用于通用语音增强研究的现成公开数据,论文提出了一种基于公开数据的多样化语音数据准备方案,包括预处理和仿真两个阶段。预处理阶段将对采集到的语音和噪声数据进行有效频带估计和重采样,并利用语音活动检测、DNSMOS打分等技术滤除低质量样本。仿真阶段则基于筛选好的数据生成指定配置的多样化语音数据集,包含不同采样率和随机引入的不同失真。
- 最后,考虑到对不同语音失真的评估侧重点可能不同,论文将多种现有评估指标分为四大类(非侵入性指标、侵入性指标、下游任务独立指标、下游任务相关指标),并结合所有类别中指标的分数对不同模型的整体性能进行综合排名,从而实现更全面的性能评估。
论文网址:https://arxiv.org/abs/2406.04660
03、Contextual Biasing Speech Recognition in Speech-enhanced Large Language Model
论文作者:龚勋,吕安旗,王志铭,钱彦旻
完成单位:上海交通大学
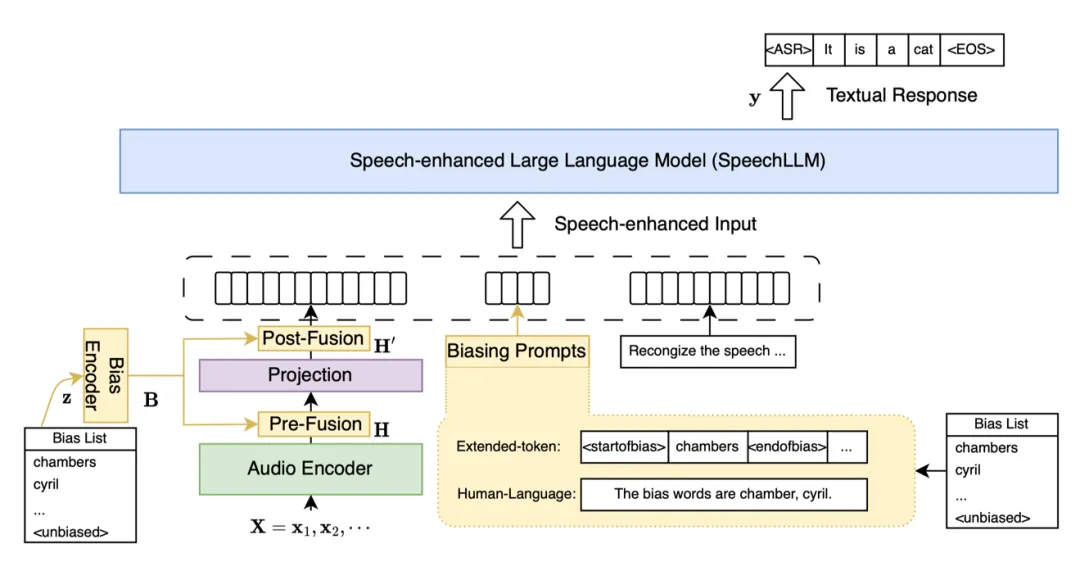
最近,音频和语音增强的大型语言模型(SpeechLLMs)如 QwenAudio 和 SALMONN 的快速发展显著推动了自动语音识别(ASR)的进步。然而,尽管通用识别能力有所提升,热词(Bias word)识别仍然是 SpeechLLM 面临的一个重要挑战,并且尚未得到广泛研究。在这项研究中,我们引入了两种热词偏移策略,以改善 SpeechLLM 的热词识别。首先,我们探索了两种类型的Bias提示词,取得了偏见词错误率(WER)相对减少 10% 的成绩。然而,随着热词列表的增大,性能由于幻觉现象而显著下降。随后,我们构建了Bias Fusion Network,该网络将热词向量与 SpeechLLM 框架集成。我们在 LibriSpeech test-clean/-other 数据集上进行的实验表明,与基线相比,我们的方法在整体/热词 WER 上分别实现了高达 10%/35% 的相对减少。为了解决 SpeechLLM 中热词识别的挑战,我们提出了两种偏向策略:Bias提示和Bias融合网络。首先,我们介绍了两种设计用于增强 SpeechLLM 输入的Bias提示。一种是扩展标记列表,用特殊标签包围热词(称为“特殊标签”提示),另一种是在自然构建的语言中嵌入热词(称为“自然语言”提示)。然而,我们观察到随着热词列表的扩展,性能显著下降,主要归因于 LLM 的幻觉现象。为了解决这个问题,特别是在热词列表较大的情况下,我们提出了基于 SpeechLLM 的Bias融合网络。这种方法从一个轻量级文本编码器开始,该编码器专门用于将热词编码为一系列热词嵌入。热词嵌入与中间特征结合,然后用于调整 SpeechLLM 的隐藏状态。这种策略专门设计用于增强 SpeechLLM 准确识别目标词的能力。对于这些方法,我们采用低秩适配(LoRA)进行微调,有效减少了可训练参数。我们的方法在识别热词方面超过了基线,与以往研究相比,我们的实验在整体和热词准确性上表现出竞争力甚至优越的性能。偏向提示方法采用了两种预定义提示的监督微调,通过相对热词错误率(B-WER)减少 10% 来评估其效果。然而,随着热词列表的增长,上述方法的性能由于 LLM 的幻觉而大幅下降。偏向融合方法,通过探索了不同的热词编码器以找到最有效的架构,并探索了不同的融合位置以提高性能,最终在 100 小时LibriSpeech训练集上实现了 19% 的相对 B-WER 减少,在 960 小时训练集上实现了 35% 的相对 B-WER 减少。
04、Generating Speakers by Prompting Listener Impressions for Pre-trained Multi-Speaker Text-to-Speech Systems
基于预训练多说话人文本到语音系统的听者印象提示的说话人生成
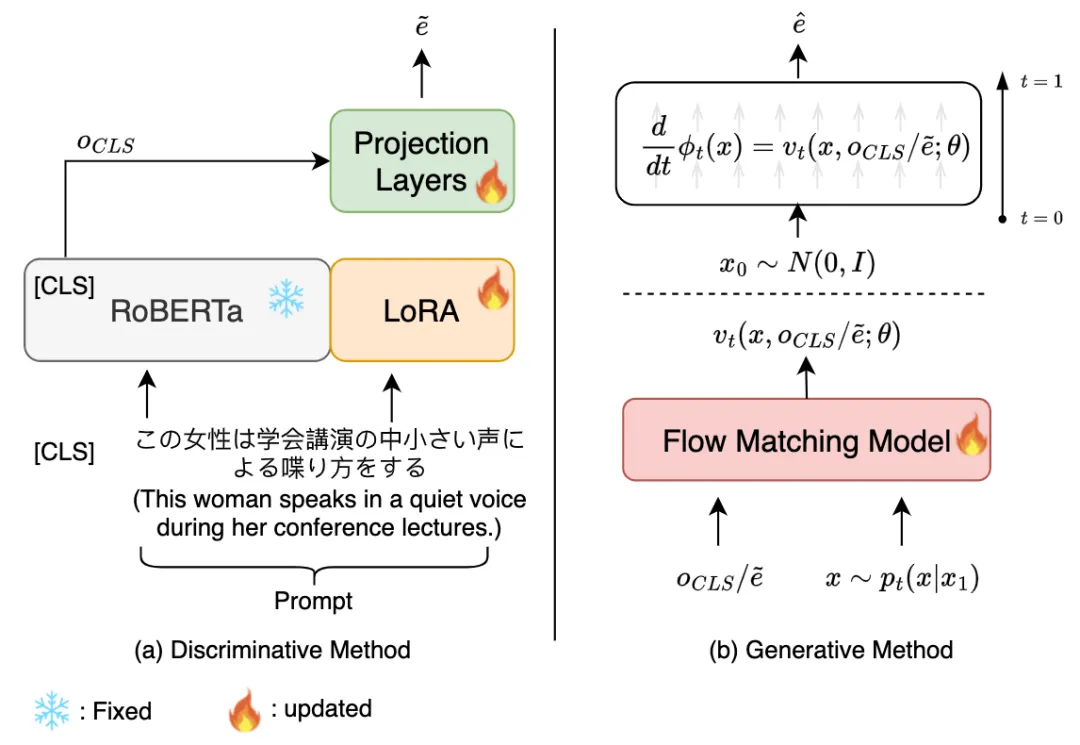
论文作者:陈正阳,刘学琛,Erica Cooper, Junichi Yamagishi, 钱彦旻完成单位:上海交通大学,日本国立情报研究所,日本情报通信研究机构该论文提出了一个通过文本描述控制语音生成中说话人相关特性的框架。基于文本驱动的说话人控制的一个关键点就是数据,首先论文提出了基于听者印象分数(Impression score)来生成相关描述。此外,在通过文本来生成多说话人语音合成系统所需要的说话人嵌入向量的时候。文章提出了两种方法,鉴别性方法和生成式方法。作者发现,鉴别性方法可以帮助系统更好的捕捉文本中的说话人特性,而生成式方法则可以帮助系统生成更高质量的语音。两者结合可以使得系统在两方面都有着比较好的表现。与之前的大多数文本驱动的说话人特性控制的语音合成系统(TTS)不同。我们这里使用了一个预训练的多人TTS系统VITS。VITS需要额外的说话人编码器(speaker encoder)来建模说话人相关的表征向量e. 因此我们只需要把speaker encoder替换成文本描述编码器(Prompt Encoder)就可以了。在训练prompt encoder的时候,我们会把文本描述(prompt)映射到对应的说话人表征向量e。如下图所示,我们提出了两种方法,左子图是一种鉴别性方法,对于鉴别性方法,固定的prompt输入会得到固定的说话人表征向量输出。右子图是生成式方法,对于固定的prompt输入,模型建模的是关于这个prompt的说话人表征的分布,也与实际更加符合。比如文本描述是“一个老人在说话”,这句话很可能对应多个说话人表征。我们在实验中发现,鉴别性方法对于prompt里信息的保持更好,而生成式方法得到的语音质量更好。如果把鉴别性方法的输出作为生成式方法的一个条件输入,会使得模型拥有两种方法的优点。
05、SparseWAV: Fast and Accurate One-Shot Unstructured Pruning for Large Speech Foundation Models
SparseWAV:用于语音基座大模型的快速准确的单样本非结构化剪枝
论文作者:顾天腾,刘贝,邵航,钱彦旻
完成单位:上海交通大学
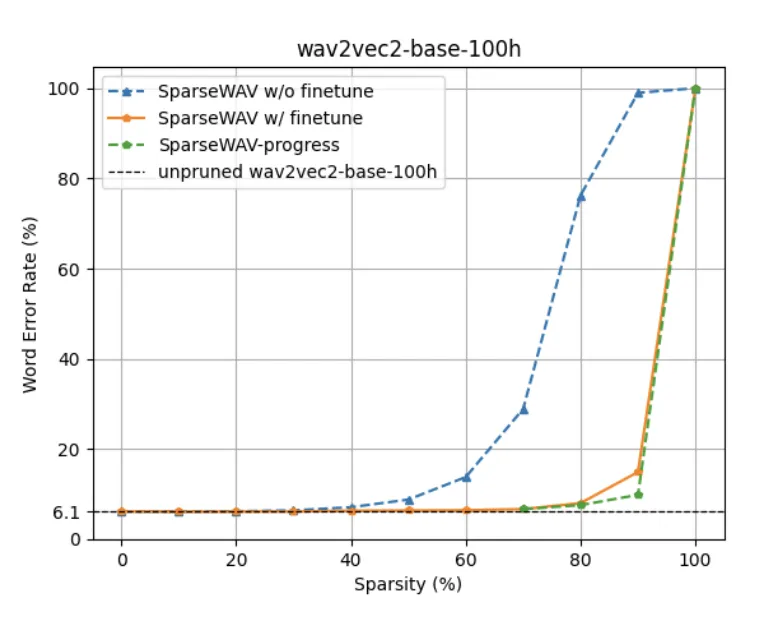
该论文提出了SparseWAV,这是一个专为大型语音基础模型设计的快速准确的非结构化剪枝框架。SparseWAV能够在不牺牲模型性能的情况下高效地移除不重要的参数,实验表明预训练自监督大型语音模型中70%的参数都可以被SparseWAV无损移除。与以往的工作相比,SparseWAV在相同的稀疏度条件下实现了高达30%的被裁剪模型的性能提升。自监督语音表示学习在自动语音识别领域已经证明了其卓越的性能,但这些预训练模型对计算资源和存储空间的巨大需求,限制了它们在消费级产品中的广泛应用。为了克服这一挑战,我们引入了SparseWAV,这是一种创新的、快速且准确的非结构化修剪框架,专为大型语音基础模型量身定制。SparseWAV能够高效地剔除预训练模型中的大量冗余参数,同时确保性能的不变,并且即便在高稀疏度条件下也能有出色的表现。以下是我们工作的主要亮点:
- 我们对OBS(Optimal Brain Surgeon)框架进行了改进,使其更加适合于大型语音模型的修剪任务。
- 我们将一阶梯度信息整合到参数重要性的评估标准中,以纠正修剪过程中可能出现的梯度偏差。
- 我们开发了一种新颖的方法,能够根据不同权重矩阵的特性动态分配稀疏度,优化模型的压缩效果。
在公开数据集LibriSpeech上的实验表明,我们的方法在保持模型性能的同时,能够无损地移除wav2vec2-base模型中高达70%的参数,超越了以往的模型压缩技术。

 语音小管家