中国传媒大学、中国科学院自动化研究所、中国科学院大学、清华大学联合推出了Codecfake数据集及面向ALM伪造音频的检测方法,相关论文《The Codecfake Dataset and Countermeasures for the Universally Detection of Deepfake Audio》正于期刊IEEE/ACM TASLP审稿中,相关数据集和代码均已开源。
论文链接:https://arxiv.org/abs/2405.04880
数据集链接:https://zenodo.org/records/11171708
代码链接:https://github.com/xieyuankun/Codecfake
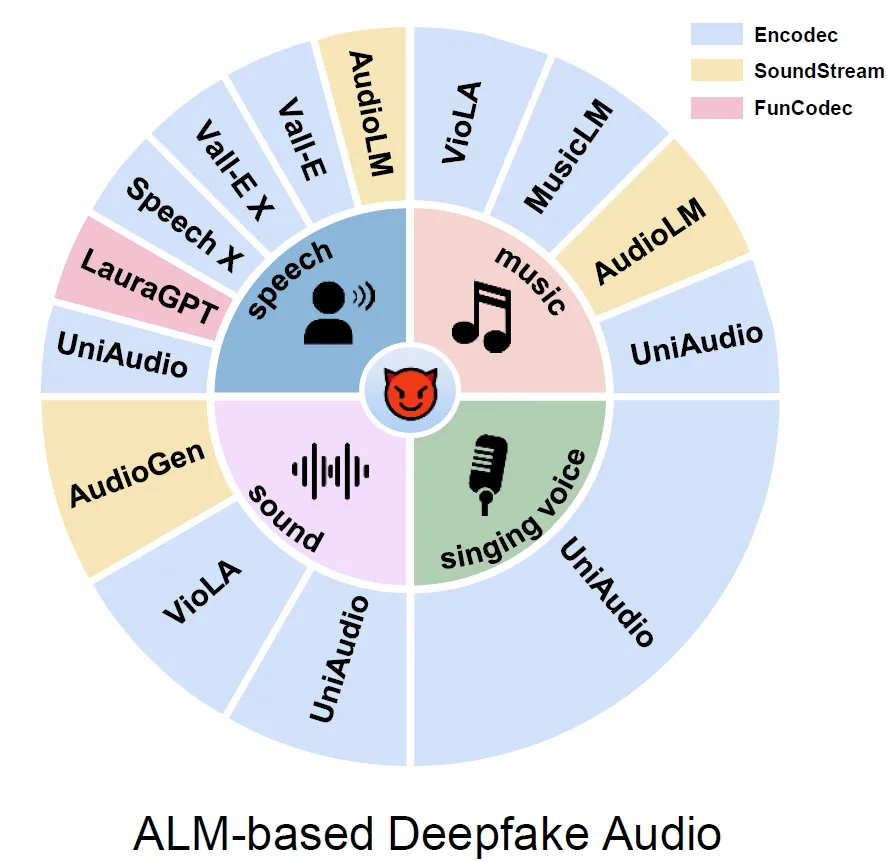
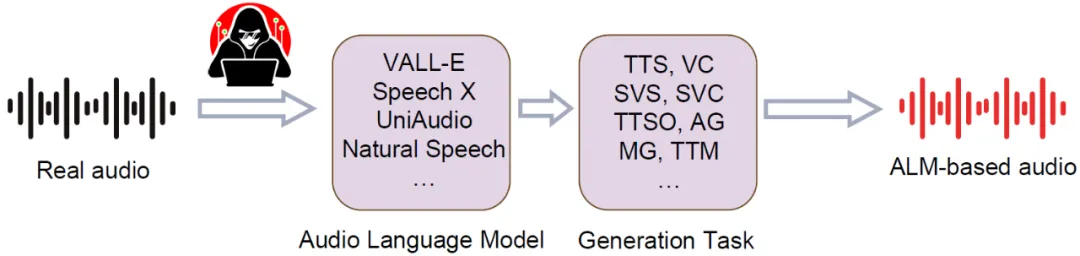
当前音频语言模型(Audio Language Model, ALM),得益于大语言模型(Large Language Model. LLM)和神经编解码器模型(Neural Codec Model)正在快速发展。随着ALM-based audio的不断增多,这对当前深度伪造音频检测 (Audio deepfake detection, ADD)模型造成了以下挑战:- 高传播性:与先前基于声学模型和声码器的合成模型相比,ALM基于语言模型和神经编解码器范式,使用prompt可以定制化生成所需音频,这极大降低了ALM 深度伪造音频的合成门槛。基于ALM的深度伪造音频的增加对当前仅基于声码器伪造音频训练的鉴伪模型造成了极大的挑战。
- 高欺骗性:ALM可以生成高质量的深度伪造音频,这增强了欺骗性。ALM甚至在低资源和低质量条件下可以生成高质量音频。这种高欺骗性的音频给音频鉴伪模型带来了极大的挑战。
- 高多样性:ALM由多样性的音频数据集训练可以覆盖多种生成任务,如图2所示这包括不同的深度伪造音频合成任务,涉及语音、音乐、音效、歌声等。这对当前仅基于语音训练的音频鉴伪模型形成了极大的挑战。
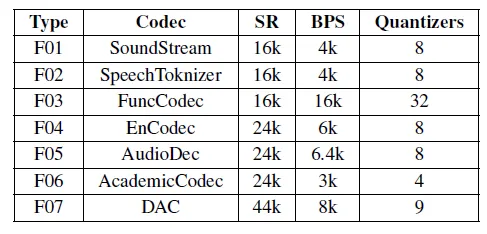
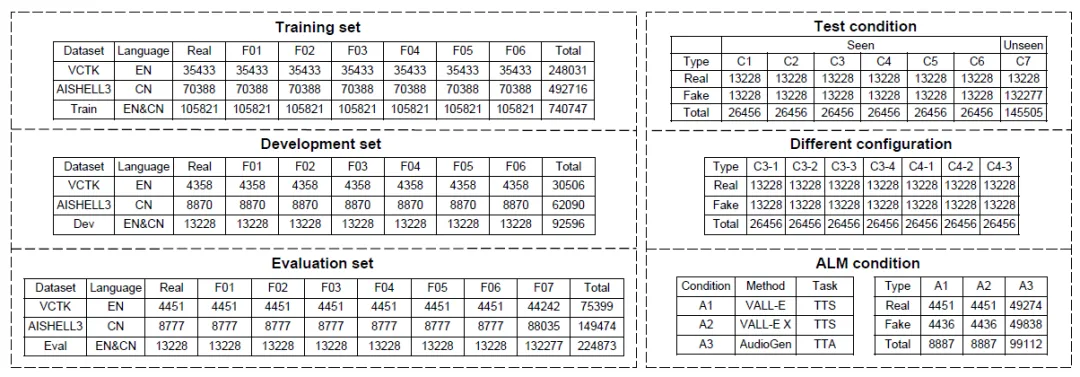
基于上述挑战,我们专注ALM的生成机理-神经编解码器部分,开发了第一个面向ALM的深度伪造音频数据集名为Codecfake。Codecfake包含2种语言和7种最新的神经编解码方法,总音频样本数量超过1M,并且涵盖大量测试条件。具体来讲,Codecfake的7种Codec方法如图3所示,我们将F01-F06作为训练和验证,F07作为不可见测试。除此之外,测试条件涵盖相同编码方式不同条件的测试,以及最终针对基于ALM的深度伪造音频测试,数据集总览如图4所示。图3 Codecfake中伪造方式F01-F07
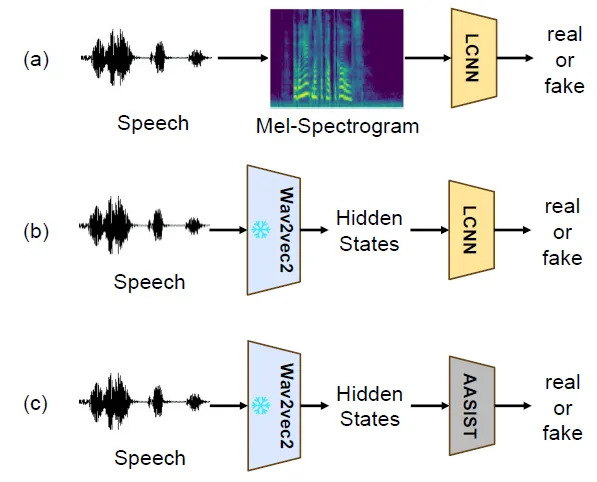
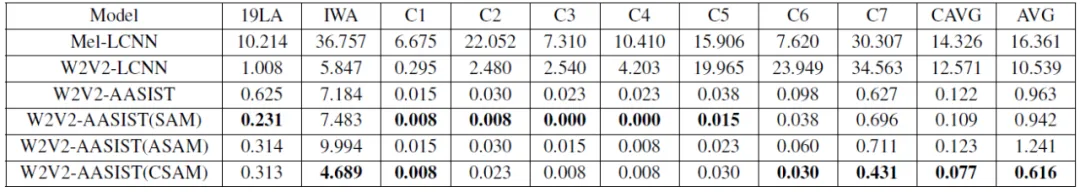
对于鉴伪方法,我们考虑了三种方案,如图5所示。前端特征包括手工特征(80维梅尔谱)以及预训练特征(Wav2vec2-XLS-R)。在主干网络方面,我们选取了LCNN和AASIST两种在音频鉴伪领域内主流的主干网络。值得注意的是,这些基线模型已经在音频鉴伪公开数据集ASVspoof2019LA测试集上取得了0.12%的等错误率,达到了目前的最佳水平。此外,为了确保鉴伪模型在基于声码器和基于神经编码器的两种伪造音频上都能有效,我们提出了共训练锐化感知最小化(Co-training sharpness aware minimization, CSAM)策略,以解决原始SAM在多域训练时所产生的域训练捷径问题。实验结果如表1所示,证明了我们方法的有效性。表1 使用19LA和Codecfake共训练的鉴伪模型表现
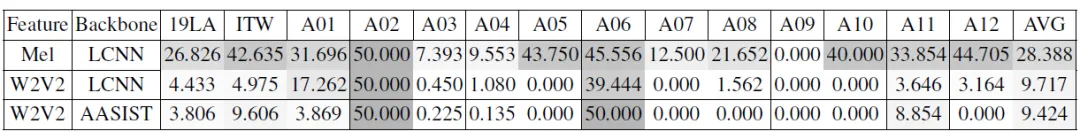
为了验证使用Codecfake数据集是否能对野外的ALM具有良好检测效果,我们收集了12种ALM音频,包括A01-A12:A01-AudioLM,A02-AudioLM-music,A03-VALL-E,A04-VALL-E X,A05-SpeechX,A06-UniAudio,A07-LauraGPT,A08-ELLA-V,A09-HAM-TTS,A10-RALL-E,A11-NaturalSpeech 3,A12-VALL-E 2。由于大部分ALM尚未开源,除A03,A04以外其余音频样本均来自官方论文样本页,测试结果如表2所示。可以看到在大部分ALM条件上,等错误率达到了0%,这表示使用Codecfake数据集进行训练可以有效检测基于ALM的深度伪造音频。表2 使用Codecfake训练的鉴伪模型在野外ALM上的表现
通过本项研究,我们探索了面向ALM时代的音频鉴伪模型。利用本项研究所提出的数据集Codecfake、先进的鉴伪方法和CSAM训练策略,所设计的鉴伪模型在基于ALM的生成音频和基于声码器的生成音频上均取得了令人满意的效果。在大范围的开集ALM测试中,大部分ALM测试条件的等错误率达到了0%。本项研究为ALM时代音频鉴伪模型的研究提供了有力支持。论文链接:https://arxiv.org/abs/2405.04880数据集链接:https://zenodo.org/records/11171708代码链接:https://github.com/xieyuankun/Codecfake 
 语音小管家