AI圈这遍地开花的大好局面,让吃瓜群众们甚是惊喜。
自 Sora 发布以来,国内外各大科技公司和研究机构都在竞相推出“文生视频”大模型,比如生数科技的 Vidu、快手的可灵和 Runway 昨天才发布的 Gen-3 Alpha 等。然而,目前许多系统只能生成无声输出,在视频生成过程中,为视频生成栩栩如生、同步的音频,亦是一个不可忽视的关键环节,它不仅关系到视频内容的质感和真实感,还影响到信息的传递和用户的体验。同样在昨天,GoogleDeepMind分享了他们在“视频生音频”方面的新进展——V2A,使同步视听生成成为可能。
据介绍,V2A 将视频像素与自然语言文本提示相结合,为屏幕上的动作生成丰富的音效。这一技术可与视频生成模型搭配使用,从而创建具有逼真音效或对话的镜头,从而与视频中的角色和基调相匹配。V2A 还可以为各种传统素材(包括档案资料、无声电影等)生成配乐,从而为创作提供更多机会。
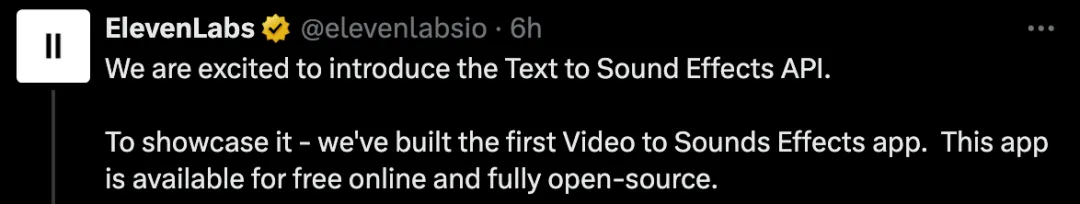
其实,就在 Google DeepMind 官宣没多久,AI 音频领域的「扛把子」ElevenLabs 就横插一脚,开源了一个上传视频自动配音的项目,可以为视频生成合适的音效。
链接:https://elevenlabs.io/docs/api-reference/how-to-use-text-to-sound-effects
AI 视频告别无声电影
众所周知,视频生成模型正以惊人的速度发展。不过,无论是年初惊艳世人的 Sora,还是近期的可灵、Luma、Gen-3 Alpha,生成的全是「无声电影」,无一例外。
而 Google DeepMind 的视频生成音频 (V2A) 技术,使得同步的视听生成成为可能。它可以结合视频像素和自然语言文本提示,为屏幕上的动作生成丰富的配音。
从技术应用上来说,V2A 技术能够与 Veo 等视频生成模型结合,创造出具有戏剧性配乐、逼真音效或与视频角色以及风格相匹配的对话镜头。
它还能为档案材料、无声电影等传统影像生成音轨,拓宽创作的可能。
V2A 技术能够为任何视频输入生成无限数量的音轨。用户可以选择定义「正向提示」来引导生成期望的声音,或者「负向提示」来避免不期望的声音。
这种灵活性让用户对音频输出有了更多的控制,可以快速尝试不同的音频输出,并选择最佳匹配。
V2A 技术是如何实现的?
据介绍,为发现最具可扩展性的人工智能架构,研究团队尝试了自回归和扩散方法,他们发现,基于扩散的音频生成方法在同步视频和音频信息方面给出了更真实、更令人信服的结果。V2A 系统首先将视频输入编码为压缩表示;然后,扩散模型从随机噪声中迭代改进音频。这一过程在视觉输入和自然语言提示的引导下,生成与提示紧密对齐的同步逼真音频;最后,对音频输出进行解码,将其转化为音频波形,并与视频数据相结合。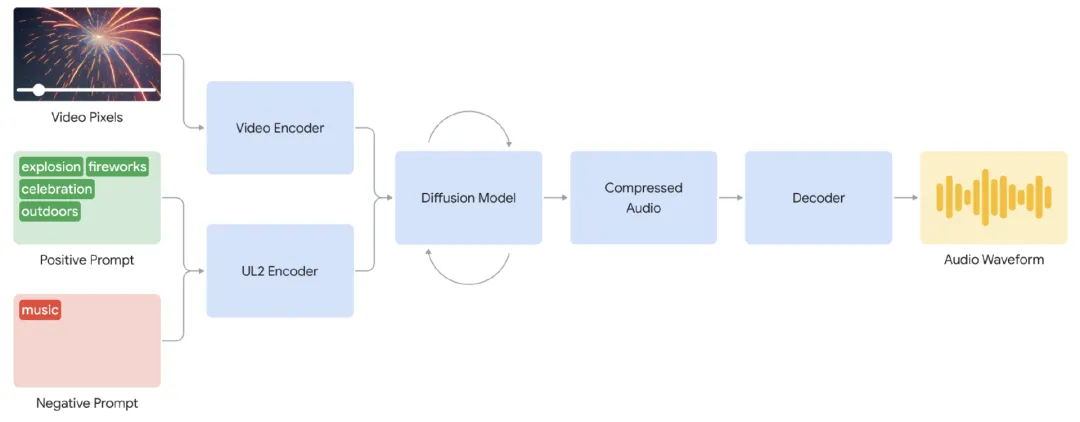
图|V2A 系统示意图,该系统利用视频像素和音频提示输入生成与底层视频同步的音频波形。首先,V2A 对视频和音频提示输入进行编码,并通过扩散模型反复运行。然后生成压缩音频,并解码为音频波形。
为了生成更高质量的音频,并增加引导模型生成特定声音的能力,研究团队在训练过程中添加了更多信息,包括人工智能生成的注释,其中包含声音的详细描述和口语对话记录。通过对视频、音频和附加注释进行训练,V2A 系统学会了将特定音频事件与各种视觉场景联系起来,同时对注释或文本中提供的信息做出响应。谷歌方面强调,他们的技术与现有的视频到音频解决方案都不同,因为它可以理解原始像素,并且添加文本提示是可选的。此外,该系统不需要手动对生成的声音与视频进行对齐,极大地简化了创作流程。不过,研究团队表示,他们还在努力解决其他一些限制因素,进一步的研究正在进行中。例如,由于音频输出的质量取决于视频输入的质量,因此视频中超出模型训练分布范围的伪影或失真会导致音频质量明显下降。同时,他们还在改进语音视频的唇语同步。V2A 会尝试从输入文本中生成语音,并与人物的唇部动作同步。但是,配对视频生成模型可能并不是基于或受输入的文本所限制或影响的。这就造成了不匹配,往往会导致不可思议的唇部同步,因为视频模型生成的嘴部动作无法与文字相匹配。或许是由于深度伪造技术带来诸多社会问题,Google DeepMind 求生欲满满,一个劲承诺将负责任开发和部署 AI 技术,在向公众开放之前,V2A 技术将经过严格的安全评估和测试。
此外,他们还整合了 SynthID 工具包到 V2A 研究中,为所有 AI 生成的内容添加水印,以防止技术的滥用。
参考链接:

 机器之心