
 西工大音频语音与语言处理研究组
流式零样本语音转换(streaming zero-shot voice conversion)是指能够实时的将输入语音转换成任意说话人的语音,且仅需要该说话人一句语音作为参考,且无需额外的模型更新。现有的零样本语音转换方法通常是为离线系统设计,难以满足实时语音转换应用对于流式能力的需求。近期基于语言模型(language model, LM)的方法在零样本语音生成(包括转换)上展现出卓越的性能,但是需要整句处理而局限于离线场景。

发表论文截图
语音转换(Voice Conversion,VC)是一个在不改变语音内容的前提下,改变语音中说话人音色的一项技术,通常需要目标说话人的大量语音进行系统构建。仅使用目标说话人的一句话作为参考来实现语音转换,即零样本 VC(Zero-shot VC),在近年来获得了极大关注。然而,大多数零样本 VC 都是针对离线系统设计的,难以满足实时 VC 应用中对流式能力的需求。在本工作中,我们主要关注于流式的零样本语音转换,原理如图1所示。此外,实验室之前也推出了流式VC方案即DualVC系列。
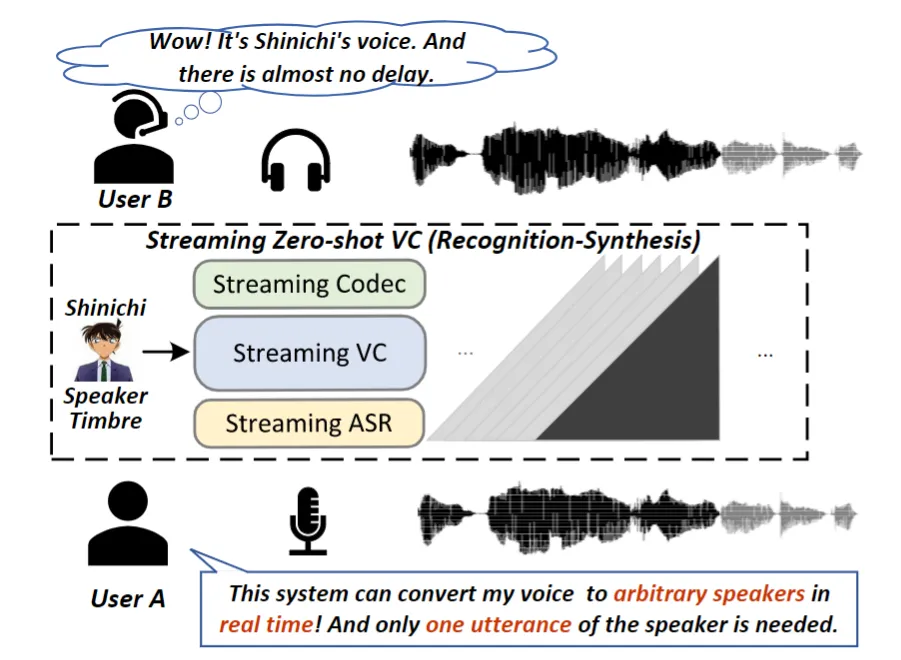
图1 零样本流式语音转换示意图(识别-合成语音转换框架 [1])
实现零样本语音转换的关键是将语音分解成不同的成分,比如语义内容和说话人音色等[2]。最近, 借助于LM的建模能力和训练数据规模的提升,基于LM的语音转换模型[3]取得了出色的零样本转换性能,但是目前基于 LM 的 VC 模型只能用于离线应用场景。过去已有的一些非 LM 的流式零样本方法[4]本身资源场景要求和模型设计容量受限且缺乏训练数据,难以实现对未见说话人(unseen speaker)的高质量转换同时达到高自然度和相似度。
由于基于LM的模型在零样本 VC 中的成功,我们探索应用LM在流式VC上的可行性。直观的方法是遵循图1所示的广泛使用的识别-合成(Recognition-Synthesis)框架。基于 LM 的零样本 VC模型在流式场景中主要面临两个挑战:
可流式架构:流式中模型需要在接收输入后立即产生输出而不能依赖未来的输入信息。当前基于LM的VC模型仅能在接收完整输入之后才能进行转换。同时对于多层级的codec特征也使得流式的系统设计更加复杂。除此之外,流式系统的上下游依赖模型也影响VC模型的设计和性能。
性能差距:与非流模型相比,流式模型无法看到未来信息,面临缺失的上下文,存在潜在的性能下降。除此之外,依赖的语音提取器,即流式ASR,本身识别性能会比非流式版本低,同时它提取得到的BNF是低质量的语义信息,其中包含残存的说话人信息和噪声等。流式VC模型本身不可获取未来信息以及这种低质量的语义输入使得实现高质量的转换变得更加困难。
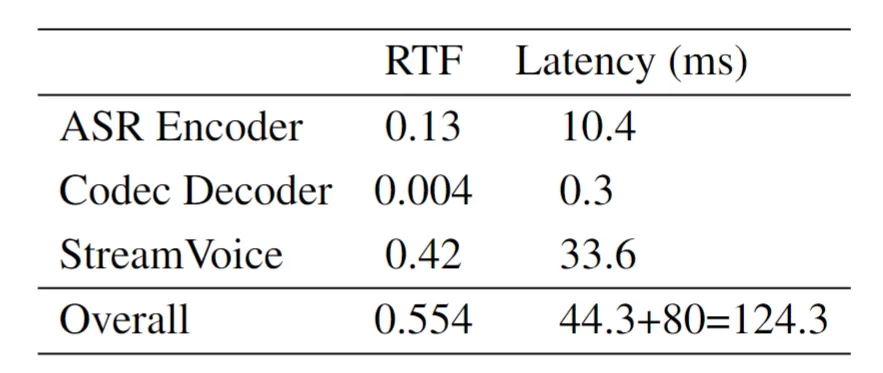
本文提出StreamVoice,一种基于流式 LM 的模型,用于高质量的零样本语音转换。具体来说,StreamVoice 具备可流式架构及进行全因果的语音生成。每个时间步上语义和声学特征的交替输入确保了流式的实现。此外,引入了两种方法来增强 LM 的上下文感知,以减轻上下文信息缺失造成的性能差距。1)结合教师指导的上下文预知(teacher-guided context foresight),其中非流式ASR作为教师来提供更加准确的当前和未来语义信息来引导VC模型用于增强声学预测。2)为了增强对于输入历史的上下文学习,语义掩蔽鼓励从历史损坏的语义输入进行声学预测,这也隐含地创建了一个信息瓶颈来减少源说话人的信息。实验验证了StreamVoice的良好的流式转换性能。同时StreamVoice本身不需要未来信息,在没有工程优化的情况下,A100上整个流式系统只需要124ms的首包延迟。
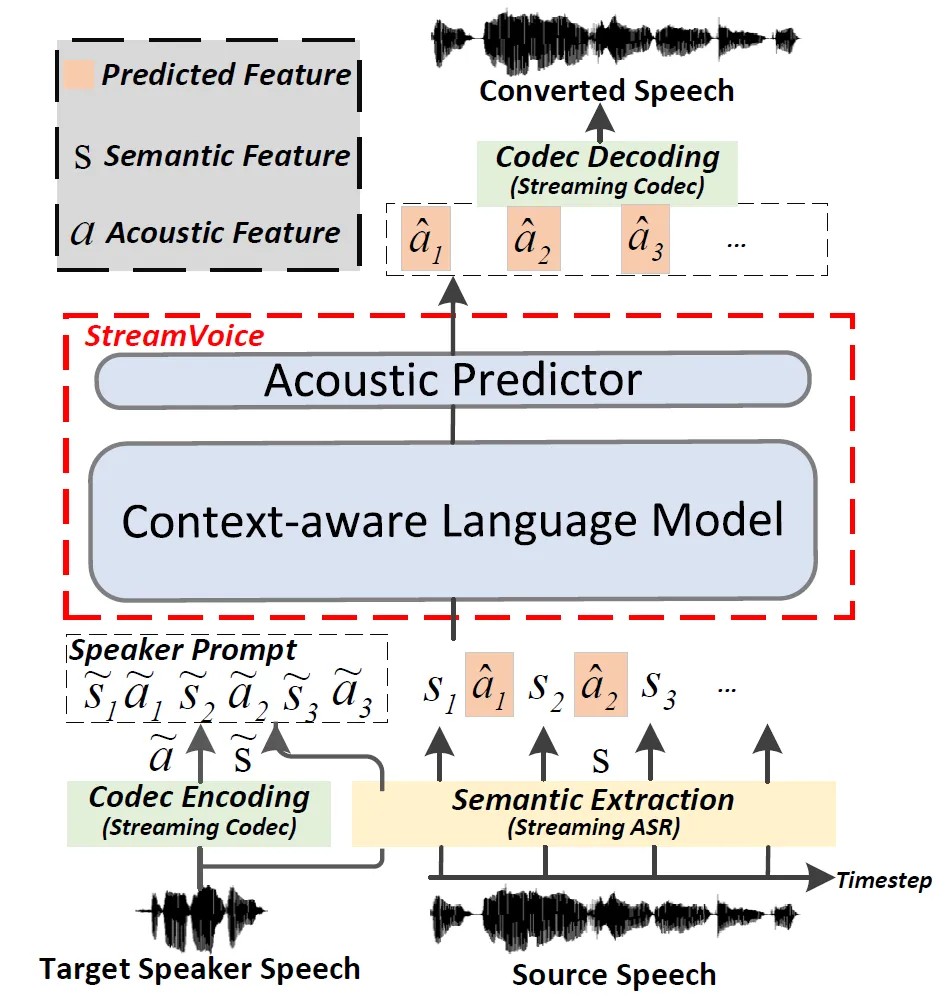
图2 StreamVoice框架
在 StreamVoice 中,语言模型经过改造来实现完全因果。其中声学预测器实现逐帧预测,而不依赖于时间信息。
纯因果LM:如图3所示,为了不依赖于未来信息,在模型结构上,带有单向注意力的decoder-only能够满足因果生成的要求。而就模型输入而言,语义和声学特征首先长度上进行对齐然后交替输入LM中,形成交叉嵌入
时序无关声学预测器: 由于LM是将历史和当前的语义内容和声学信息编码到隐层输出
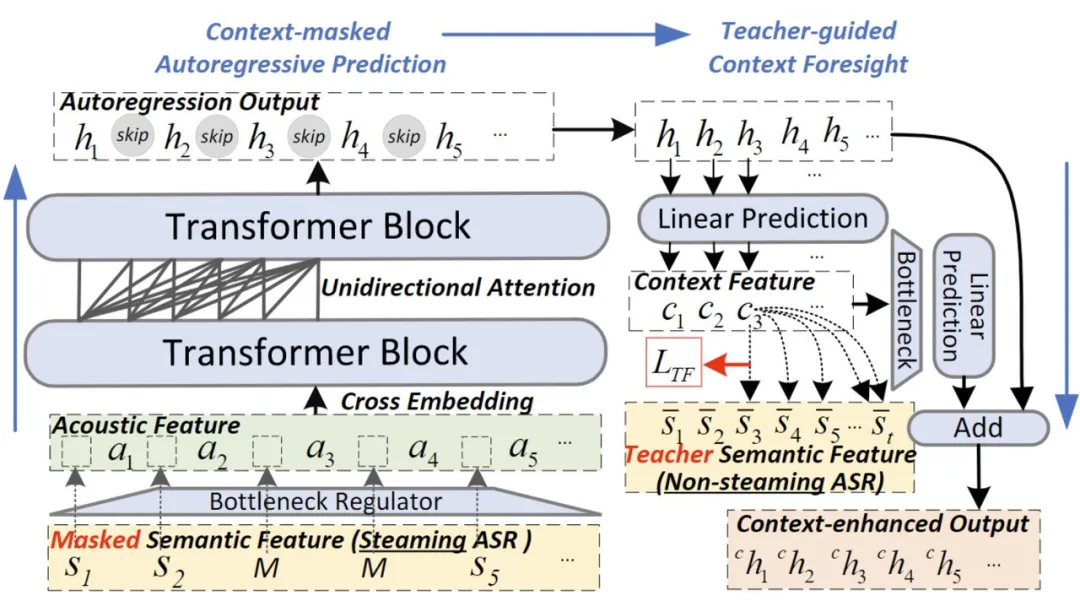
图3 上下文感知LM结构
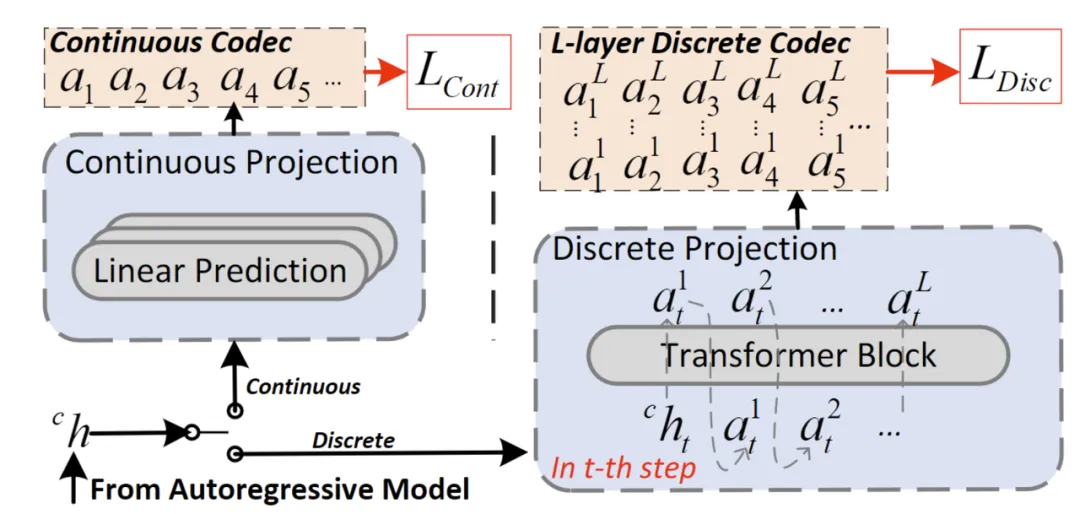
图4 声学预测器结构
由于流式框架中因果关系的要求,VC模型面临着未来信息的缺失,同时流式ASR的低质量语义输入使得实现高质量的转换更具挑战性。我们引入了上下文感知增强方法来缓解语义输入和未来信息缺失产生的不完整上下文信息。具体来说,我们在 LM 中引入了上下文掩码自回归预测,以增强从给定的语义输入中捕获历史上下文。同时,提出了一种教师引导的上下文预知,以确保模型可以根据其历史上下文想象未来的上下文。
Context-masked Autoregressive Prediction:与过去很多工作类似,掩蔽的策略被直接用来处理输入序列以此鼓励模型从受损序列中更多的通过总结上下文来实现最终的自回归预测。
Teacher-guided Context Foresight:为了缓解缺乏未来上下文的问题,受到自监督APC[6]方法的启发,我们引入了由非流式ASR主导的教师引导上下文预知,来指导模型学习包含未来信息的上下文向量。如图5所示,具体来说, 隐层输出经过线性变换得到的上下文向量期望能够包含编码局部语音序列的通用结构,上下文向量通过预测包含当前时刻和未来k个时间步的语义信息,来共同保证对于未来信息预测和当前内容的准确传递。与原始的apc不同的是,我们采用非流式 ASR 模型作为教师来提供语义信息指导这个过程。这样做也是为了防止流式ASR 中低质量语义特征带来的问题。预测的上下文向量与隐层输出结合共同用于进一步的声学预测。
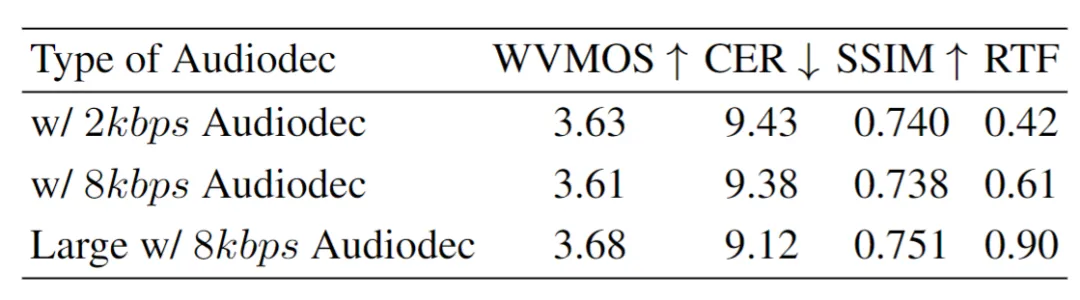
实验设置:实验中使用1500小时的中文数据进行训练。其中流式ASR使用的是Fast-U2++[7], 流式Codec采用的是Audiodec[8]。
实验结果:表1展示了StreamVoice在零样本语音转换中的结果。可以看出,相比于非流式VC系统,SteamVoice能够取得接近的结果,当然仍旧存在性能差异。而当将StreamVoice输入替换成非流式ASR特征之后,它的性能跟非流式topline具有可比的结果。这些结果表明了StreamVoice设计的有效性。
表1 零样本转换验证
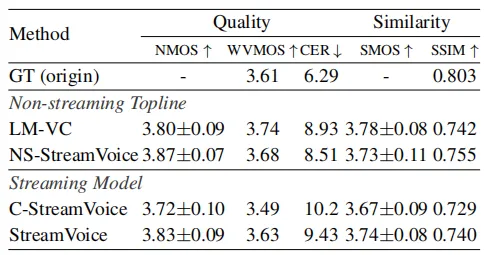
表2 延迟测试结果(A100),其中ASR chunk size为80ms
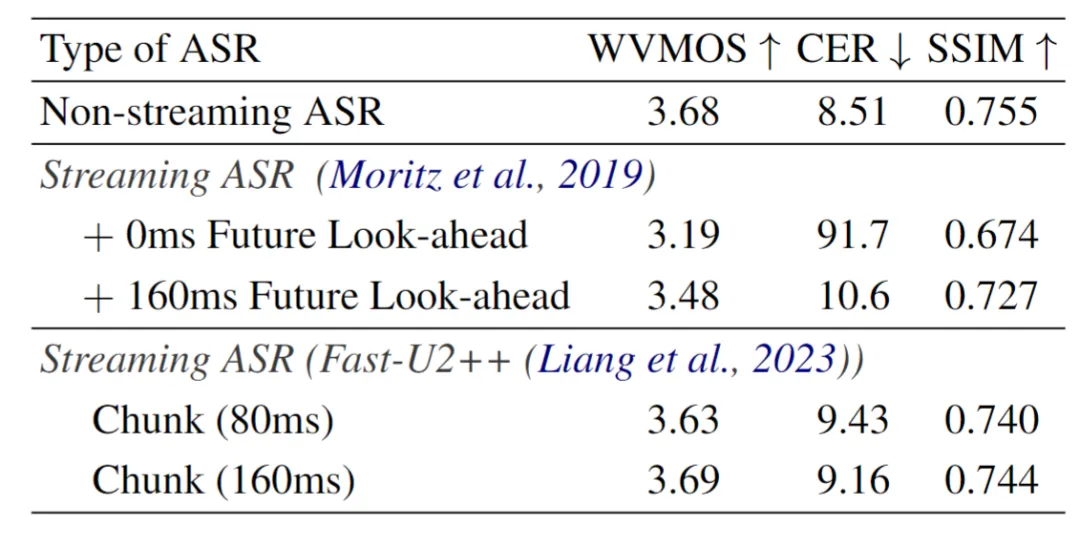
以下为StreamVoice 流式零样本VC结果,在V100上的RTF为0.56,整体首包延迟为137.2ms。
更多样例:https: //kerwinchao.github.io/StreamVoice/
