
 语音小管家
近期,上海交通大学听觉认知与计算声学实验室的论文“Attention-based Encoder-Decoder End-to-End Neural Diarization with Embedding Enhancer”被语音领域顶级期刊IEEE/ACM Transactions on Audio, Speech and Language Processing (TASLP) 接收。该论文首次将基于注意力机制的编码器-解码器结构成功应用于说话人日志任务。并提出了一系列方法解决了TS-VAD系统的两阶段复杂性问题,以及端到端说话人日志系统的收敛慢,难以泛化到训练过程中未见到的说话人个数的问题。基于论文中提出的新方法,该论文的系统在三个说话人日志标准数据集CALLHOME, DIHARD II, AMI上都取得了最优的结果。除了说话人日志任务,该论文提出的系统还可以被单独用作一个语音类型检测模型,并在相关任务上展现了极强的能力。
Attention-based Encoder-Decoder End-to-End Neural Diarization with Embedding Enhancer
作者列表:陈正阳,韩冰,王帅,钱彦旻
背景动机
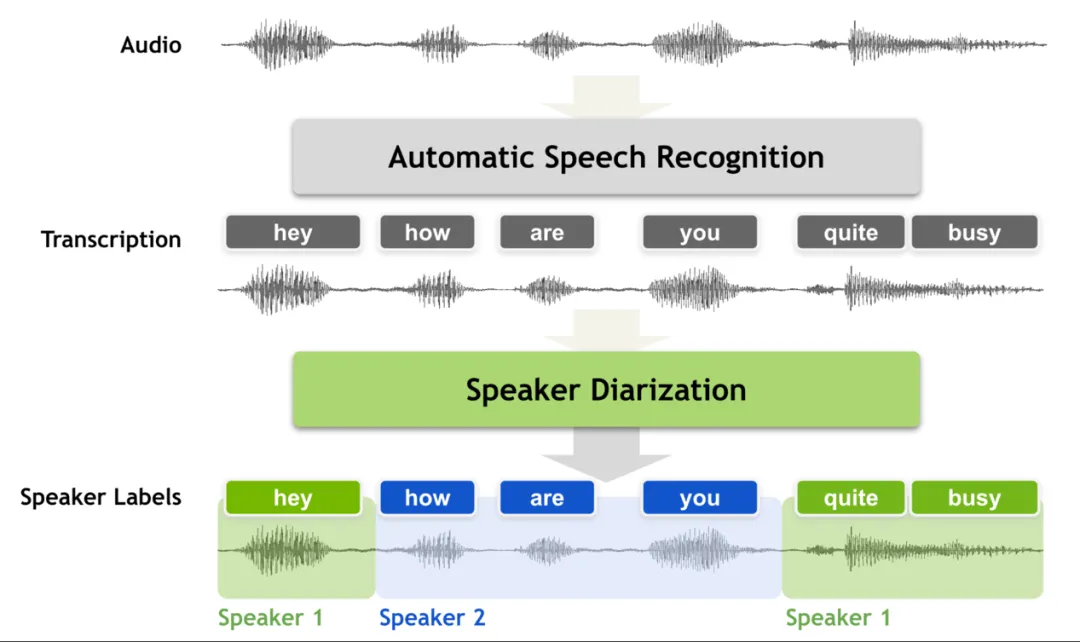
我们首次成功地将基于注意力机制的编码器-解码器结构来解决说话人日志问题。 我们提出将teacher-forcing策略用于训练过程,解决了传统EEND收敛慢的问题 我们提出了一种迭代式的解码策略来逐个输出每个人的diarization结果 我们提出了一种帧级别说话人嵌入特征的增强模块,可以使得网络更好的泛化到没有见过的说话人个数的情况。
方案
基于注意力-编码器-解码器架构的端到端说话人日志系统
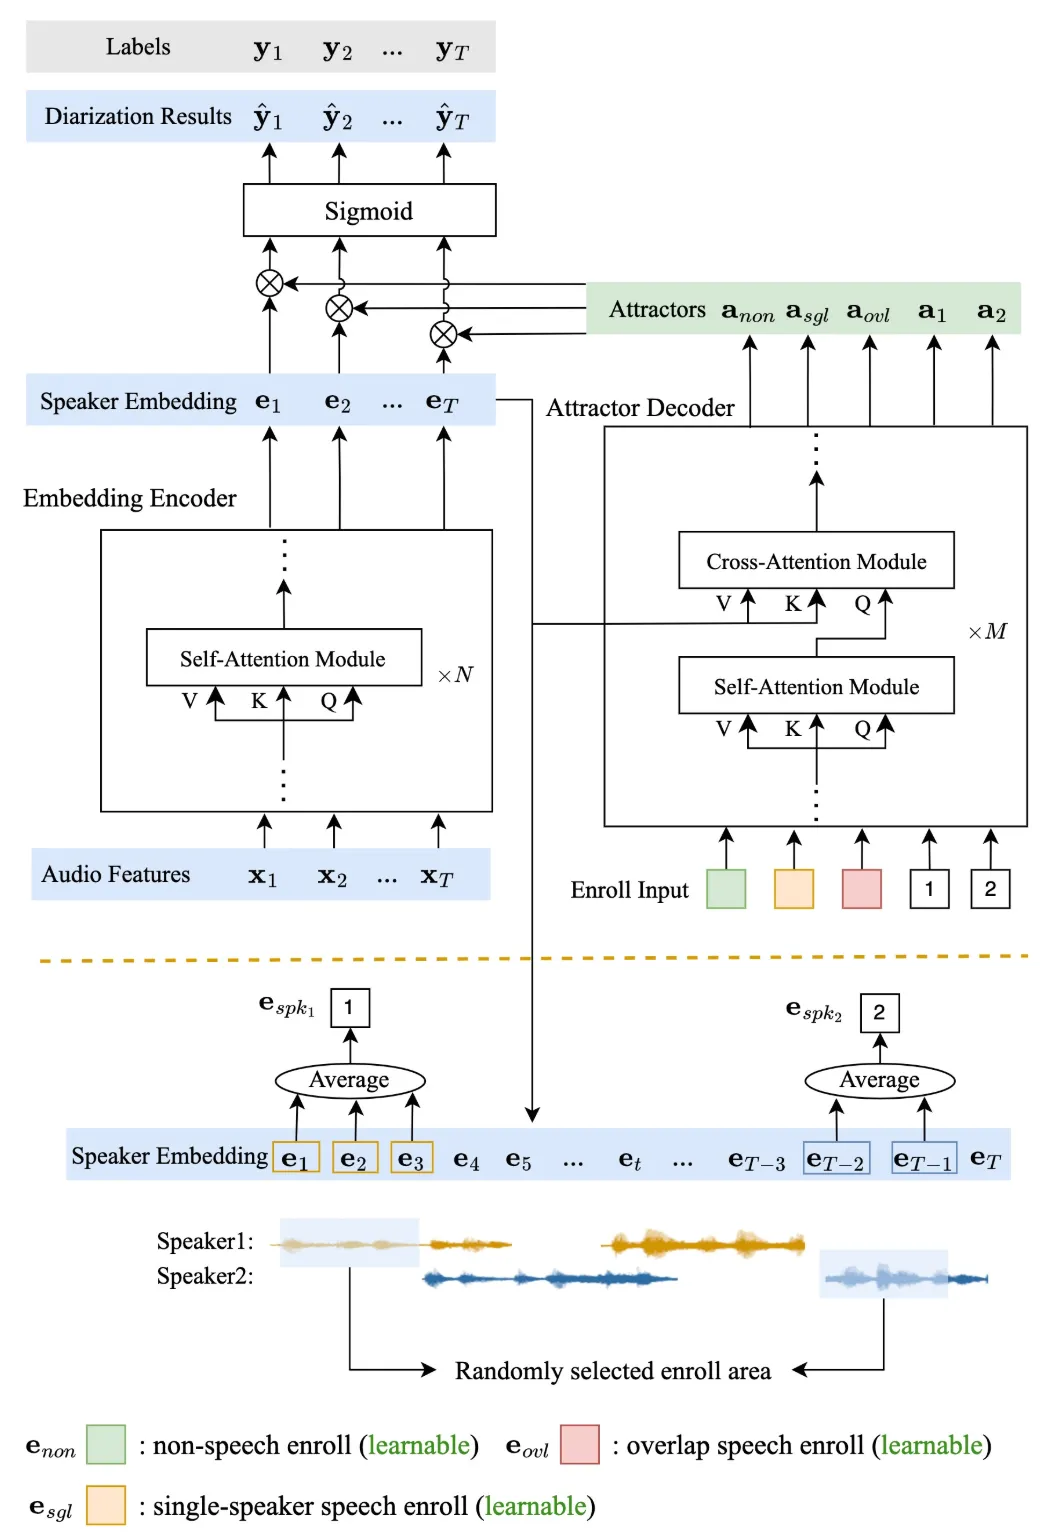
图1 AED-EEND结构示意图
帧级别说话人嵌入特征增强模块
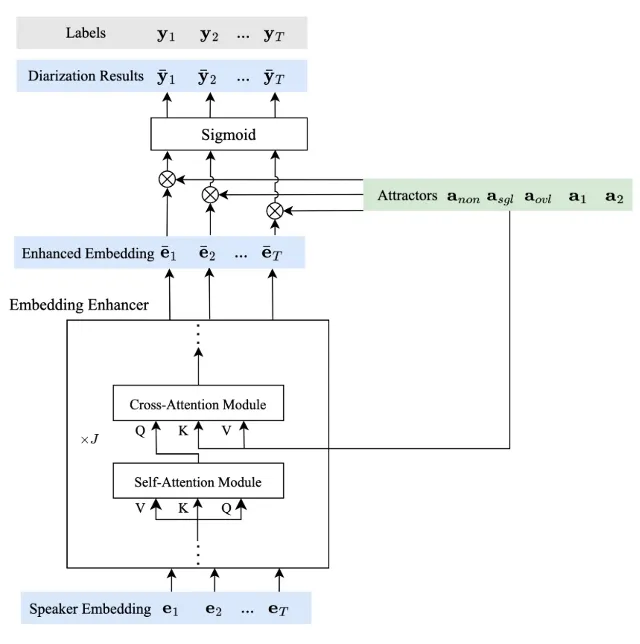
图2:帧级别说话人嵌入特征增强模块
迭代式解码策略
迭代流程总览
在第一次迭代过程中,可以输入图1中的single-speaker speech enroll得到 在后续的迭代过程中,可以通过之前未被预测的单人区域减去最新预测结果中的单人区域得到
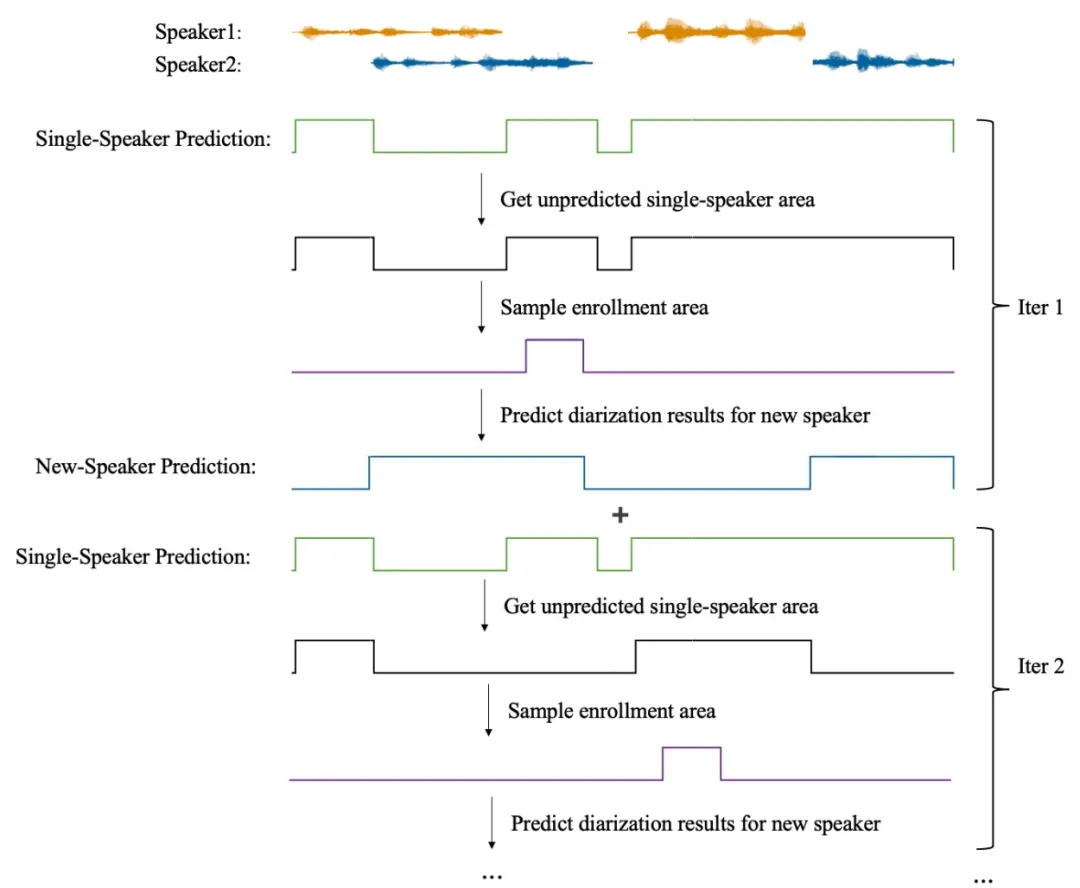
图3 迭代式解码策略
注册区域采样策略
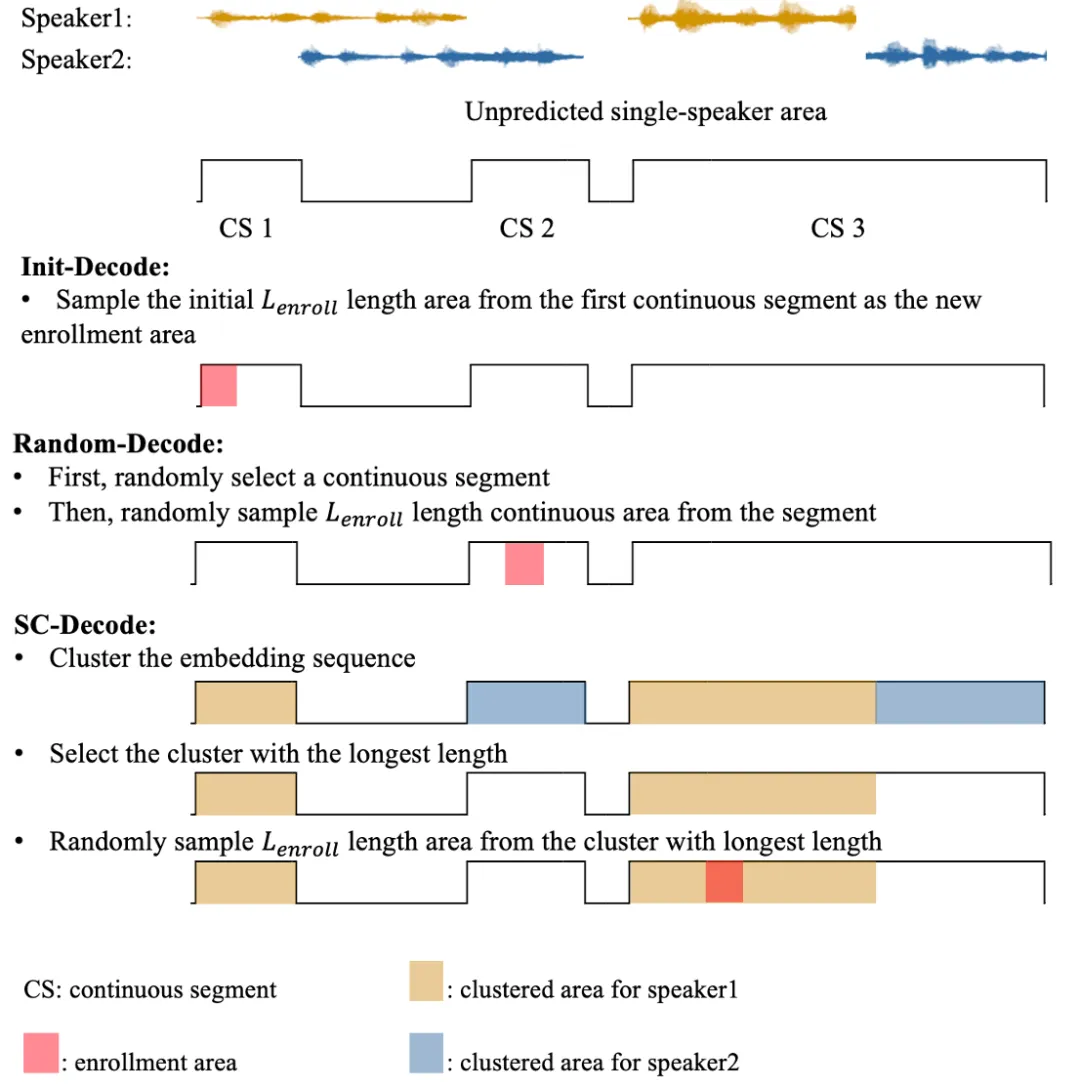
图4 注册区域采样策略
迭代式解码停止策略
实验
实验数据以及配置
仿真数据
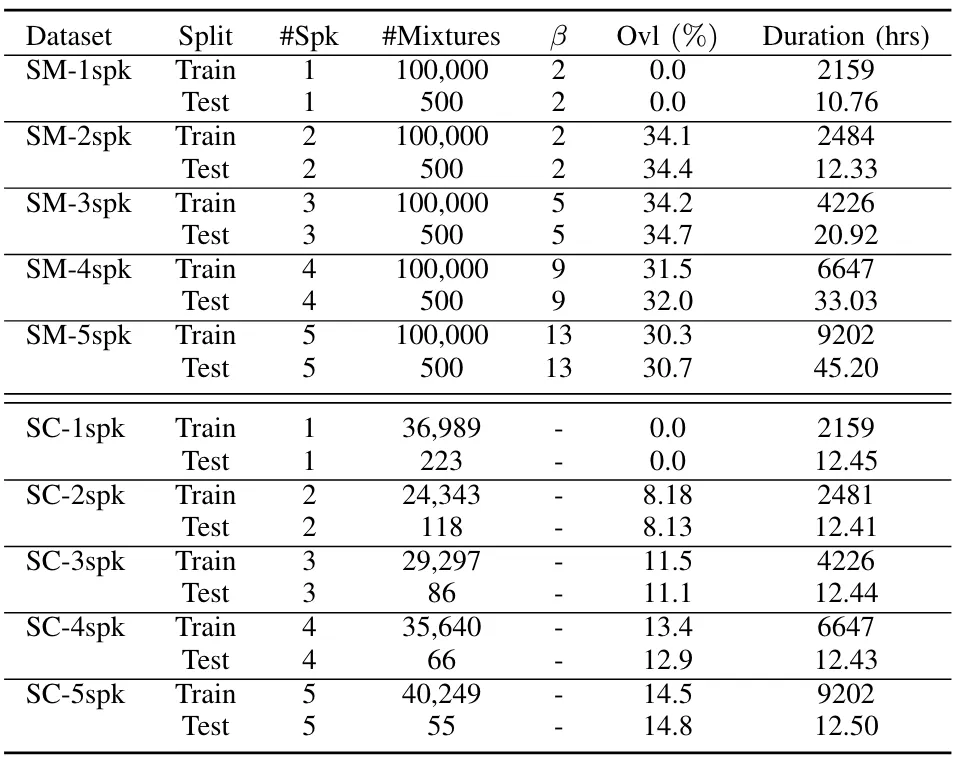
表1 仿真数据
真实数据
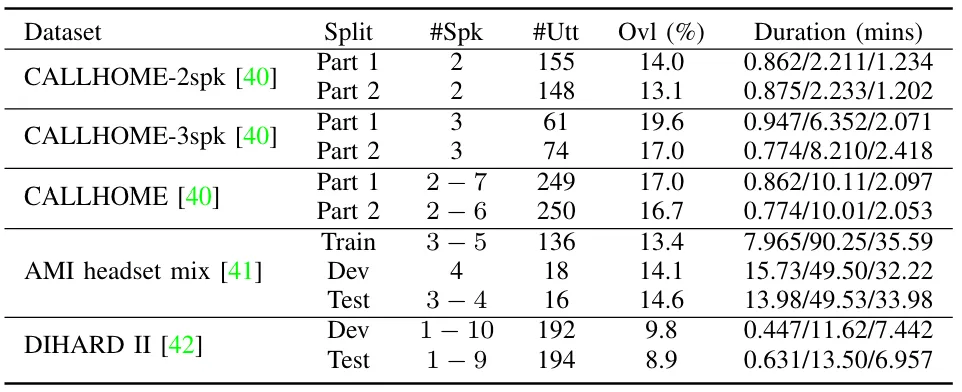
表2 真实数据
实验结果
不同的预测解码策略比较
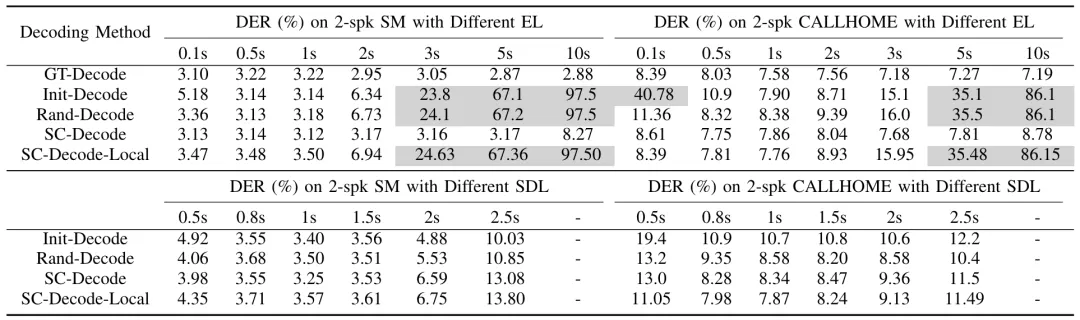
表3 不同的解码策略比较
固定说话人个数情况的结果比较
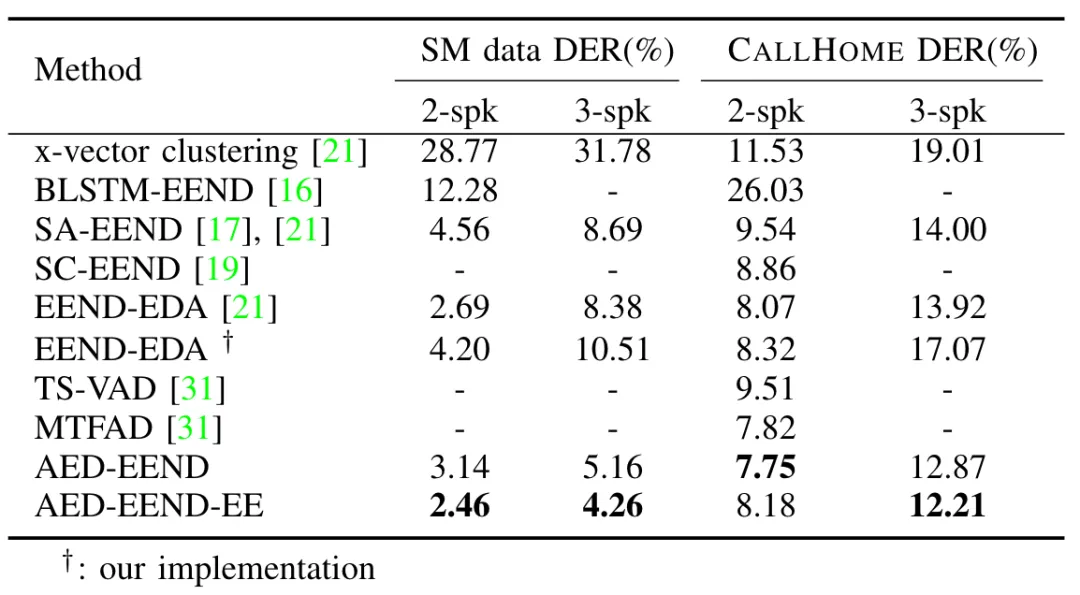
表4 固定说话人个数情况下的结果比较
不定说话人个数情况的结果比较
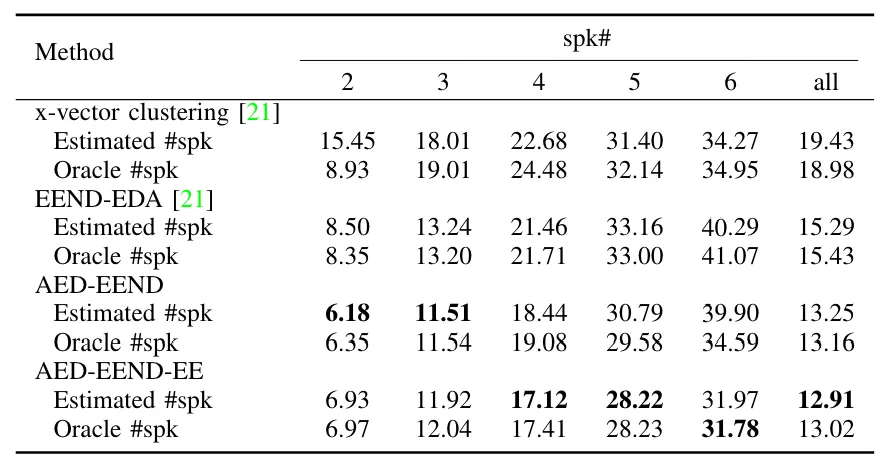
表5 不定说话人个数情况下CALLHOME数据集上的结果对比
训练收敛速度比较
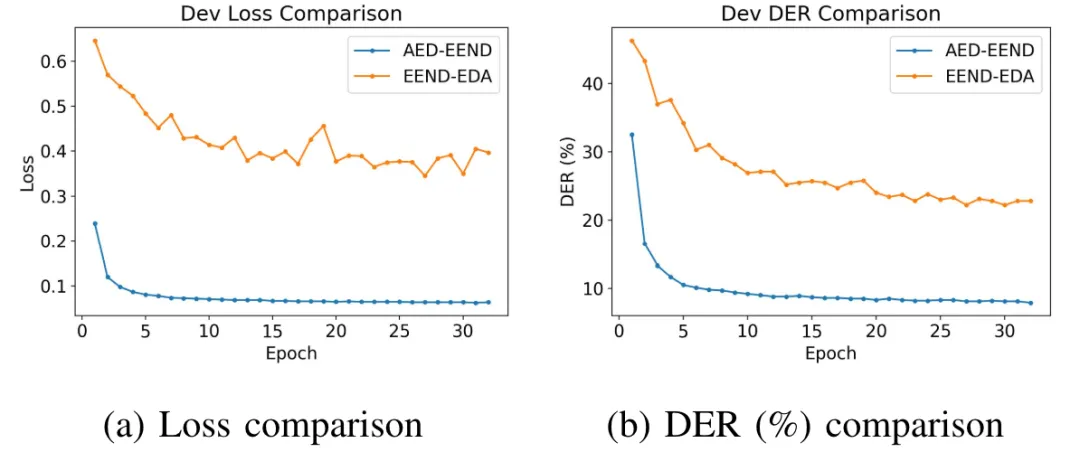
图5 收敛速度比较
使用不同类型仿真数据的比较
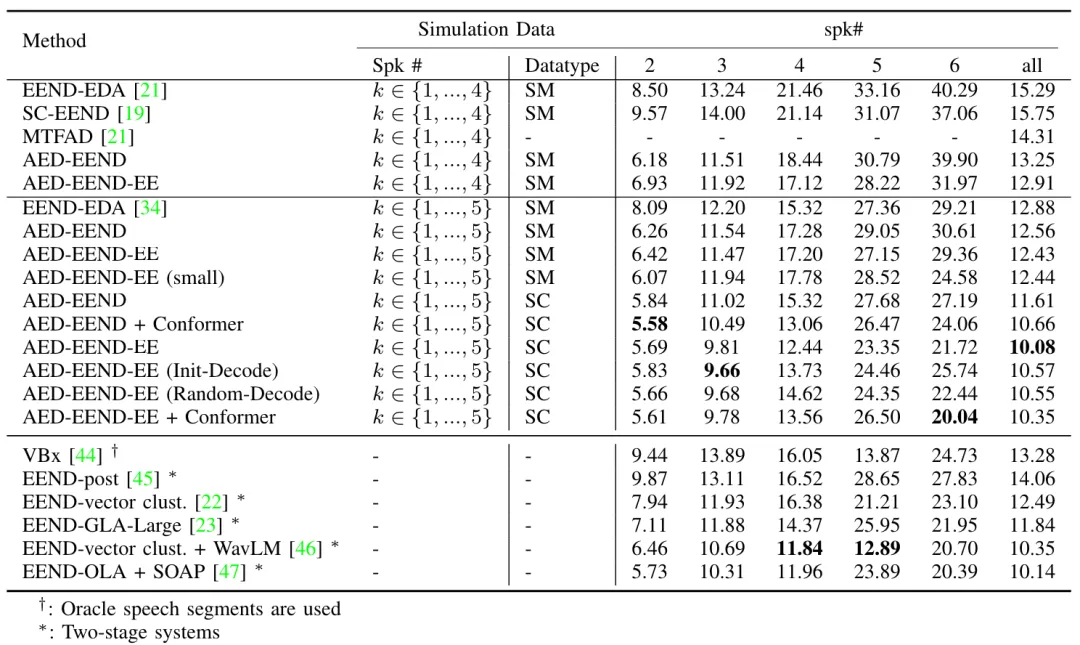
表6 CALLHOME数据集上不同系统的结果比较
其他真实数据集上的性能测试
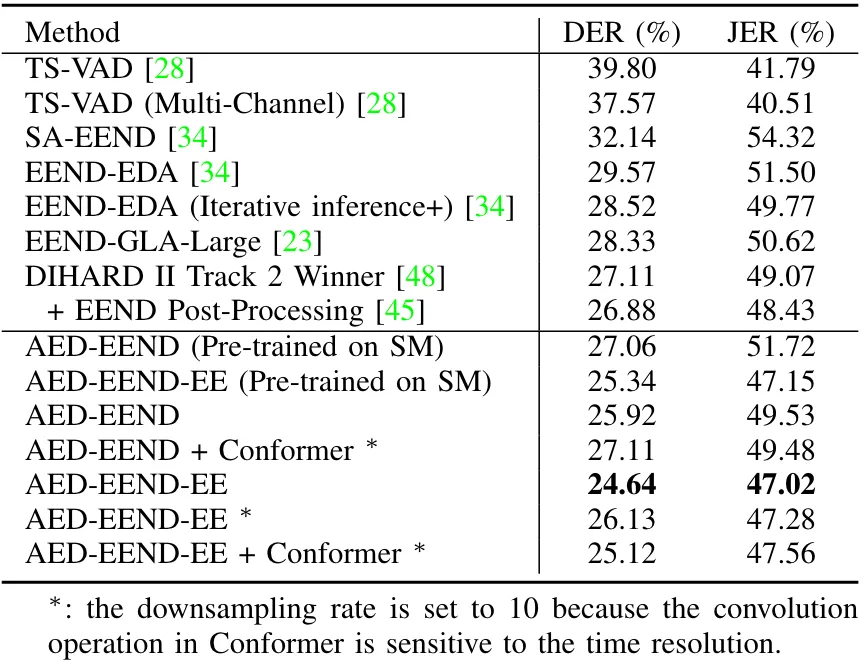
表7 DIHARDII数据集上不同系统的结果比较
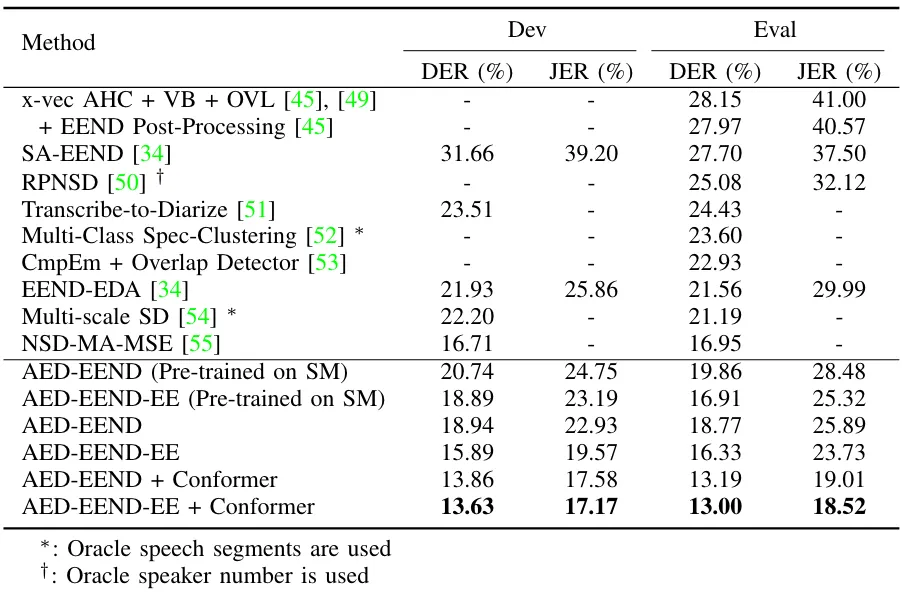
表8 AMI数据集上不同系统的结果比较
AED-EEND系统在语音类型检测任务上的表现
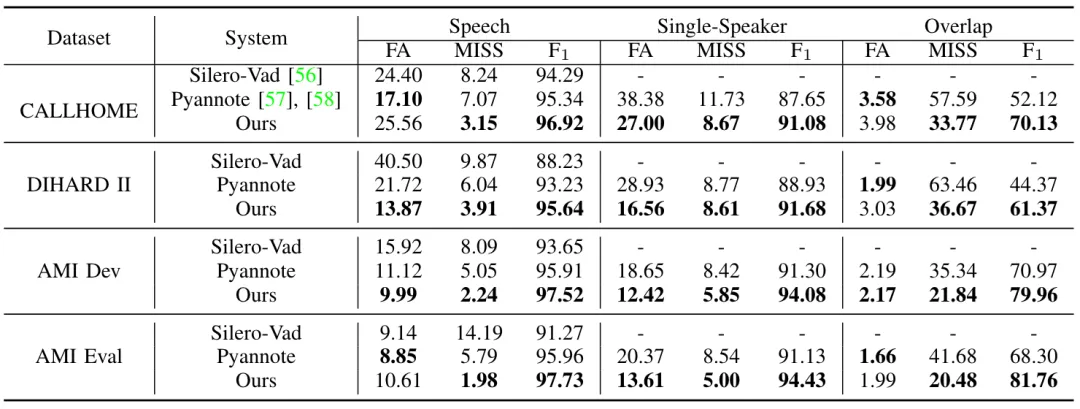
表9 AED-EEND系统在语音类检测任务上的性能比较
总结
[1] I. Medennikov, M. Korenevsky, T. Prisyach, Y. Khokhlov, M. Korenevskaya, I. Sorokin, T. Timofeeva, A. Mitrofanov, A. Andrusenko, I. Podluzhny, A. Laptev, and A. Romanenko, “Target-Speaker Voice Activity Detection: A Novel Approach for Multi-Speaker Diarization in a Dinner Party Scenario,” in Proc. Interspeech 2020, 2020, pp. 274– 278.
[2] Y. Fujita, N. Kanda, S. Horiguchi, K. Nagamatsu, and S. Watanabe, “End-to-End Neural Speaker Diarization with Permutation-Free Objectives,” in Proc. Interspeech 2019, 2019, pp. 4300–4304.
[3] Y. Fujita, N. Kanda, S. Horiguchi, Y. Xue, K. Nagamatsu, and S. Watanabe, “End-to-end neural speaker diarization with self-attention,” in 2019 IEEE Automatic Speech Recognition and Understanding Workshop (ASRU). IEEE, 2019, pp. 296–303.
[4] S. Horiguchi, Y. Fujita, S. Watanabe, Y. Xue, and K. Nagamatsu, “End-to-End Speaker Diarization for an Unknown Number of Speakers with Encoder-Decoder Based Attractors,” in Proc. Interspeech 2020, 2020, pp. 269–273.
[5] S. Horiguchi, Y. Fujita, S. Watanabe, Y. Xue, and P. Garcia, “Encoder-decoder based attractors for end-to-end neural diarization,” IEEE/ACM Transactions on Audio, Speech, and Language Processing, vol. 30, pp. 1493–1507, 2022.
[6] F. Landini, A. Lozano-Diez, M. Diez, and L. Burget, “From Simulated Mixtures to Simulated Conversations as Training Data for End-to-End Neural Diarization,” in Proc. Interspeech 2022, 2022, pp. 5095–5099.
