
 西工大音频语音与语言处理研究组
语音转换 (Voice Conversion) 旨在保留语音中语言内容信息的同时,将源说话人音色转变为目标说话人的音色。越来越多的应用场景,如直播、视频会议等实时通信(RTC)应用中要求语音转换能够实时进行,而目前常见的语音转换模型以整段音频为输入进行转换,难以满足实时低延迟需求。在前作DualVC中,我们实现了一个双模语音转换系统实现流式转换,但仍存在稳定性、运算效率问题。
近期,西工大音频语音与语言处理研究组(ASLP@NPU)和网易伏羲合作论文“DualVC 2: Dynamic Masked Convolution for Unified Streaming and Non-Streaming Voice Conversion”被语音研究顶级会议ICASSP 2024接收。该论文提出了基于动态掩蔽卷积的双模语音转换模型—DualVC 2,一个模型实现流式与整段推理(非流式)两种转换模式的同时,相比先前版本大幅提升了模型鲁棒性与运算效率。现对该论文进行简要的解读和分享。
论文题目:DualVC 2: Dynamic Masked Convolution for Unified Streaming and Non-Streaming Voice Conversion
合作单位:网易伏羲
作者列表:宁子谦,姜月鹏,王帅,朱鹏程,姚继珣,谢磊,毕梦霄
论文原文:https://arxiv.org/abs/2309.15496
样例网址:https://dualvc.github.io/dualvc2/
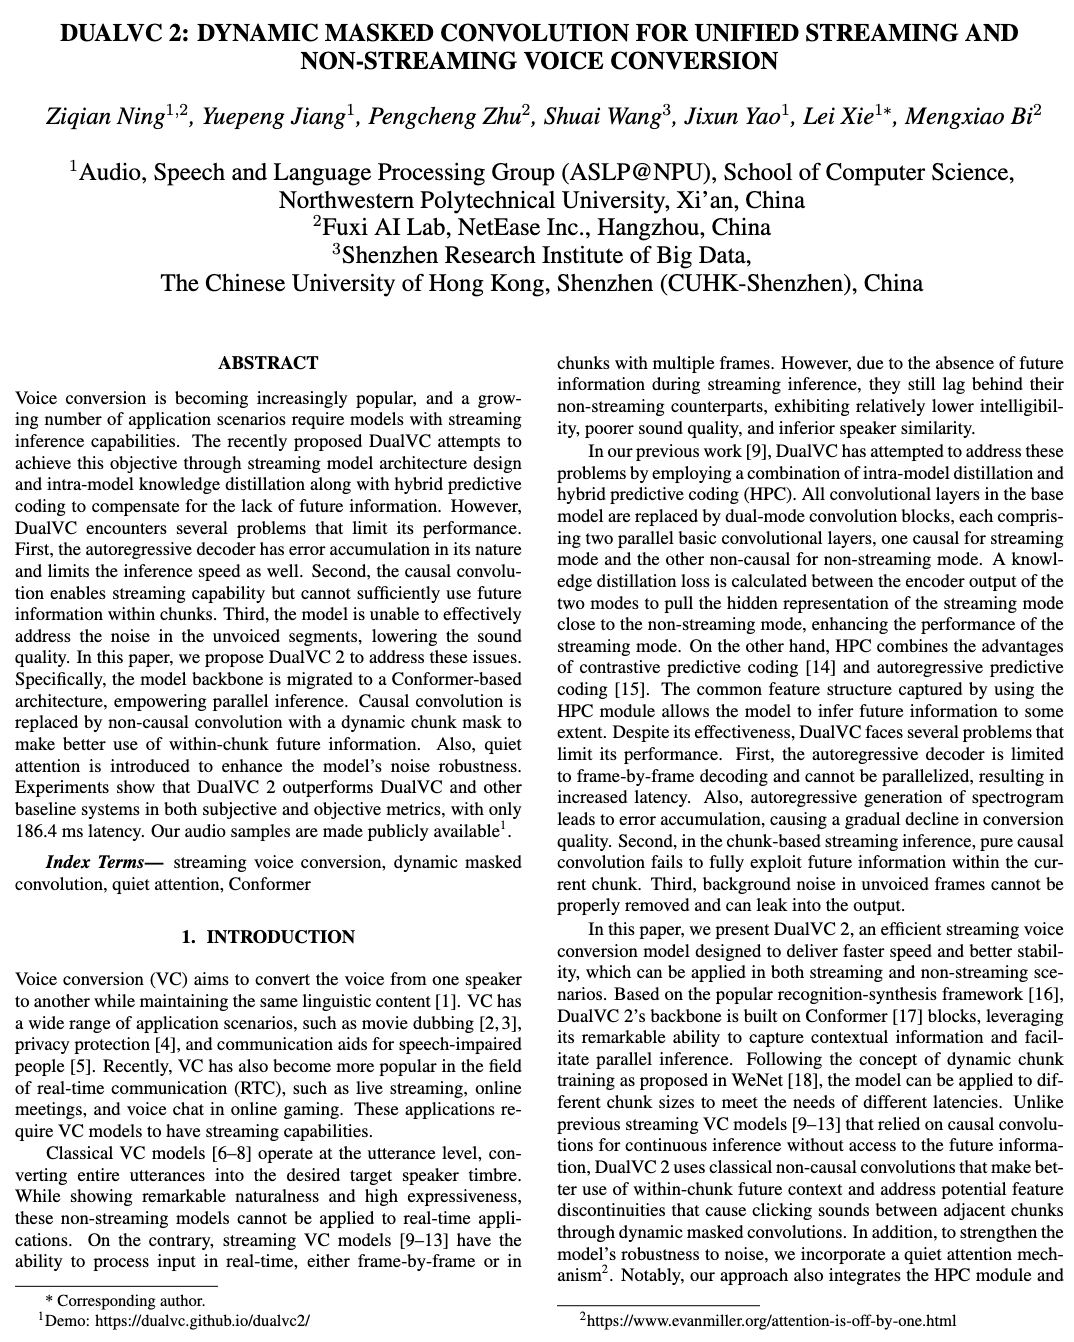
语音转换(Voice Conversion, VC)是一种在不改变语言信息的同时改变说话人音色的技术[1]。虽然当前主流VC模型展示出了出色的转换效果,但大多需要整句或整段语音作为输入,无法应用于实时应用场景。相比之下,尽管流式语音转换(Streaming VC)模型得到了越来越广泛的关注,但与非流式模型相比,其转换效果仍然不足。这主要是相比于整句音频输入,模型无法获取到足够的未来信息,信息缺失导致了转换效果下降,具体表现为可懂度低、音质差和说话人相似度低等问题。
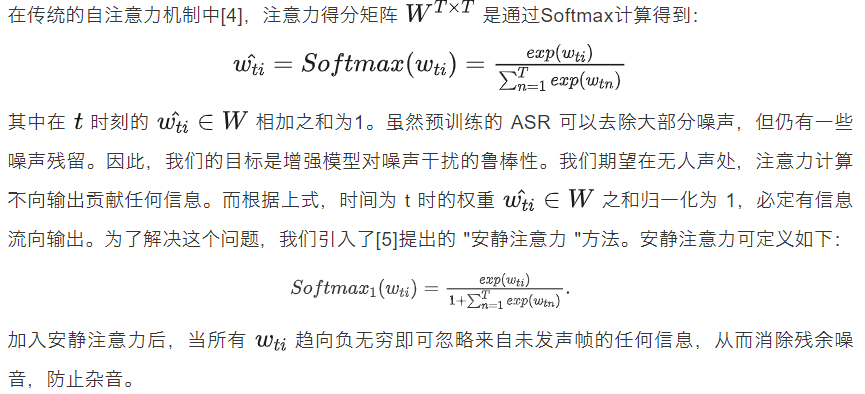
我们先前提出的 DualVC[2] 试图通过流式模型架构设计和模型内知识蒸馏以及混合预测编码来弥补未来信息的不足,从而实现这一目标。然而DualVC 存在以下几个问题。首先,自回归解码器具有误差累积的特性,也限制了推理速度。其次,因果卷积实现了流式推理能力,但无法充分使用chunk内的未来信息。第三,该模型无法有效处理无人声段中的噪声,从而降低了整体音质。为此,本文提出了 DualVC 2 来解决这些问题。具体来说,我们将模型主干结构迁移到基于 Conformer 的架构上,从而实现并行推理。以带有动态chunk掩码的非因果卷积取代因果卷积,更好地利用块内的未来信息。此外还引入了安静注意力(quite attention)机制,以增强模型的噪声鲁棒性。实验表明,DualVC 2 在主观和客观指标上均优于 DualVC 和其他基线系统,延迟时间仅为 186.4 毫秒。
Interspeech2023 | DualVC—基于模型内蒸馏与混合预测编码的双模语音转换模型
流式结构
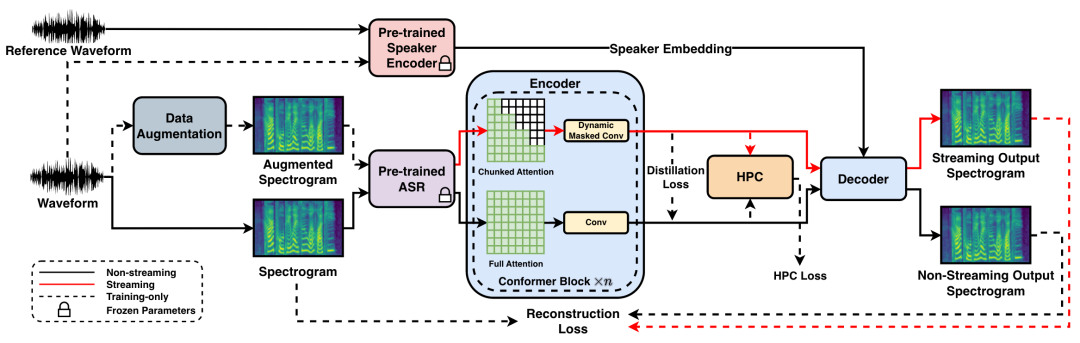
作为一种双模模型,DualVC 2 既能在非流模式下进行整句转换,也能在流式模式下进行有限上下文转换。为此,我们采用了 [3] 中提出的动态chunk训练 (dynamic chunk training, DCT)。DCT 的想法是通过对每个自我注意力层的注意力分数矩阵应用动态chunk掩码来动态改变chunk的大小。在训练过程中,使用完整序列的几率为 50%,其余情况下,chunk大小在 1(= 12.5 毫秒)和 20(= 250 毫秒)之间随机变化。按照我们前作中的设计, DualVC 2也使用双模卷积,它由两个并行的基本卷积层组成,分别用于流式模式和非流式模式。与 DualVC 不同的是,因果卷积层被带有动态掩码的非因果卷积所取代,这将在下一节中介绍。与 DCT 一致,双模卷积在使用全序列输入时设置为非流式模式,而在使用随机块输入时设置为流式模式。
动态掩蔽卷积
流式模型经常采用因果卷积,在训练过程中限制模型感受野,与推理过程对齐。然而对于以chunk为单位的流式模型,因果卷积使模型无法充分利用块内的未来上下文信息,从而导致性能下降。为了解决这个问题,我们提出了动态屏蔽卷积(dynamic masked convolution, DMC),这是一种全新的卷积输入动态掩蔽策略。其动机是增强非因果卷积对未来信息变化的鲁棒性,使其能够连续生成输出特性,而不会在相邻chunk之间产生“咔哒声”。在训练过程中,在每个卷积操作中,代表内核感受野中未来信息的最后 n 帧被掩蔽为0,其中
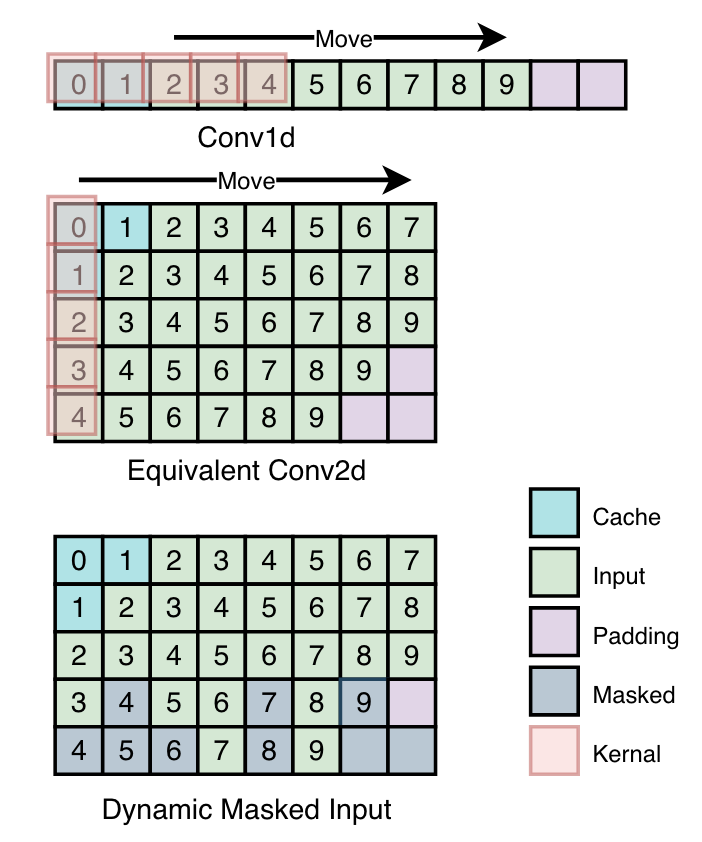
图4 动态掩蔽卷积
安静注意力
数据增广
与训练数据集中的干净语音相比,实际语音的录音环境明显更加复杂,存在背景噪音和混响。此外,训练数据中的说话方式主要是朗读,而实际对话的节奏明显比训练数据要快,因此在保持模型可懂度方面存在挑战。为了解决这个问题,我们采用了数据增广策略。首先,我们利用 MUSAN 噪音数据集 [6],通过直接相加的方式进行噪音增广。随后,我们引入了随机混响和语速增广。所有这些增广都是通过开源工具 WavAugment 完成的。
实验数据:AISHELL 3[7],包含来自218个说话人的88,035条数据。
对比系统
IBF-VC[8]:预训练教师模型指导学习的流式模型,使用中间层表征
DualVC[2]:前作方案
DualVC 2:本文方案
主观测试
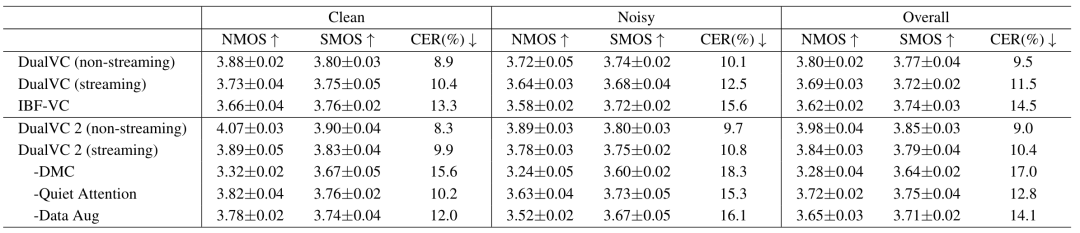
从表1可以看出,DualVC 2 在流式模式下已经超越了前作的非流式模式效果,同时也超越了baseline IBF-VC。在噪声场景下效果并未明显下降,证明其优秀的噪声鲁棒性。消融实验中去除DMC、安静注意力和数据增广均导致了不同程度的效果下降,证明提出方法的有效性。
客观测试
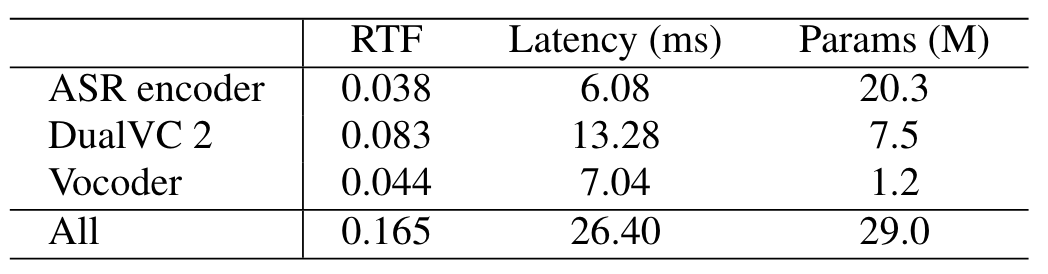
词错误率:使用语音识别模型分别对于各个模型生成的语音进行识别并计算词错误率。与主观测试结论相同,在流式与非流式场景下,DualVC 2 全面超越了baseline模型。 计算效率:我们考虑了三个主要指标:实时性(RTF)、延迟和参数量,结果如表2所示。模型整条链路RTF为0.165,参数量为29.0M。延迟计算公式为
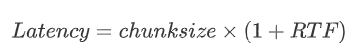
表2 计算与实时性指标
[1] Berrak Sisman, Junichi Yamagishi, Simon King, and Haizhou Li, “An overview of voice conversion and its challenges: From statistical modeling to deep learning,” IEEE ACM Trans. Audio Speech Lang. Process., vol. 29, pp. 132–157, 2021.
[2]Ziqian Ning, Yuepeng Jiang, Pengcheng Zhu, Jixun Yao, Shuai Wang, Lei Xie, and Mengxiao Bi, “Dualvc: Dual-mode voice conversion using intra-model knowledge distillation and hybrid predictive coding,” in Proc. INTERSPEECH. 2023, pp. 2063–2067, ISCA.
[3] Zhuoyuan Yao, Di Wu, Xiong Wang, Binbin Zhang, Fan Yu, Chao Yang, Zhendong Peng, Xiaoyu Chen, Lei Xie, and Xin Lei, “Wenet: Production oriented streaming and nonstreaming end-to-end speech recognition toolkit,” in Proc. INTERSPEECH. 2021, pp. 4054–4058, ISCA.
[4] Ashish Vaswani, Noam Shazeer, Niki Parmar, Jakob Uszkoreit, Llion Jones, Aidan N. Gomez, Lukasz Kaiser, and Illia Polo- sukhin, “Attention is all you need,” in Proc. NeurIPS, 2017, pp. 5998–6008.
[5] Evan Miller, "Attention Is Off By One",
https://www.evanmiller.org/attention-is-off-by-one.html
[6] David Snyder, Guoguo Chen, and Daniel Povey, “MUSAN: A music, speech, and noise corpus,” CoRR, vol. abs/1510.08484, 2015.
[7] Yao Shi, Hui Bu, Xin Xu, Shaoji Zhang, and Ming Li, “AISHELL-3: A multi-speaker mandarin TTS corpus,” in Proc. INTERSPEECH. 2021, pp. 2756–2760, ISCA.
[8] Yuanzhe Chen, Ming Tu, Tang Li, Xin Li, Qiuqiang Kong, Jiaxin Li, Zhichao Wang, Qiao Tian, Yuping Wang, and Yuxuan Wang, “Streaming voice conversion via intermediate bottleneck features and non-streaming teacher guidance,” CoRR, vol. abs/2210.15158, 2022.
