
 语音小管家
分享 NVIDIA 基于 GPU 的 TTS 解决方案介绍。
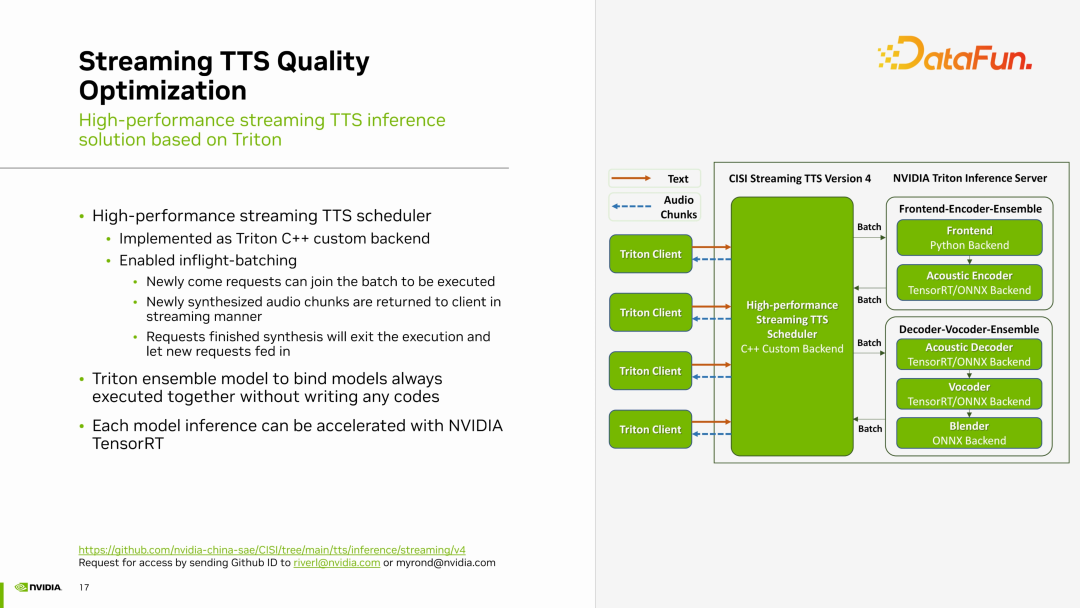
NVIDIA 在 TTS 领域也做了一些供大家参考的工作,例如提供了高效的流式 TTS 部署方案,利用 TensorRT 加速模型推理速度,并通过 Triton Inference Server 实现了高效的流水线。今年,我们对流式 TTS 的效果进行了提升,主要集中在两个方面。
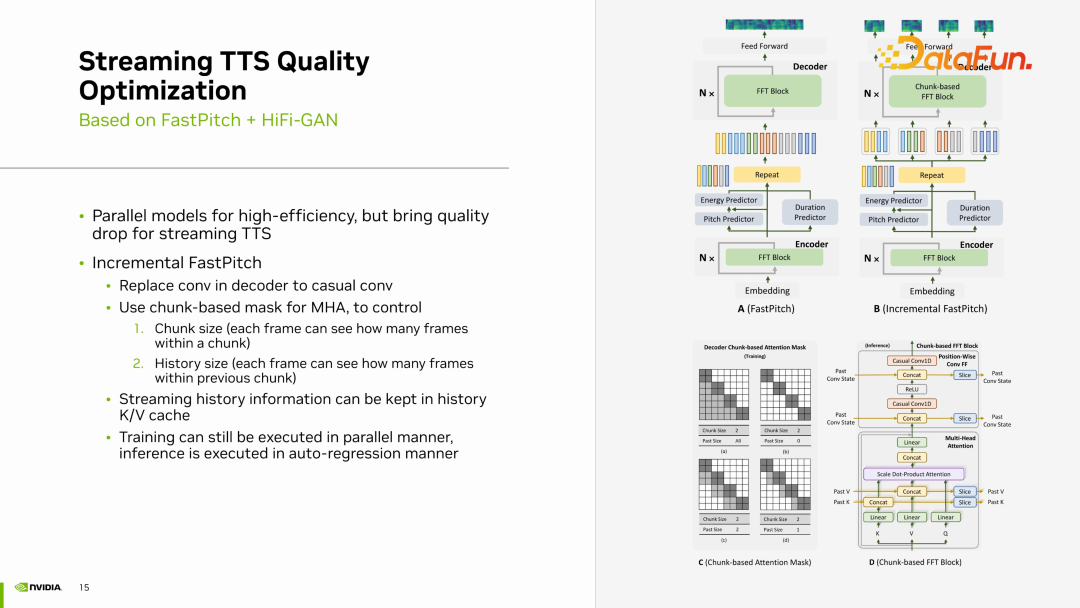
首先我们发现许多 TTS 模型采用并行模型,其结构通常是非自回归的,并使用卷积等网络层一次性生成所有音频帧。然而,这种并行模型并不适合流式 TTS 合成。尤其在 chunk 之间的接缝处可能存在抖动瑕疵。因此,我们引入了一种Incremental FastPitch的方法,将完全并行的 FastPitch 转换为基于 chunk 的 FastPitch。通过使用casual 卷积替代常规普通卷积,并采用基于 chunk 的 mask MultiHeadAttention,可以控制 chunk size 和 history size。这种 Mask 使得每个 chunk 内的帧不仅可以看到 chunk 内的其他帧,还能够看到之前 chunk 的帧,通过这种方式实现了基于 chunk 的 FastPitch 并且使得 chunk 之间的信息可以互相关联提升流式 TTS 的质量。Incremental FastPitch 的训练过程仍然可以利用带 mask 的注意力机制来实现并行运算。在推理过程中,可以逐个 chunk 地生成,实现类似迭代的自回归生成过程,从而在流式生成中考虑到历史信息,提升生成效果。
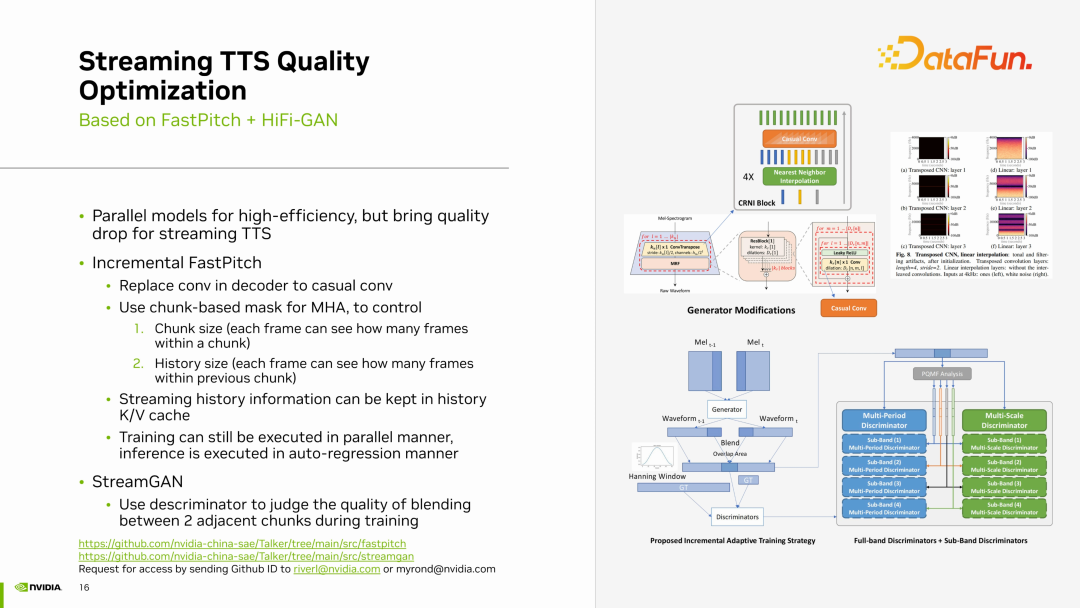
其次我们采用了 stream GAN 逻辑,即在 Hifi GAN 的训练中,利用 discriminator 强制学习如何让 Generator 生成两个能够良好拼接的连续音频 chunk。
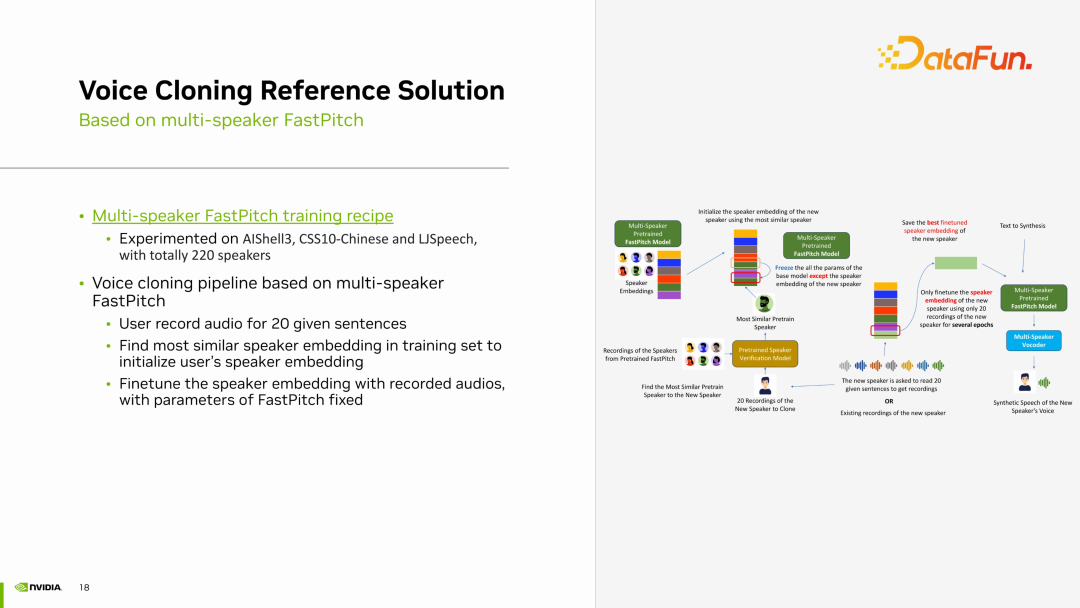
获得了多说话人的 FastPitch 模型后,则可进入声音克隆的 Finetuning 阶段。用户首先录制 20 句话。接着,根据用户的声音在训练集中找到一个与之最相似的 Speaker,用其声音的 embedding 初始化用户的 Speaker Embedding。然后,使用用户上传的 20 句话进 finetuning,保持 FastPitch 不变,对 finetuning Speaker 的 Embedding 进行微调。最终,该模型使用 Multi-speaker FastPitch 生成与用户声音相似的音频效果。
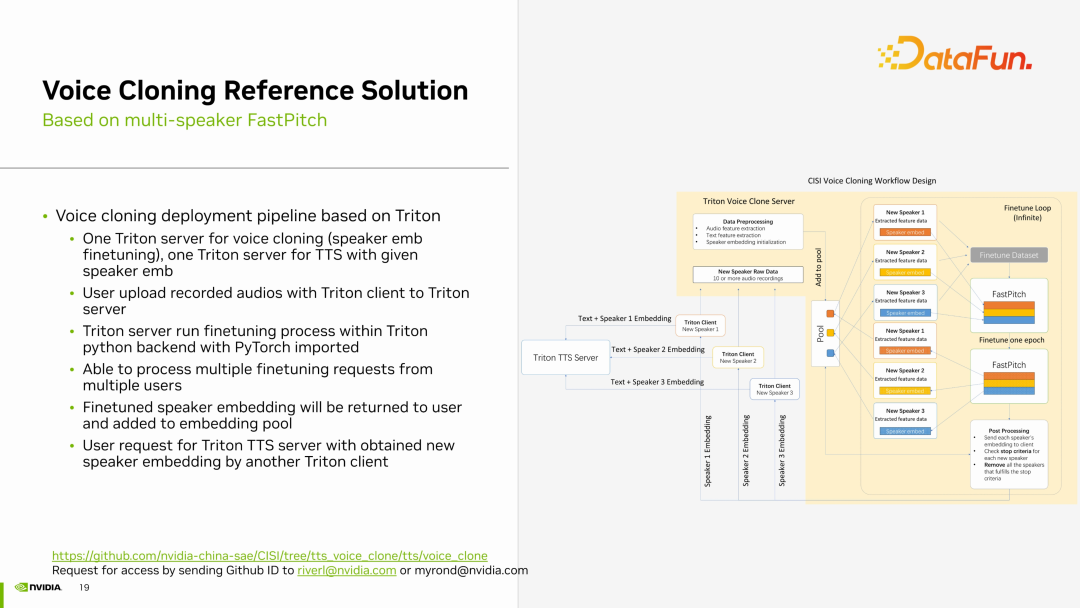
最后,将每个 Speaker 的 Embedding 返回给客户端,并将 finetuning 完成的 Speaker Embedding 存储在 Embedding Pool 中。用户想要生成自己的声音只需获取返回的 Speaker Embedding,并访问我们的 Triton TTS Server,即我们部署的 Multi-speaker TTS 模型。该模型使用 fine-tuning 完成的 Speaker Embedding 生成与用户声音相似的音频。这就是我们的声音克隆工作的流程。
