今天来讲讲如何用AI生成带有中文语音的3秒视频。这是一个振奋人心的时候,因为这就意味着我们可以用AI生成各种短视频,再合并形成一个比较长的视频了。
先说一下流程吧,首先是去网站上生成的3s视频,然后再本地用TTS功能生成中文音频,最后是把上述音频和视频合并(这里关键是中文语音的对口型)。
下面开始详细讲解。
首先呢,打开https://neverends.life这个网页。它这里主要有2个功能:
本文试用了的是Text to Video。各种设置保持不动(Motion默认的是2,下图是改过了的),在屏幕下方的输入框里输入英文的描述词后,直接按回车(或点击旁边的彩色三角)就可以了。
这里说一下,不懂英文也没关系,Chrome有个插件(extension)叫"沉浸式翻译",安装完了以后,输入框里输入中文描述,然后快速按3次空格键,它就能自动帮你把中文翻译成英文,效果还是很不错的。
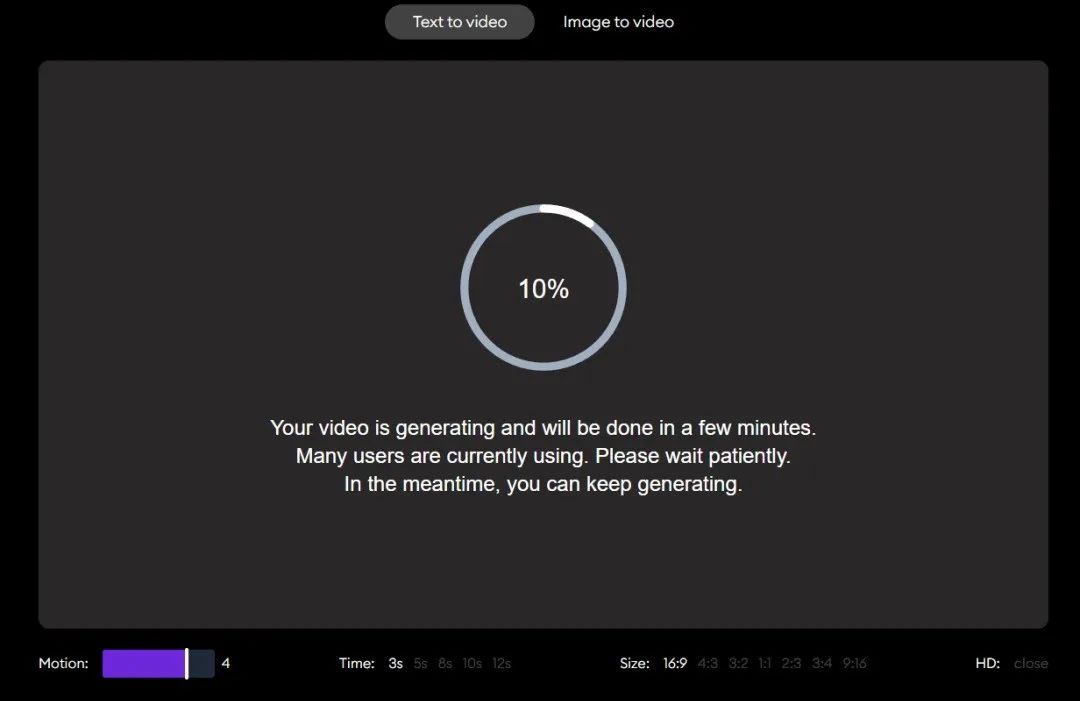
然后画面就显示类似上图的进度条,一般得等个2分钟左右就能出来了。感觉这个速度还是可以的。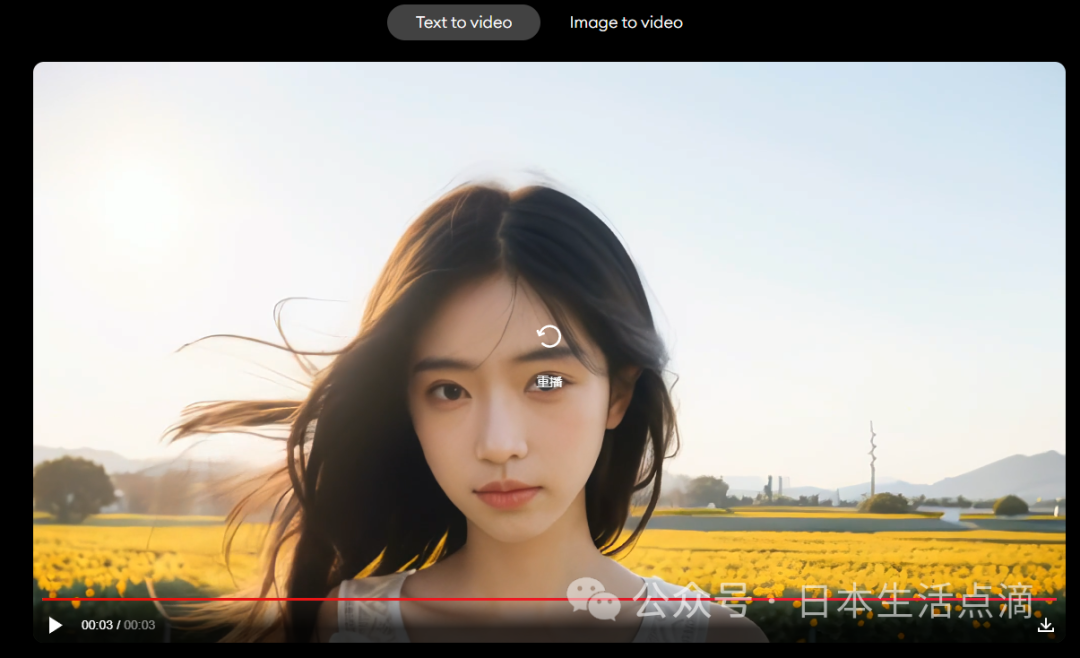
最后生成好了就类似于上面截图这样的。可以下载到本地,文件命名为girl_flowers.mp4。视频如下:画面设置那里,Motion是设置画面能动的地方的动作幅度大小,一般默认为2是比较合适的。改成4后,生成的视频,人物的眼睛有些问题(最后0.5秒的时候,眼睛快速转动,还露出了很多眼白,看起来很怪异)这个网站提供2次试用的机会,一次只能生成3s的视频,想要更长时间的视频,或者超过试用次数都要交费才能用,它包月是15刀,给360个点(猜测是支持生成360条视频),支持根据文字生成15s视频,但根据图生成视频只能是3s。视频下载到本地后,因为这个是没有声音的,给它加一个中文的语音。就是用以前介绍的TTS服务,输入文字,最终生成语音,文件下载到本地后命名为 audio_morning.wav。具体这里就不赘述了,大家可以看以前的文章:利用AI生成语音:本地部署TTS服务最后一步就是要把语音和视频合并,这次用的是SadTalker-Video-Lip-Sync这个开源工具。
从https://github.com/Zz-ww/SadTalker-Video-Lip-Sync上把代码下载到本地后,按照说明(截图如下)把需要的环境建好就可以在命令行使用了。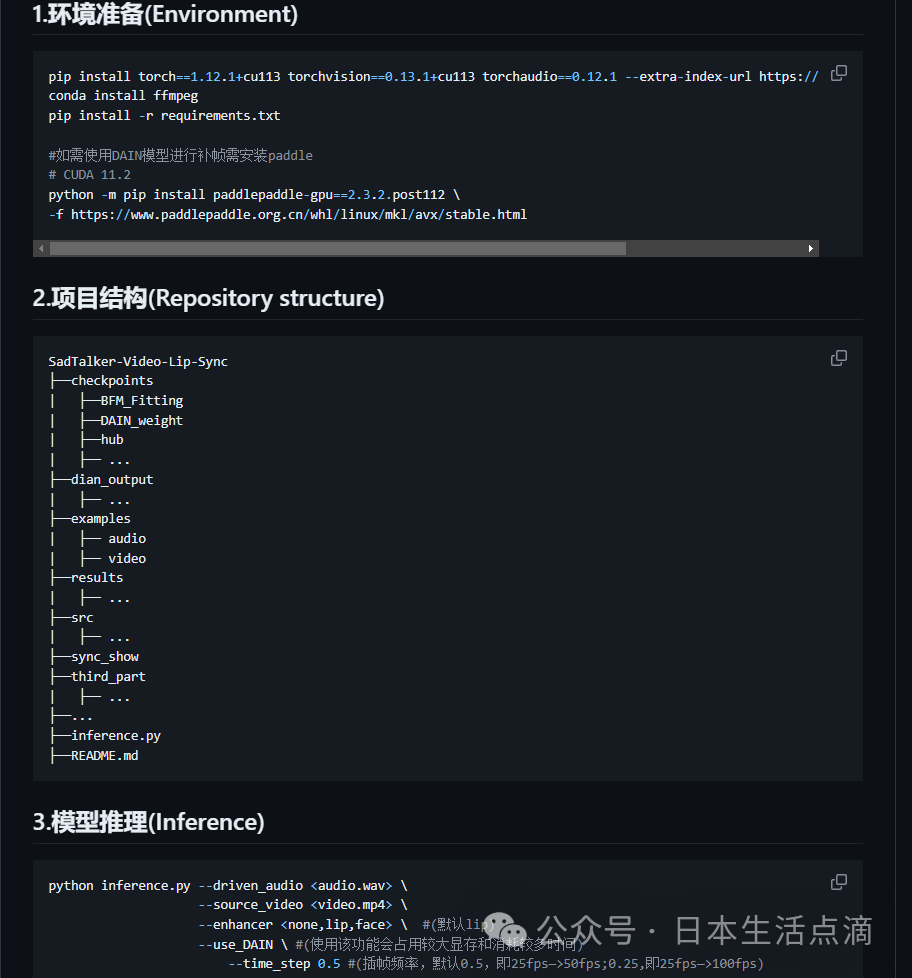
我这里试图使用DAIN模型时报错,说"_gpuDeviceProperties" is already registered!,查了paddlepaddle的github,那边也有人反映这个问题,但目前没有解决方案,所以命令行参数里面没有加这个。最终使用的命令如下:python inference.py --driven_audio scenes\s1\audio_morning.wav --source_video scenes\s1\girl_flowers.mp4 --enhancer lip
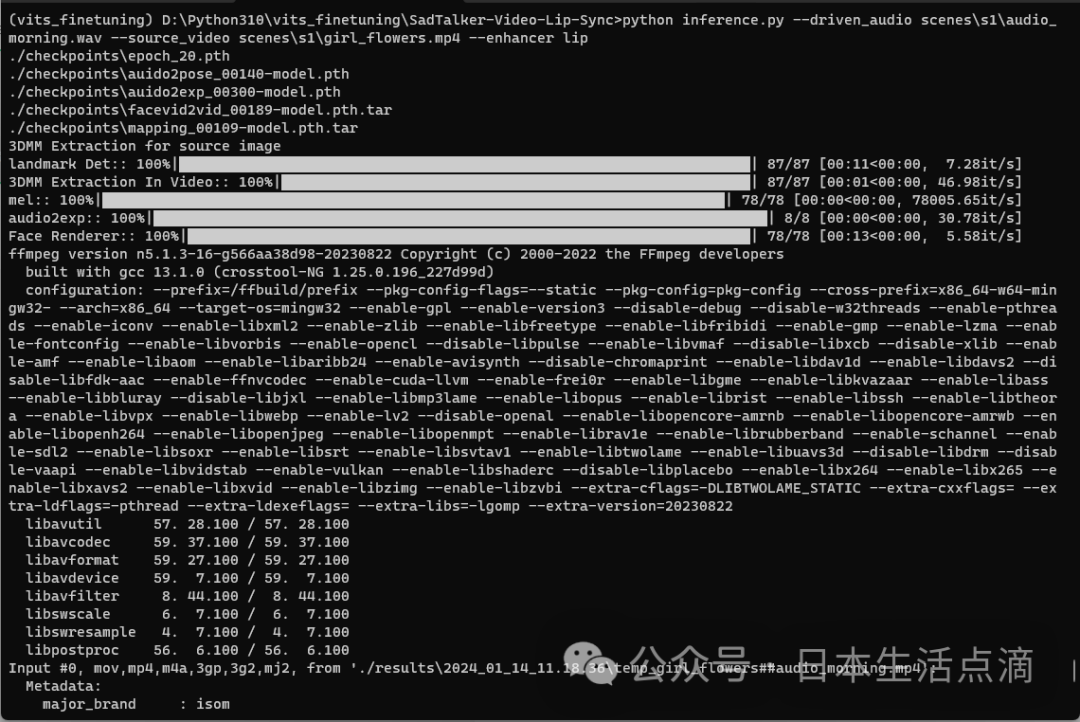
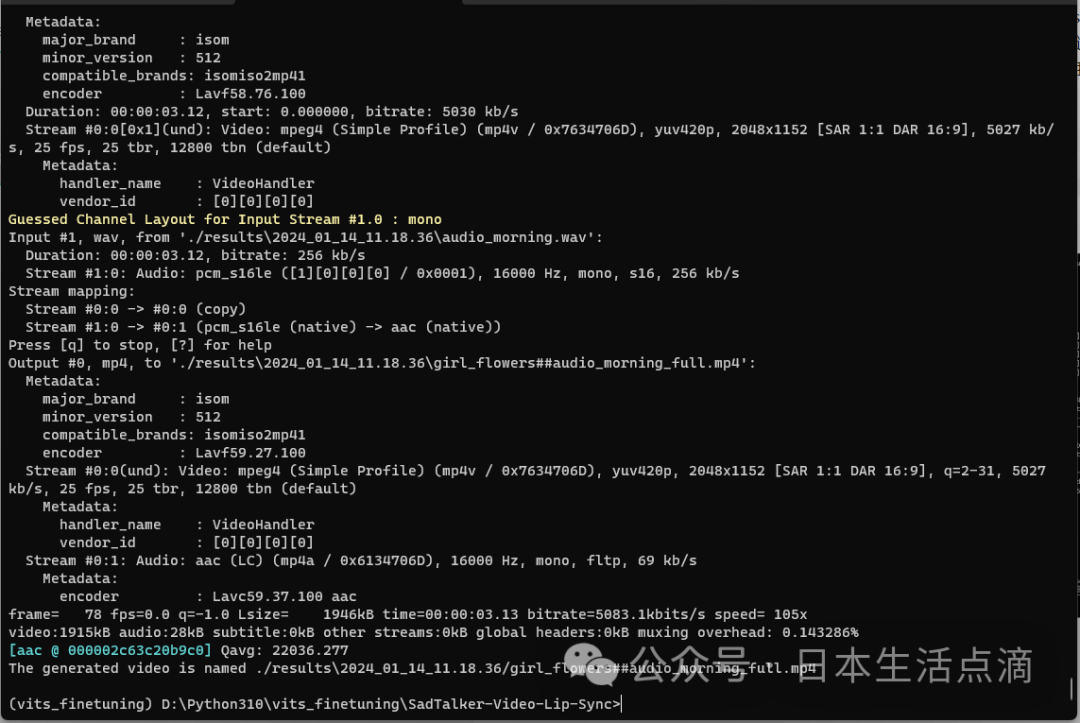
这里可以看到,最终得到的视频文件是girl_flowers##audio_morning_full.mp4 。这个工具目前有个小问题,就是由它处理过的视频,分辨率会下降,已经有人提了Issue。只能期待原作者来对应这个问题了。好了,本期的内容就是这些了。打通了视频生成之后,可以做很多的事情了,比如通过AI制作儿童绘本,甚至是有声读物变现的问题,大家有什么想法吗?
 Noelliroon
