
 THUHCSI人机语音交互实验室
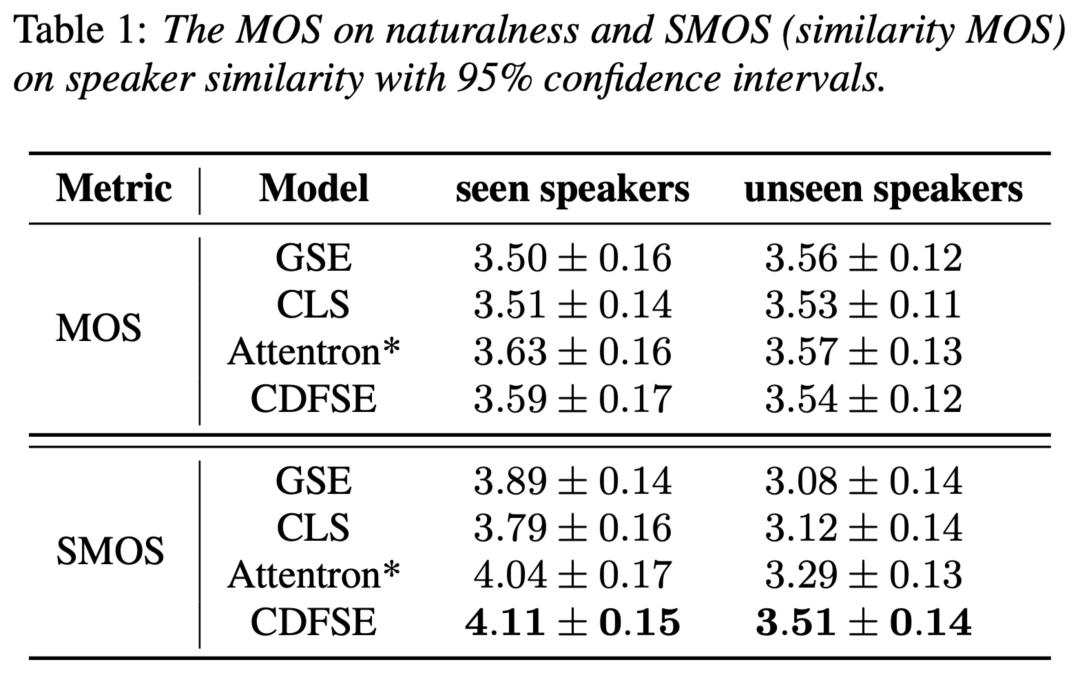
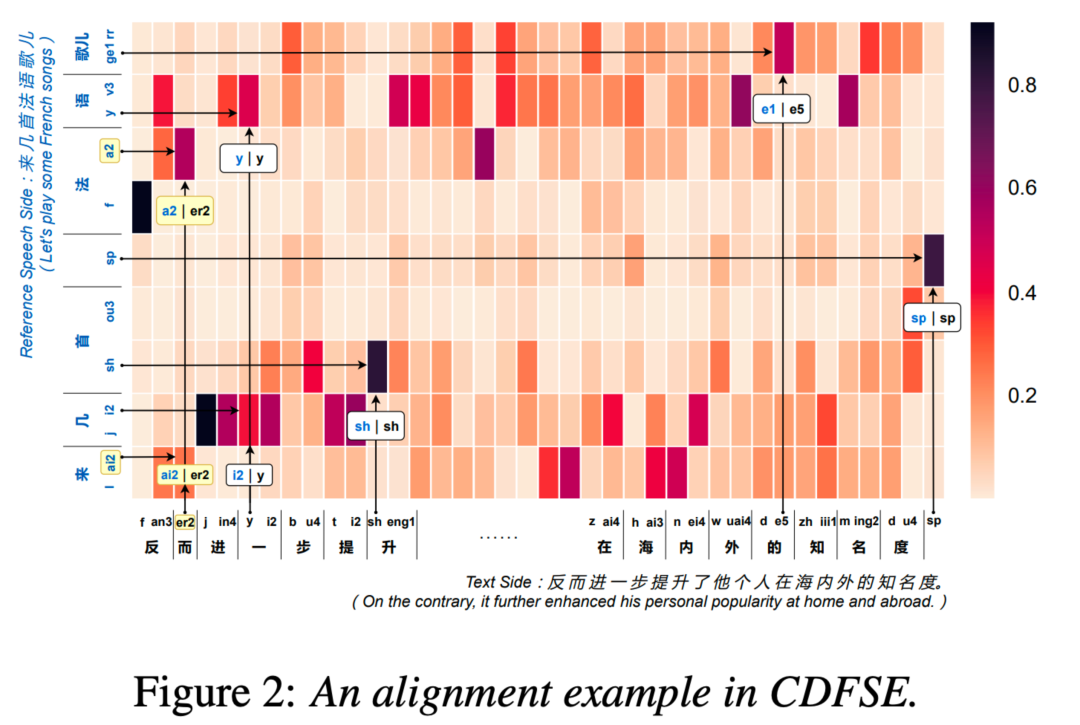
本文由清华大学与腾讯 AI Lab、香港中文大学合作。 零样本说话人自适应(zero-shot speaker adaptation),或称为零样本声音克隆,旨在根据任意一条参考语音(reference speech)合成训练过程中从未见过的说话人(unseen speaker)的声音。 以往的工作大多从参考语音中提取一个固定维度的向量作为说话人表征,该思路虽然能较好地表示说话人的音色、整体说话方式,但其有限且粗粒度的信息限制了对说话人细节发音特点的建模和迁移能力。 针对该问题,本文提出了一种内容相关的细粒度说话人表征(Content-Dependent Fine-Grained Speaker Embedding, CDFSE)方法。 与以往的工作相比,该方法根据输入待合成文本的实际发音内容从参考语音中提取音素级说话人表征序列,代替传统的全局/话语级定长说话人表征,以建模和迁移目标说话人更加细节的声音风格和个人发音习惯。 在 AISHELL-3 中文多说话人数据集上进行实验,主观和客观实验结果均表明所提方法相比于基线模型能够提升合成语音的说话人声音相似度,在未见说话人上效果显著、SMOS有0.2以上的提升。
扫码阅读论文
https://www.isca-speech.org/archive/interspeech_2022/zhou22d_interspeech.html
合成样例试听及开源代码获取
https://thuhcsi.github.io/interspeech2022-cdfse-tts/
01 背景动机
02 贡献
03 解决方案
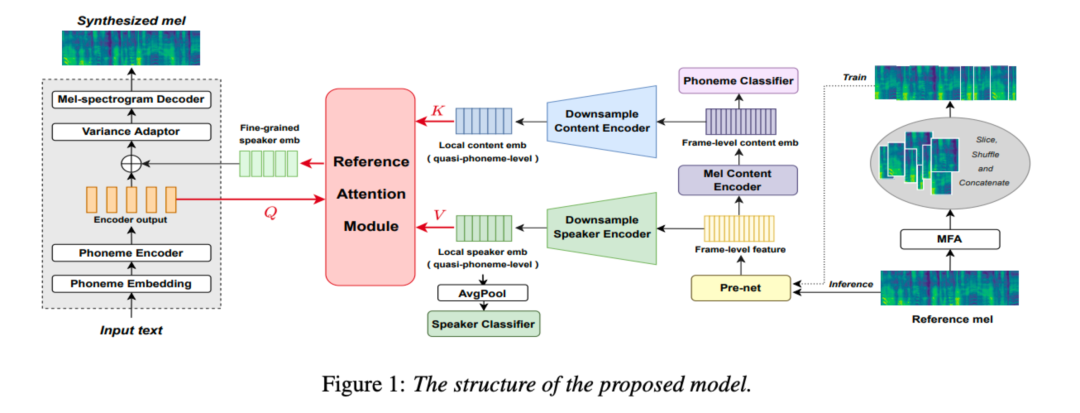
提取局部内容和局部说话人表示
内容相关的参考注意力模块
训练阶段预处理策略
04 实验验证
实验数据
基线模型
GSE:一种类似 GST 的全局说话人嵌入(Global Speaker Embedding)方法,使用一组基底向量和多头自注意机制来无监督地表示从参考语音中提取的说话人嵌入。
CLS:一种结合说话人分类器(Speaker Classifier)的多任务学习或迁移学习方法,为了与所提模型有效对比,我们使用和图1相同的说话人编码器结构,用平均池化操作的结果作为说话人表征向量。
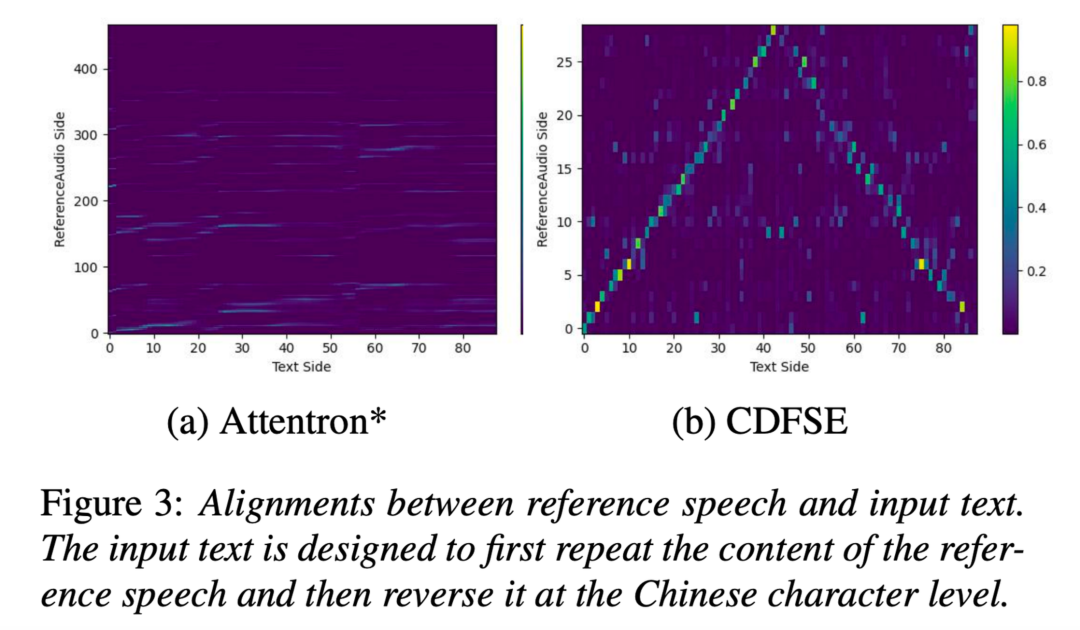
Attentron*:Attentron提出了一种基于注意力的变长嵌入方法。 其原始版本是基于Tacotron 2实现,由一个粗粒度的全局编码器和带有注意力机制的细粒度编码器组成,从参考语音中分别提取话语级和帧级嵌入。 为了公平对比,我们采用原论文中的 Attentron(1-1) 模式,并将其主要实现迁移到FastSpeech 2框架。
主观实验
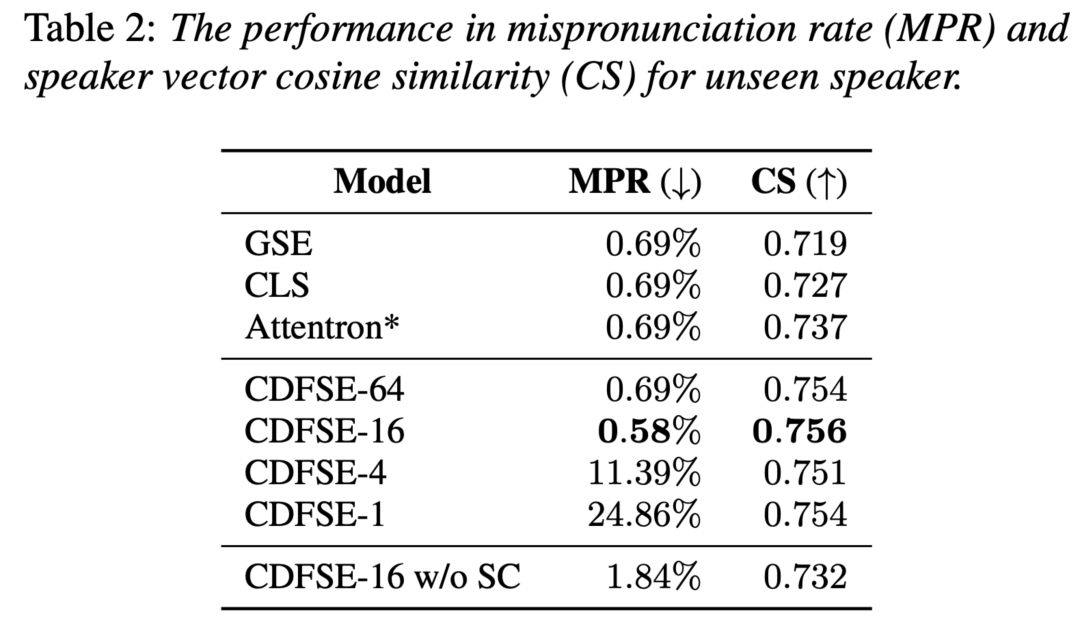
结构探究及消融实验
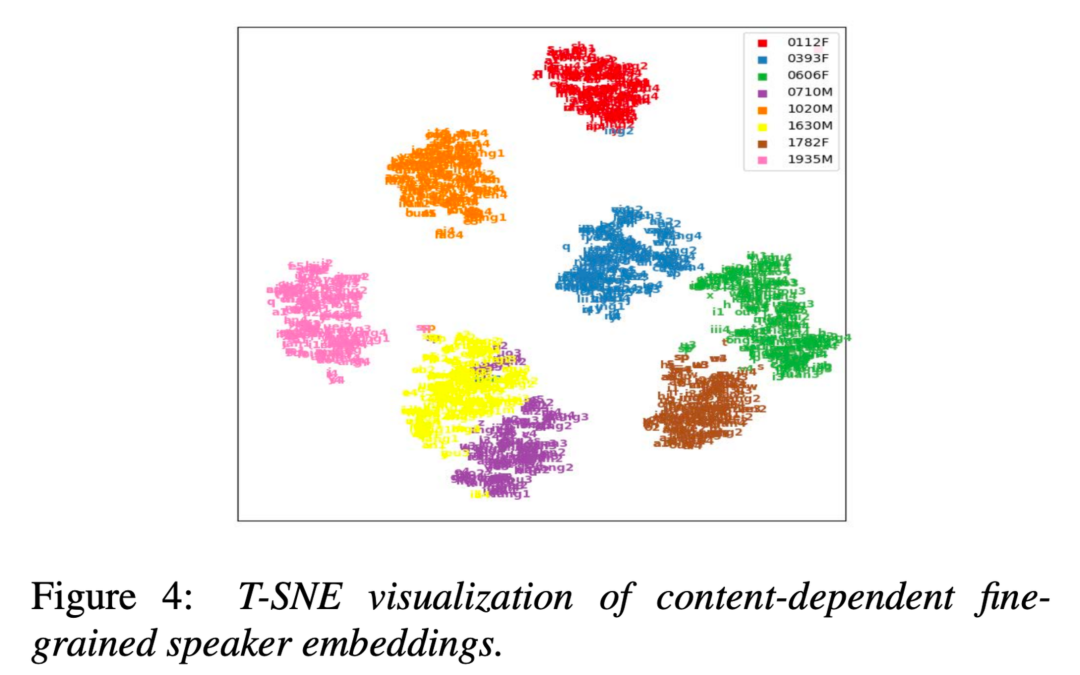
样例分析
05 结语
本文为语音合成零样本说话人自适应任务提出了一种内容相关的细粒度说话人表征(CDFSE)方法。 该方法考虑了参考语音和待合成文本之间的发音内容相关性,从而给TTS模型的每个音素编码结果生成更加合适精细的细粒度说话人表征。 主观及客观实验证明所提的 CDFSE 能够提升合成语音的说话人相似度,特别是对于unseen speaker而言; 另外,样例分析也证实了该方法确实具有建模个人细粒度发音特点的能力。
