
 语音小管家
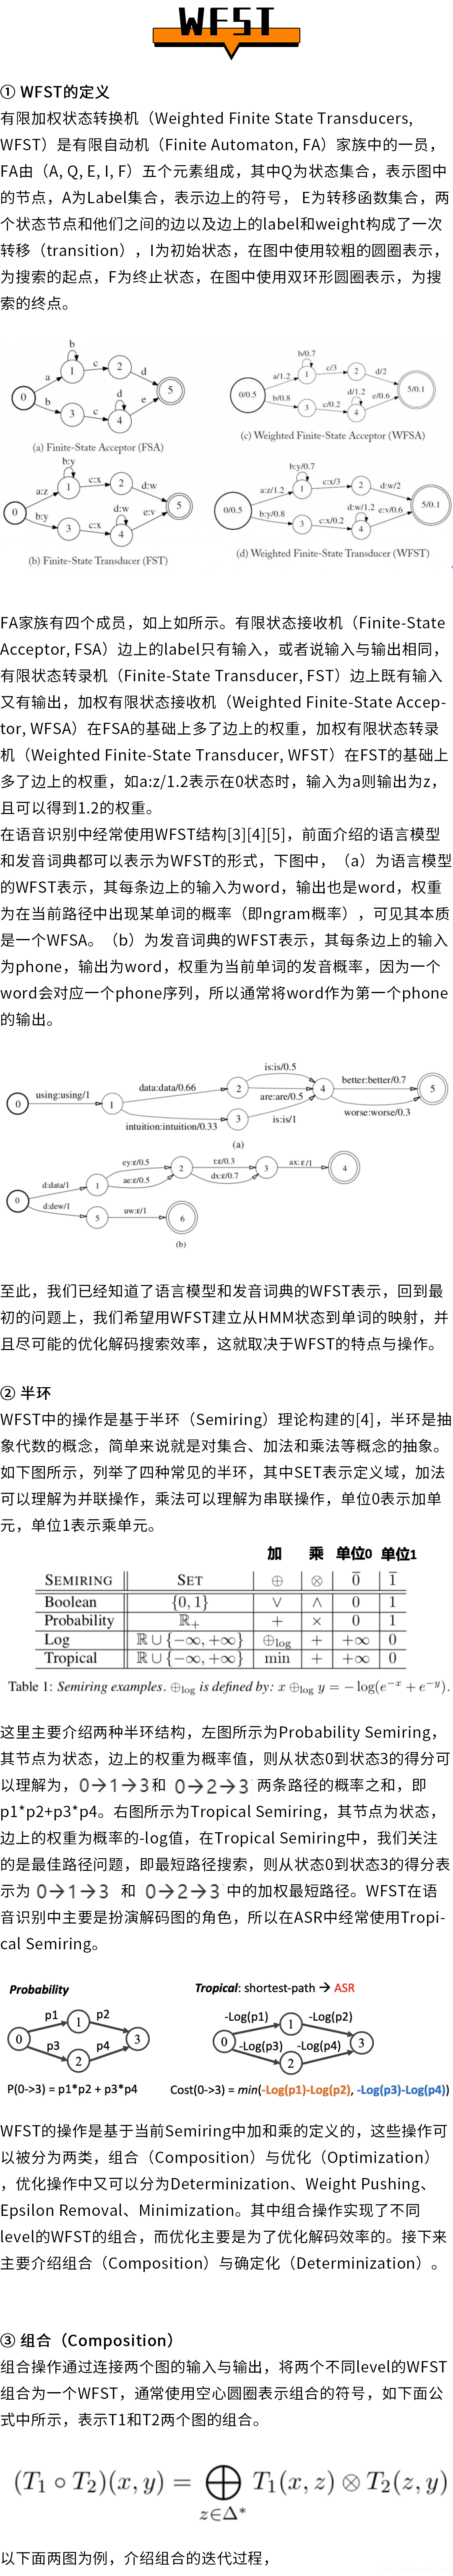
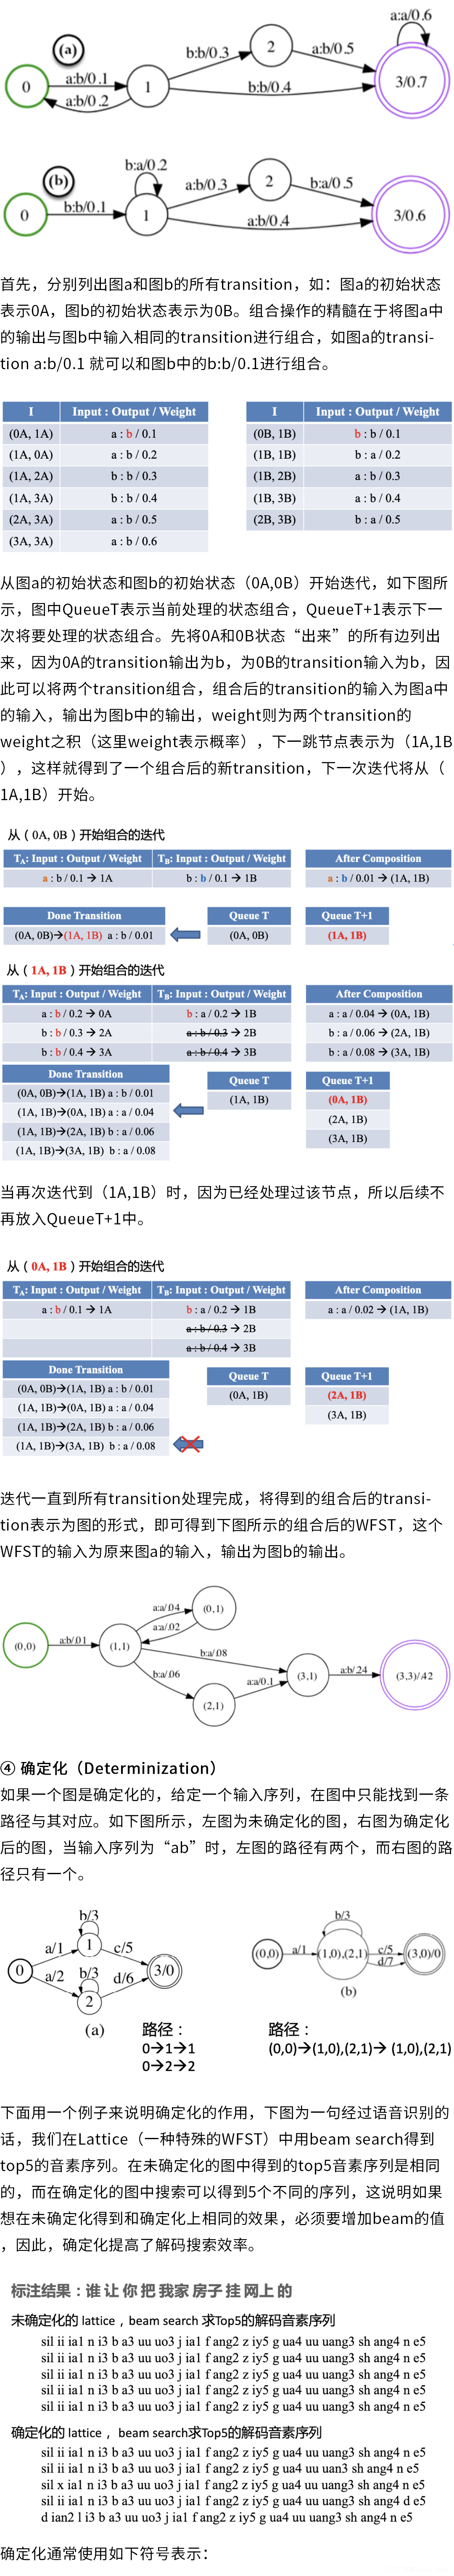
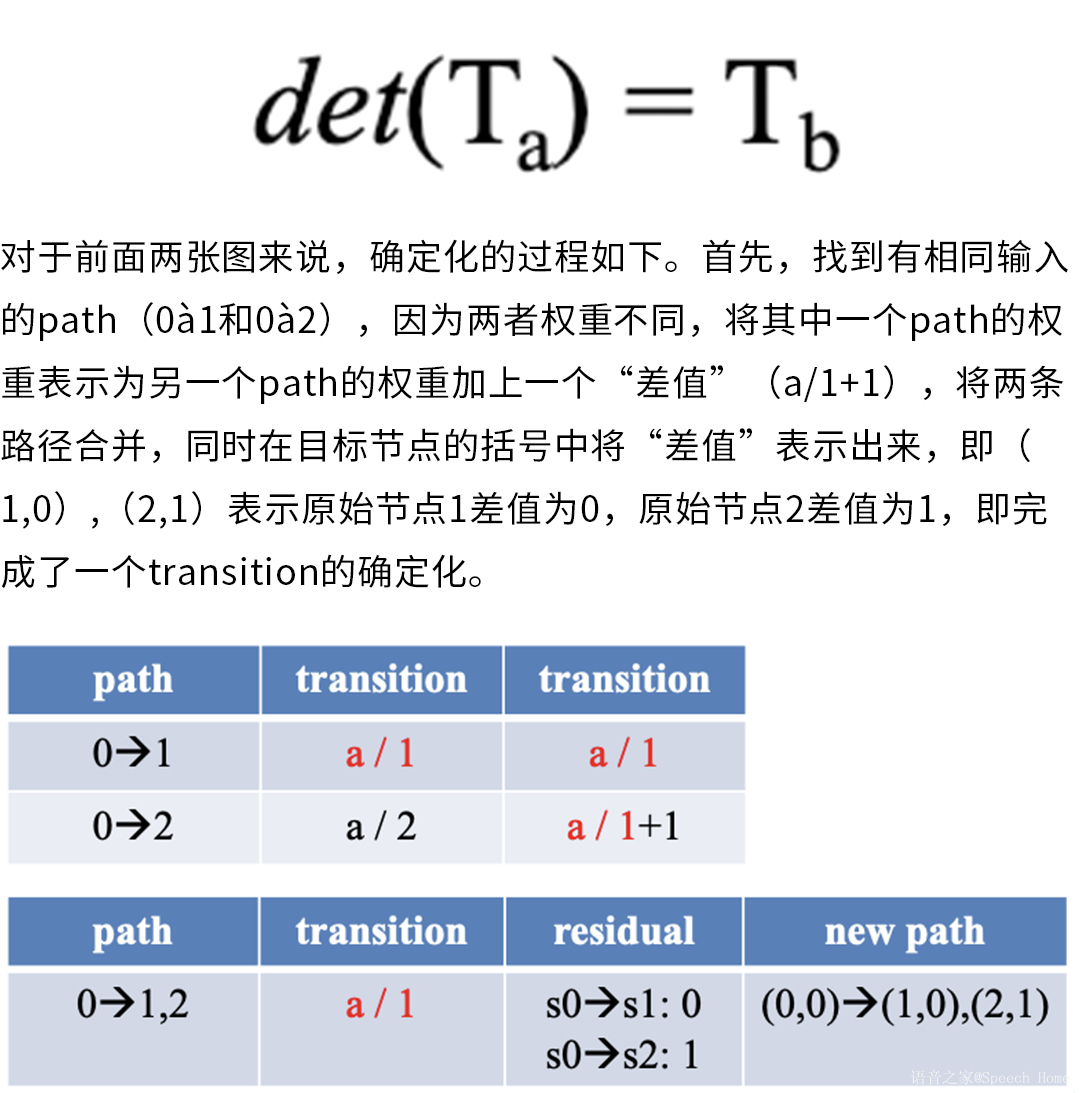
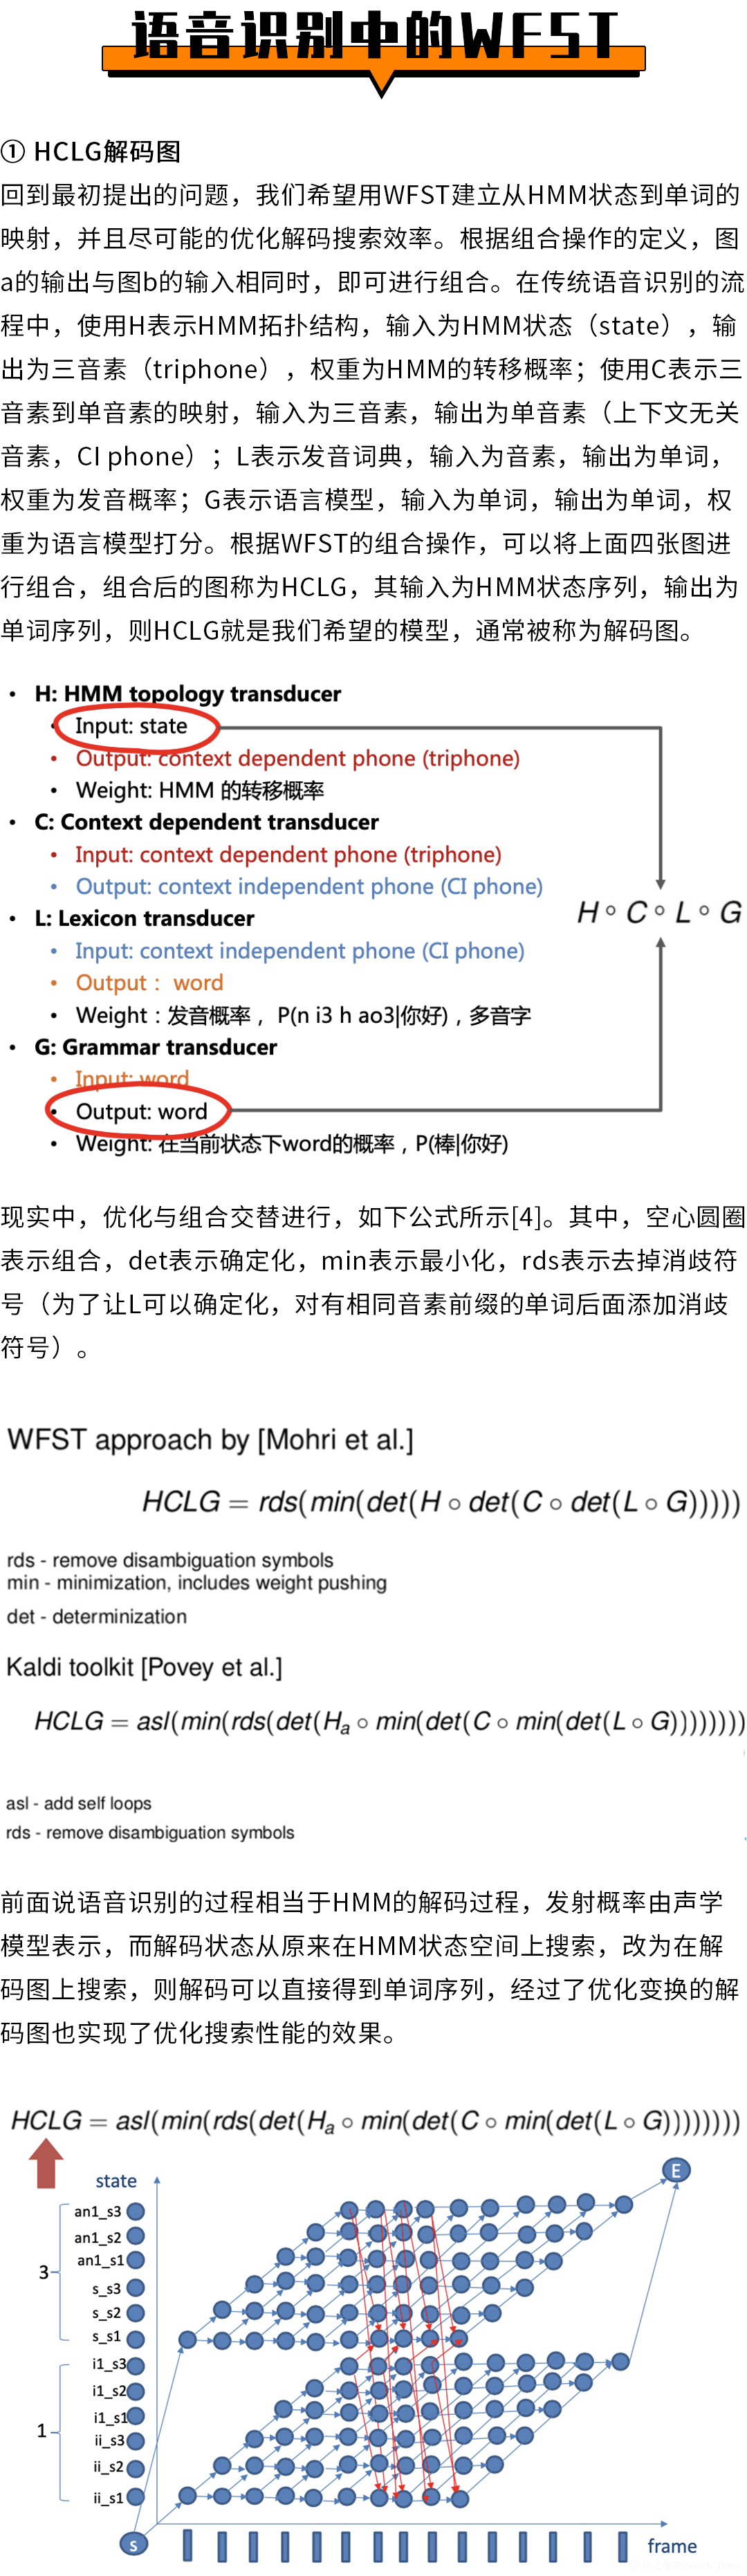
在语音识别系统中,有限加权状态转换机(Weighted Finite State Transducers, WFST)扮演着重要角色。本文主要介绍发音词典、语言模型和WFST的原理,以及在实践过程中的一些优化方法。
参考文献:
[1] Goodman, S. F. C. a. J. (1999). "An empirical study of smoothing techniques for language modeling."
[2] Toma ́sˇ Mikolov1, Martin Karafia ́t (2010). "Recurrent neural network based language model."
[3] Mehryar Mohri1, F. P. a. M. R. (2002). "Weighted Finite-State Transducers in Speech Recognition."
[4] Mohri1, M. (2008). "SPEECH RECOGNITION WITH WEIGHTED FINITE-STATE TRANSDUCERS."
[5] Dixon, P. R. O., Tasuku; Iwano, Koji; Furui, Sadaoki (2009). "Recent Development of WFST-Based Speech Recognition Decoder."
[6] Goodman, J. T. (2001). "A Bit of Progress in Language Modeling Extended Version."
[7] X. Liu1, M. J. F. G., J.L. Hieronymus2, P.C. Woodland1 (2010). "LANGUAGE MODEL COMBINATION AND ADAPTATION USING WEIGHTED FINITE STATE TRANSDUCERS."
[8] Povey, D. (2012). "GENERATING EXACT LATTICES IN THE WFST FRAMEWORK."
[9] H.Abdulla, A. A. A. a. W. (2013). "Speech Decoding Using Lattice Rescoring."
[10] Daniel Povey1, A. G. (2011). "The Kaldi Speech Recognition Toolkit."
[11] Abrash, A. S. J. Z. W. W. V. (2011). "SRILM at Sixteen: Update and Outlook."
[12] Marcello Federico, N. B., Mauro Cettolo (2016). "IRSTLM: an Open Source Toolkit for Handling Large Scale Language Models."
作者简介:
周维,58同城AI Lab算法资深开发工程师,2018年5月加入58,先后从事智能客服、语音机器人、写稿机器人和语音识别项目的算法工作,目前主要从事语音识别算法开发。
