
 语音小管家
神经网络结构搜索算法最近在各个方面都使用,本文是在语音合成上的使用,
关键是论文链接:https://arxiv.org/abs/2002.10389,
GitHub链接:https://github.com/renqianluo/SemiNAS。
近年来,神经网络结构搜索(Neural Architecture Search, NAS)取得了较大的突破,但仍然面临搜索耗时及搜索结果不稳定的挑战。为此,微软亚洲研究院机器学习组提出了基于半监督学习的神经网络结构搜索算法 SemiNAS ,能在相同的搜索耗时下提高搜索精度,以及在相同的搜索精度下减少搜索耗时。SemiNAS 可在 ImageNet(mobile setting) 上达到23.5%的 top-1 错误率和6.8%的 top-5 错误率。同时,SemiNAS 第一次将神经网络结构搜索引入文本到语音合成任务(Text to Speech, TTS)上,在低资源和鲁棒性两个场景下取得了效果提升。
语音合成(TTS)
我们还探索了 SemiNAS 在新领域的应用,将其用于语音合成(Text to Speech, TTS)任务上。
在将 NAS 应用到一个新任务时,需要面临两个基本的问题:搜索空间设计以及搜索指标设计。对于搜索空间的设计,我们参照主流 TTS 模型,设计了基于编码器-解码器(encoder-decoder)的框架(backbone)。在具体搜索每层的运算操作时,候选操作包括 Transformer 层(包含不同的注意力头数量)、卷积层(包含不同卷积核大小)、LSTM 层。对于评价指标的设计,不像在分类任务、识别任务以及语言模型任务中评价标准是客观的,可以通过程序自动完成。在 TTS 任务中,合成音频的质量需要人工去评判,而 NAS 需要评价成百上千的网络模型,这在 TTS 中是不现实的。所以需要设计一种客观的评价标准。我们发现合成音频的质量和其编解码器之间的注意力机制图中的注意力权重聚焦在对角线上的程度(diagonal focus rate, DFR)有较强相关性,其对最终的音频质量有指导意义,故选择它作为搜索时的客观评价指标。
我们尝试用 NAS 解决当前 TTS 面临挑战的两个场景:低资源场景(low resource setting)和鲁棒性场景(robustness setting)。在低资源场景中,可用的 TTS 训练数据较少,而在鲁棒性场景中,测试的文本输入一般比较难。我们将 NAO 作为对比的 baseline 之一,在实验中保持 NAO 和 SemiNAS 的搜索耗时相同,来比较最终的搜索结构的性能。
我们在 LJSpeech 数据集(24小时语言文本对)上进行实验,对于低资源场景,随机选取了约3小时的语音和文本作为训练数据来模拟低资源场景,最终实验结果如表3所示。
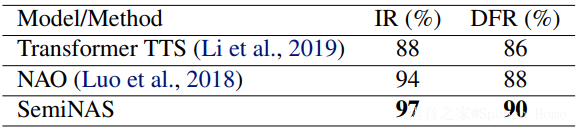
表3:不同方法在低资源场景下的性能
对于最终生成的音频,我们用可懂度(Intelligibility Rate, IR),即人能听懂的单词数量占比,来评价模型性能。可以看到,人工设计的 Transformer TTS [8] 只取得了88%的可懂度,之前的 NAS 算法 NAO 取得了94%,而 SemiNAS 取得了97%的可懂度,相比 Transformer TTS 提升了9%,相比 NAO 也有明显提升。同时可以看到,我们设计的搜索指标 DFR 和 IR 呈正相关性,验证了使用 DFR 作为客观评价指标进行搜索的有效性。
对于鲁棒性场景,我们在整个 LJSpeech 上进行训练,然后额外找了100句较难的句子(包含很多单音节或重复音节等)作为测试集,实验结果如表4所示。
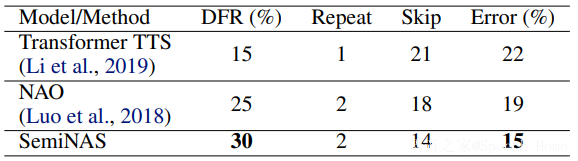
表4:不同方法在鲁棒性场景下的性能
我们计算了不同模型在测试集上发生重复吐词、漏词的句子数,并计算了整体错误率(一句话里只要出现一次重复吐词或漏词记为一次错误)。可以看到,Transformer TTS 达到了22%的错误率,SemiNAS 将其降低到了15%。
