
 语音小管家
Hey Siri:一个由DNN驱动的苹果个人助理语音触发器
参考资料
https://machinelearning.apple.com/2017/10/01/hey-siri.html
“Hey Siri”功能允许用户免提唤醒Siri。一个只识别两个单词的非常小的唤醒词识别器会一直运行。当它检测到“Hey Siri”时,Siri的其余功能会将后面的语音解析为命令或查询。“Hey Siri”唤醒词识别器使用一个深度神经网络(DNN)将你的声音在每个瞬间的声学特征转换成语音上的概率分布。然后它使用一个时间积分过程来计算你所说的短语是“Hey Siri”的置信度。如果比分足够高,Siri就会被唤醒。本文将介绍底层技术。它主要面向那些对机器学习有所了解但对唤醒词识别了解较少的读者。
Hands-Free Access to Siri
如果需要Siri的帮助,可以直接对苹果设备说“Hey Siri”而不需要按按钮。这看起来很简单,但是很多工作都在幕后快速有效地支持这一技术。硬件、软件和互联网服务无缝地结合在一起,提供了极好的体验。
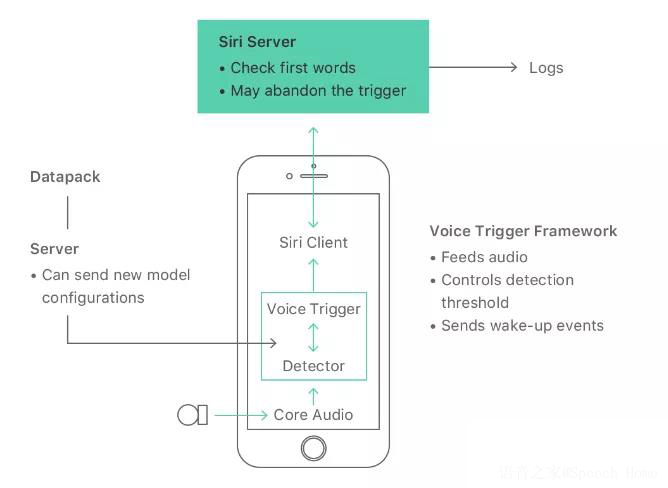
当你做饭或开车腾不开手的时候,或者使用苹果手表的时候,不用按按钮就能使用Siri尤其有用。如图1所示,整个系统有几个部分。Siri的实现大多是在“云端”,主要包括语音识别、自然语言处理和各种信息服务。还有一些服务器可以更新探测器使用的神经网络模型。本文主要关注在本地设备上运行的部分,如iPhone或Apple手表。特别是,它专注于唤醒词检测器:一个专门的语音识别器,它总是只识别它的唤醒词。
The Detector: Listening for “Hey Siri”
iPhone或Apple Watch中的麦克风将您的语音转换为实时波形音频流,速率为每秒16000个点(采样率16k)。频谱分析方法将波形样本流转换为一个帧序列,每个帧描述大约0.01秒、每次大约20帧(0.2秒的音频)被送到一个深度神经网络(DNN),它将这些频谱语音特征转换成一组语音类上的概率分布:“Hey Siri”一词的各个音素状态,再加上静音和其他语音,总共约有20种声音类别。图2是用来检测“Hey Siri”的深层神经网络。隐藏层实际上是全连接的。顶层执行时间积分。实际DNN是虚线框内的结构表示。
DNN主要由矩阵乘法和logistic非线性函数组成。每个“隐藏”层都是DNN在对其进行训练以将输入filter bank(声学特征)转换为语音类的训练过程中的中间表示。最终的非线性函数本质上是一个Softmax函数(也称为一般logistic或归一化指数)。
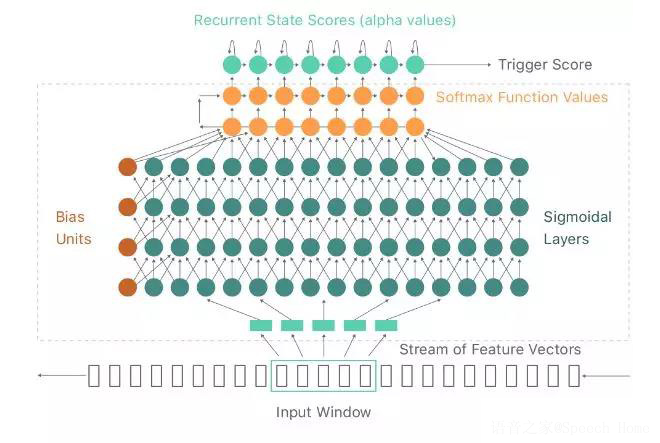
我们在DNN的每个隐藏层中选择神经网络节点的数量以适应“Hey Siri”检测器运行时可用的计算资源。我们使用的网络通常有五个隐藏层,所有层的大小都相同:32、128或192个节点,具体取决于内存和电源限制。在iPhone上,我们使用两个网络,一个用于初始检测,另一个用作辅助检测,初始检测器使用的节点数少于辅助检测器。
神经网络模型的输出提供了每个帧在语音类上的分布。一个语音类通常类似于前面是一个高前元音,后面是一个前元音的音素/s/。”
我们想检测“Hey Siri”,如果神经网络的输出在目标唤醒词(Hey Siri)的正确序列中是很高的。为了为每帧生成一个置信度分数,我们将这些局部值按时间序列进行累积。这在图2的最后(顶部)层中表示为一个循环网络,连接到不同时间序列的同一个单元。每个单元内都有一个求最大值和一个加法的操作:
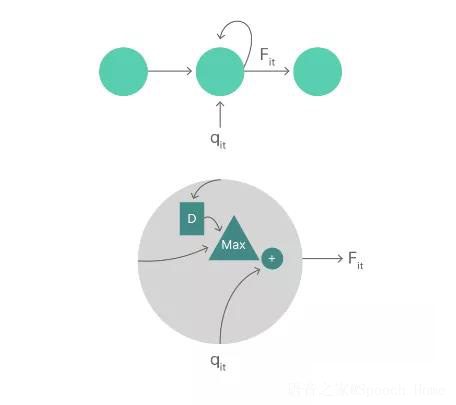
每一个累积分数
“Hey Siri”检测器中几乎所有的计算都在神经网络模型中。时间积分计算相对较快,因此在评估规模或计算资源时忽略了它。
如果我们使用的是最小的DNN,可以通过查看图4更好地了解唤醒词检测器的工作原理,图4显示了不同阶段的声音信号。最下面是麦克风的频谱图。在这种情况下,有人在说“嘿,Siri,…”这句话中声音最响亮的部分是频谱图中最亮的部分。Hey Siri图案位于垂直蓝色线条之间。
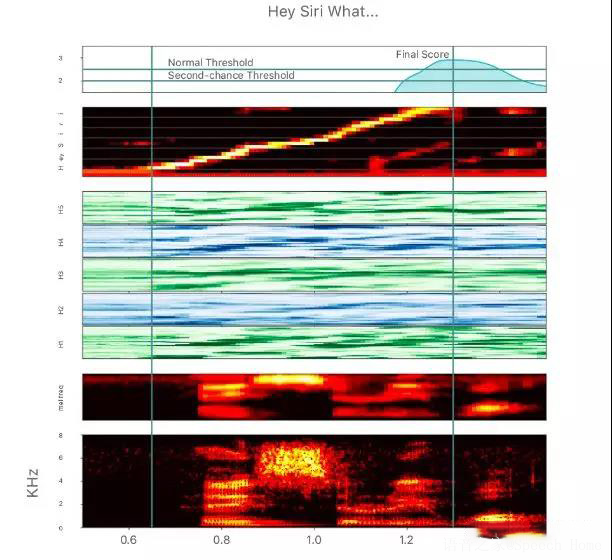
从底部向上的第二个特征条显示了使用mel滤波器组分析相同波形的结果,该滤波器组是基于人体感知而赋予频率权重。
标记为H1到H5的绿色和蓝色相间的水平条带显示了五个隐藏层中每一层单元的数值,每个隐藏层中有32个节点。
下一个条形图(黄色对角线)显示神经网络模型的输出。在每一帧中,输入语音的对应的每个输出类都有一个输出概率,除了与唤醒词相关的输出另外还有用于静音和其他语音的输出。最后的分数,是根据上述的方程计算得到,是沿着明亮的对角线将局部分数相加得到的。注意,在整个唤醒词进入系统后,分数会上升到一个峰值。
我们将最后的分数与阈值进行比较,以决定是否激活Siri。实际上,阈值不是固定值。我们建立阈值多了一些灵活性,使得在困难的条件下更容易激活Siri,同时不会显著增加假激活(false activations)的数量。有一个主要的,或正常的阈值,和一个较低的阈值(通常不会触发Siri)。如果分数超过了较低的阈值,但没有超过较高的阈值,那么可能是我们错过了一个真正的“Hey Siri”事件。当分数在这个范围内时,系统会进入一个更敏感的状态几秒钟,因此如果用户重复这个短语,即使没有付出更多的努力,Siri也会触发。这种二次机会机制显著地提高了系统的可用性,而不会过多地增加虚警率,因为它只是在短时间内处于这种额外的敏感状态。(我们稍后将讨论精度的测试和调整。)
Responsiveness and Power: Two Pass Detection
“Hey Siri”探测器不仅要精确,而且要快速,对电池寿命没有显著影响。我们还需要最小化内存使用和处理器需求,特别是峰值处理器需求。
为了避免整天运行主处理器只是为了识别唤醒词,iPhone的Always On processor(AOP)(一个小的、低功耗的辅助处理器,即嵌入式运动协处理器)可以访问麦克风信号(6S及更高版本)。我们使用一小部分AOP有限的处理能力来运行一个带有小版本神经网络模型(DNN)的探测器。当分数超过阈值时,运动协处理器唤醒主处理器,主处理器使用较大的DNN分析信号。在支持AOP的第一个版本中,第一个检测器使用5层32个节点的隐藏单元的DNN,第二个检测器使用5层192个节点的隐藏单元。
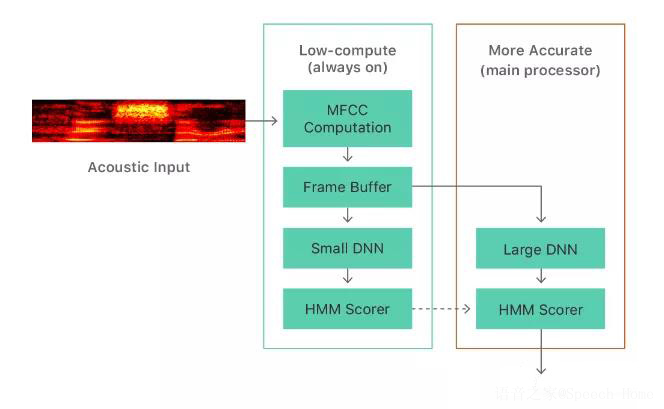
由于电池体积很小,苹果手表面临着一些特殊的挑战。苹果手表使用的是一个单通道的“Hey Siri”探测器,其神经网络大小介于其他iOS设备上用的第一次和第二次通过的神经网络之间。“Hey Siri”探测器只有在手表运动协处理器检测到一个手腕抬起的手势时才会运行,这会打开屏幕。在这一段时间,WatchOS有很多事情要做,比如通电,准备屏幕等等,所以系统只分配“Hey Siri”在有限的计算预算中的一小部分(约5%)。及时开始音频捕获以捕获触发短语的开头是一个挑战,因此我们考虑了在初始化检测器时可能出现的语言截断。
“Hey Siri” Personalized
我们设计了“Hey Siri”探测器,原理上说只要附近有人说唤醒词,我们都会做出反应。为了减少错误触发的烦恼,我们邀请用户进行一个简短的注册会话。在注册过程中,用户会说出五个短语,每个短语以“Hey Siri”开头。我们将这些示例保存在设备上。
我们将任何可能的新的“Hey Siri”语句与存储的示例进行比较,过程如下:(第二个神经网络)检测器通过取与每个状态对齐的帧的平均值,产生用于将声学特征图案转换为固定长度的矢量来代表说话人。一个单独的、经过专门训练的DNN将这个向量转换成一个“说话人空间”(speaker space),在这个空间中,通过设计,来自同一个说话人的向量趋向于接近,而来自不同说话人的向量趋向于更远的距离。我们将与注册过程中创建的参考向量的距离与另一个阈值进行比较,以确定触发检测器的声音是否可能是注册用户所说的“Hey Siri”。
这个过程不仅降低了另一个人说的“Hey Siri”触发iPhone的可能性,而且还降低了其他类似发音的短语触发Siri的速率。
Further Checks
如果波形通过类iPhone上的各个阶段,最终就会到达Siri服务器。如果主语音识别器听到的不是“Hey Siri”(例如“Hey serious”)的声音,则服务器会向手机发送取消信号,使其重新进入睡眠状态,如图1所示。在某些系统上,我们在设备上运行主识别器的精简版本,以便在前面提供额外的检查。
The Acoustic Model: Training
我们创建了一个特定于语言的“Hey Siri”词组的音素序列。在美式英语中,我们有两个变体,在“Siri”中有不同的第一个元音,一个是“serious”,另一个是“Syria”。我们还试图处理这两个单词之间的短暂中断,尤其是这个短语经常用逗号写:“Hey,Siri”。每个语音符号产生三个语音类(开始时,中间和末端)每个都有自己的神经网络模型输出。
我们使用一个语音语料库来训练DNN,主Siri识别器为每个帧提供一个语音类标签(音素)。主识别器使用了数千个语音类,但只需要20个左右的类与唤醒词有关(包括一个初始静音类),其他的类则需要一个大类包含。训练过程尝试为标有相关状态和音素的帧生成接近1的DNN输出。训练过程使用标准的反向传播和随机梯度下降来调整权重。我们使用了各种神经网络训练软件工具包,包括Theano、Tensorflow和Kaldi。
这个训练过程会根据声学观测结果对音素和状态的概率进行估计,但是这些估计包括了训练集中音素的出现频率(priors),这可能是非常不均匀的,与唤醒词检测器的使用环境没有什么关系,所以我们补偿了使用神经网络模型输出之前的先验概率。
训练一个模型大约需要一天的时间,而且通常有几个模型在同时训练。我们一般会训练三种版本:一种是在运动协处理器上进行第一次扫描的小型号,一种是进行第二次扫描的大型号,一种是用于苹果手表的中型型号。
Testing and Tuning
一个理想的唤醒词探测器会在用户说“Hey Siri”时响应,而不是在其他时间响应。我们用两种错误来描述探测器的准确性:在错误的时间响应和未能在正确的时间响应。false accept rate(FAR或false alarm rate)是每小时的错误响应数,false Rejection rate(FRR)是尝试响应失败的比例。
对于给定的模型,我们可以通过改变响应的阈值来改变两种误差之间的平衡。图6显示了两种早期开发模型的权衡示例。更改阈值将沿曲线移动。
在开发过程中,我们试图通过使用一个大型测试集来评估系统的准确性,这个测试集的收集和准备成本很高,但却是必不可少的。有“正面”数据和“负面”数据。“正面”数据包含目标短语。你可能认为我们可以使用“Hey Siri”系统接收到的语音,但系统没有捕获未能响应的语音,我们希望改进系统,尽可能多地包含此类失败的尝试。
起初,我们使用了一些用户在按下Home按钮时说的“Hey Siri”的语音,但这些用户并没有试图引起Siri的注意(按钮会引起注意),而且麦克风一定在手臂够得着的范围内(近场),而我们也希望“Hey Siri”在房间的另一边工作(远场)。我们特别在不同的条件下录制,例如在厨房(近距离和远距离)、汽车、卧室和餐厅,由每种语言的母语者录制。
我们使用“负面”数据来测试错误激活(和错误唤醒)。这些数据代表了数千小时的录音,来自不同的来源,包括播客和以多种语言输入到Siri的非“Hey Siri”语音,以表示背景声音(尤其是语音)和用户可能对另一个人说的短语类型。我们需要这么多的数据,因为我们正试图得到低至每周一次的虚警率。(如果负面数据中出现目标短语,我们会将其标记为负面数据,这样我们就不会将对它们的响应计算为错误。)
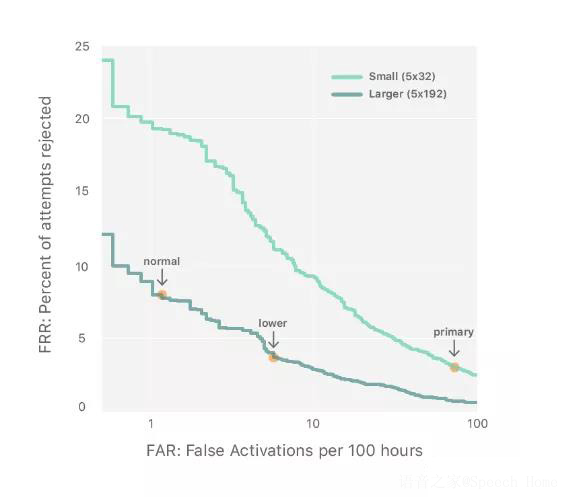
调整主要是决定使用什么阈值的问题。在图6中,较大模型的较低权衡曲线上的两点显示了可能的正常阈值和第二机会阈值。较小(第一次通过)模型的操作点在右侧。这些曲线仅适用于探测器的两个阶段,不包括个性化阶段(说话人测试)或后续检查。
虽然我们确信在测试集上表现更好的模型可能确实更好,但是将离线测试结果转换为用户体验的有用预测是相当困难的。因此,除了前面描述的离线测试之外,我们每周通过从生产数据中取样来估计误报率(当Siri打开而用户没有说“Hey Siri”)和非注册用户响应率(当Siri打开而非注册的用户说“Hey Siri”)。这不会给我们拒绝率(当系统无法响应有效的“Hey Siri”时),但我们可以根据响应率稍稍高于有效阈值的比例,以及开发人员携带的设备上稍稍低于阈值的采样来估计拒绝率。
我们不断地评估和改进“Hey Siri”,以及为其提供模型,通过使用这里描述的方法进行训练和测试。我们用多种语言进行训练,并在各种条件下进行测试。只是希望下一次你说“Hey Siri”的时候,它能奏效!
