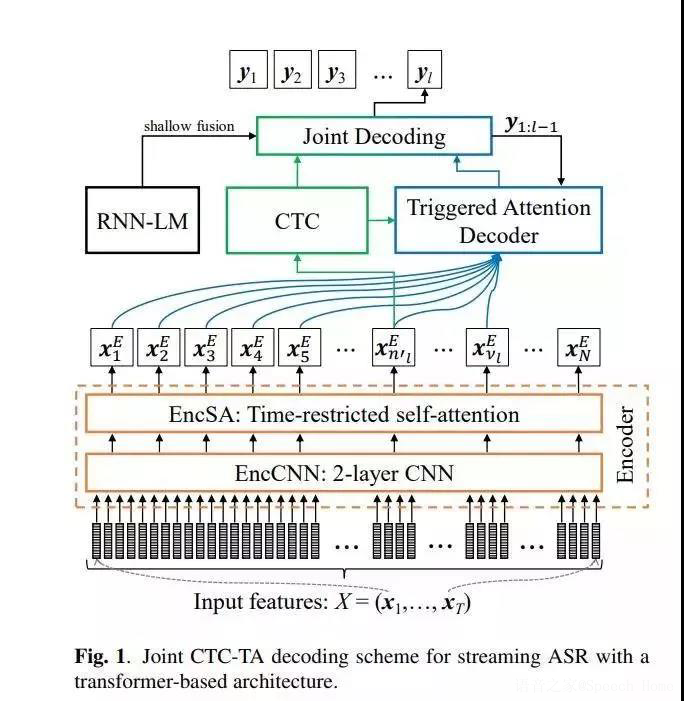
论文名称:Streaming automatic speech recognition with the transformer model作者:Moritz Niko /Hori Takaaki /Roux Jonathan Le论文链接:https://arxiv.org/pdf/2001.02674推荐理由:基于编码器-解码器的序列到序列模型已经证明了端到端自动语音识别(ASR)的最新结果。最近,与基于递归神经网络(RNN)的系统体系结构相比,使用自我注意力对时间上下文信息进行建模的转换器体系结构已显示出显着更低的字错误率(WER)。尽管获得了成功,但实际使用仅限于离线ASR任务,因为编码器/解码器体系结构通常需要整个语音发音作为输入。在这项工作中,作者提出了一种基于transformer的端到端ASR系统,用于流式传输ASR,在该系统中,每个口语单词后必须立即生成输出。为此,我们对编码器应用了有时间限制的自注意力,并为编码器-解码器注意机制触发了注意。对于LibriSpeech的“干净”和“其他”测试数据,作者提出的流媒体转换器体系结构实现了2.7%和7.0%的WER,据所知,这是针对此任务发布的最佳流媒体端到端ASR结果。
基于attention的端到端语音识别这几年有大量的研究,但是attention的问题就是需要拿到整个语音后才能做,所以想做流式识别或者在线识别就必须要解决这个问题,本文是把利用CTC的结果去触发attention,这个也是一个常用的做法,此外,使用可以流式的attention(Mocha)也是一个办法。
 语音小管家