
 语音小管家
前文
今天我和大家聊聊FaceBook的《Convolutional Sequence to Sequence Learning》和Google的《Attention is All You Need》,它们都算是Seq2Seq上的创新,本质上来说,都是抛弃了RNN结构来做Seq2Seq任务。
这篇文章中,笔者对《Attention is All You Need》做一点简单的分析。网上已经有很多解读了(不过很多解读都是直接翻译论文的,鲜有自己的理解),因此这里尽可能多自己的文字,尽量不重复网上各位大佬已经说过的内容。
序列编码
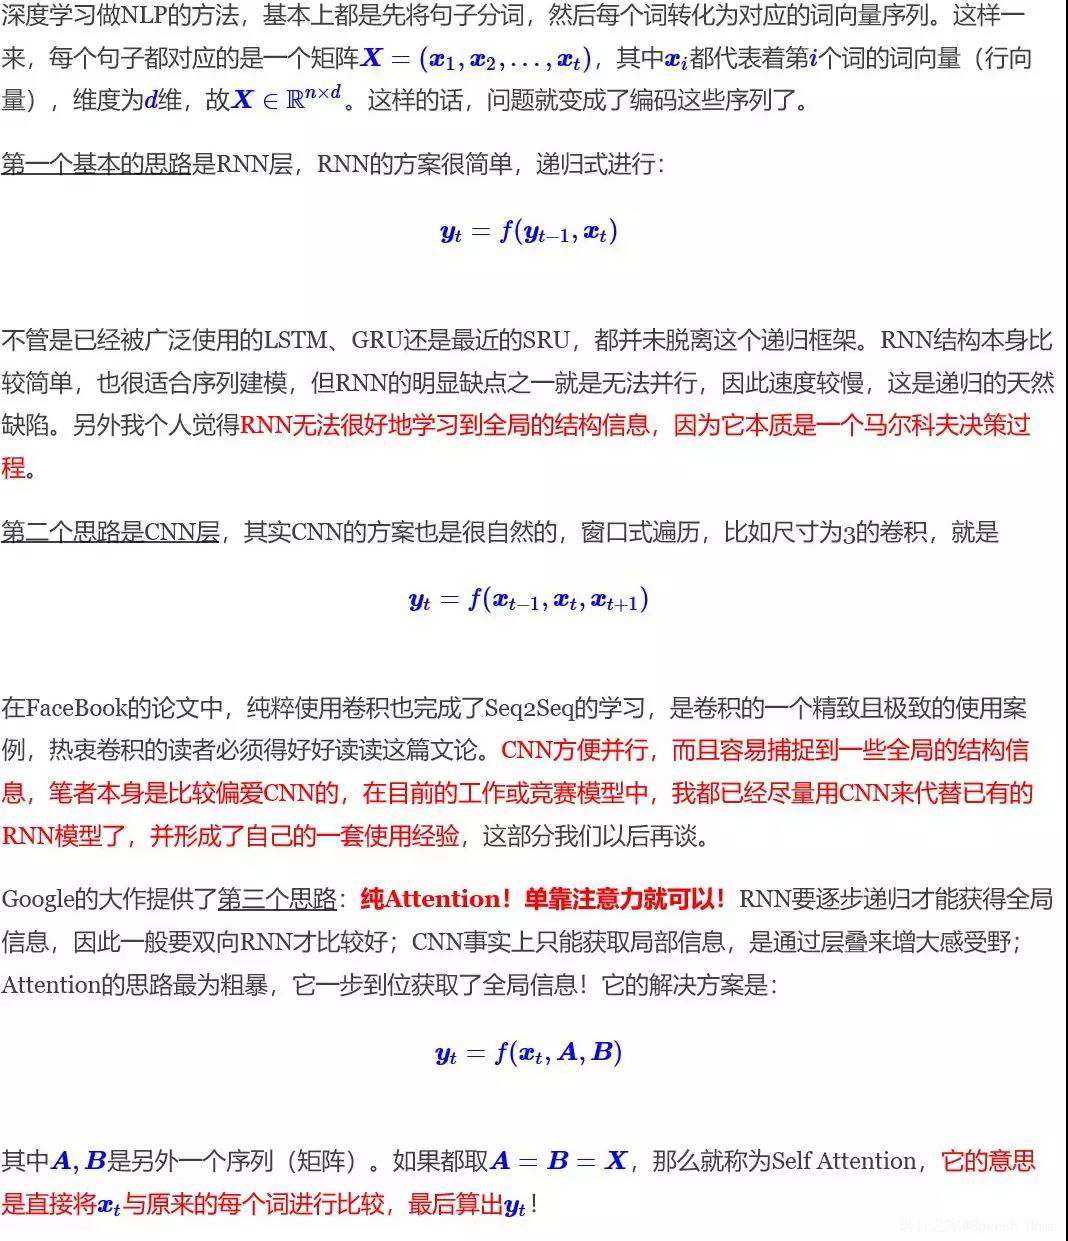
Attention层
① Attention定义
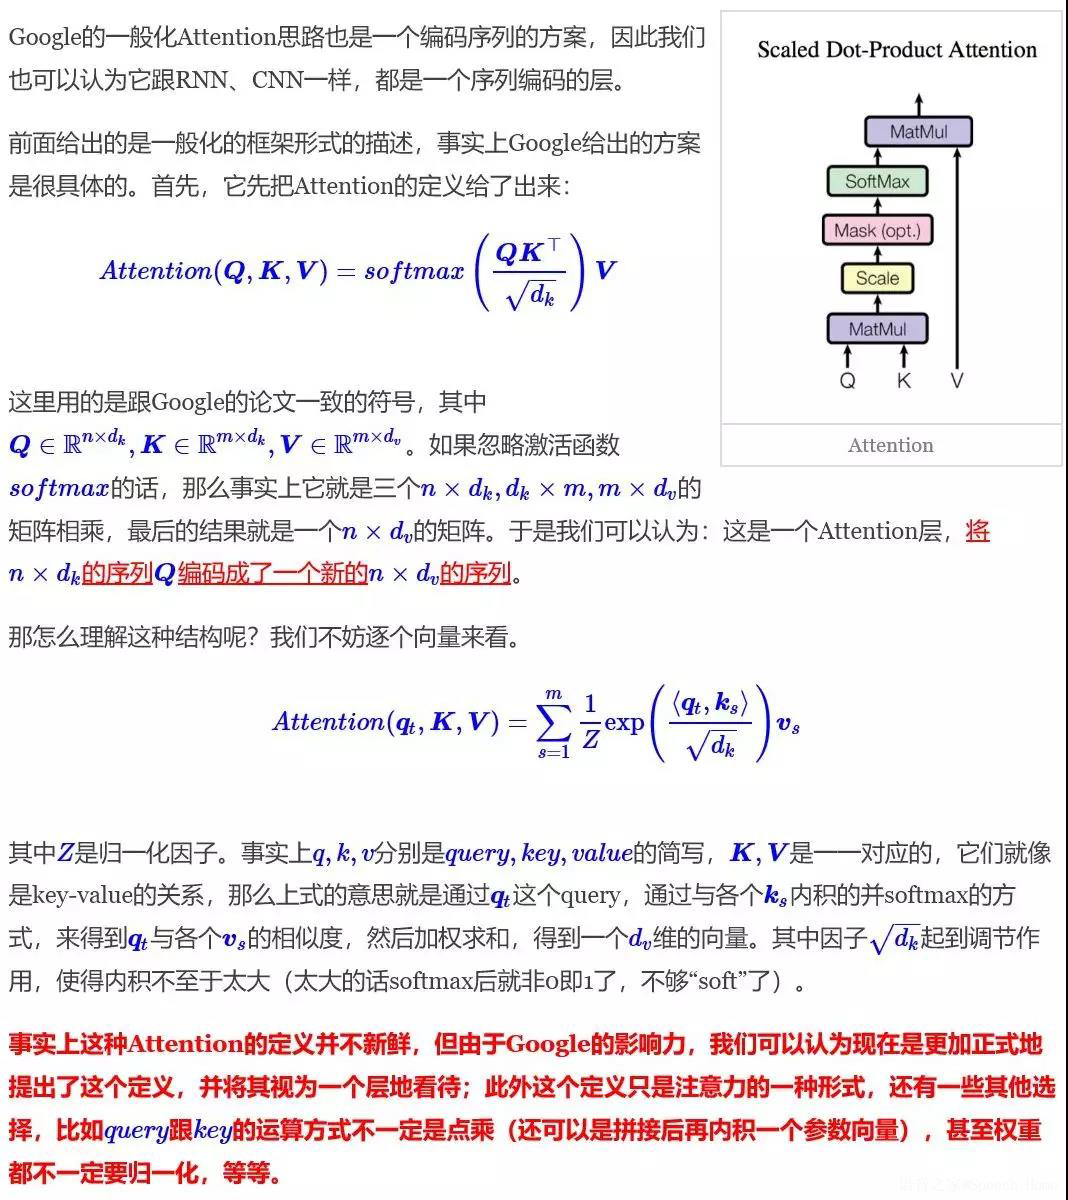
② Multi-Head Attention
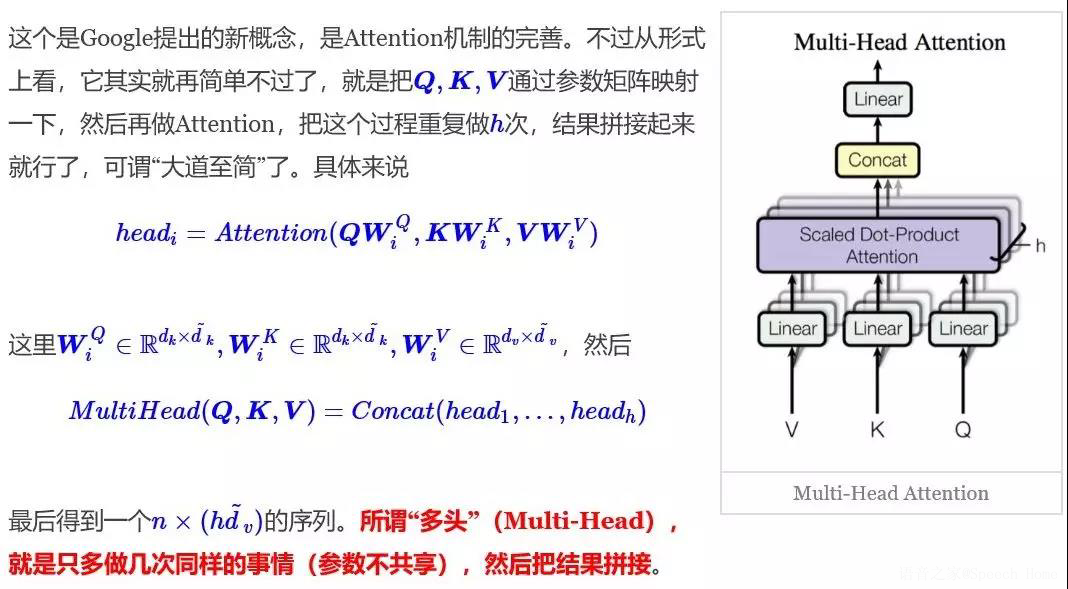
③ Self Attention
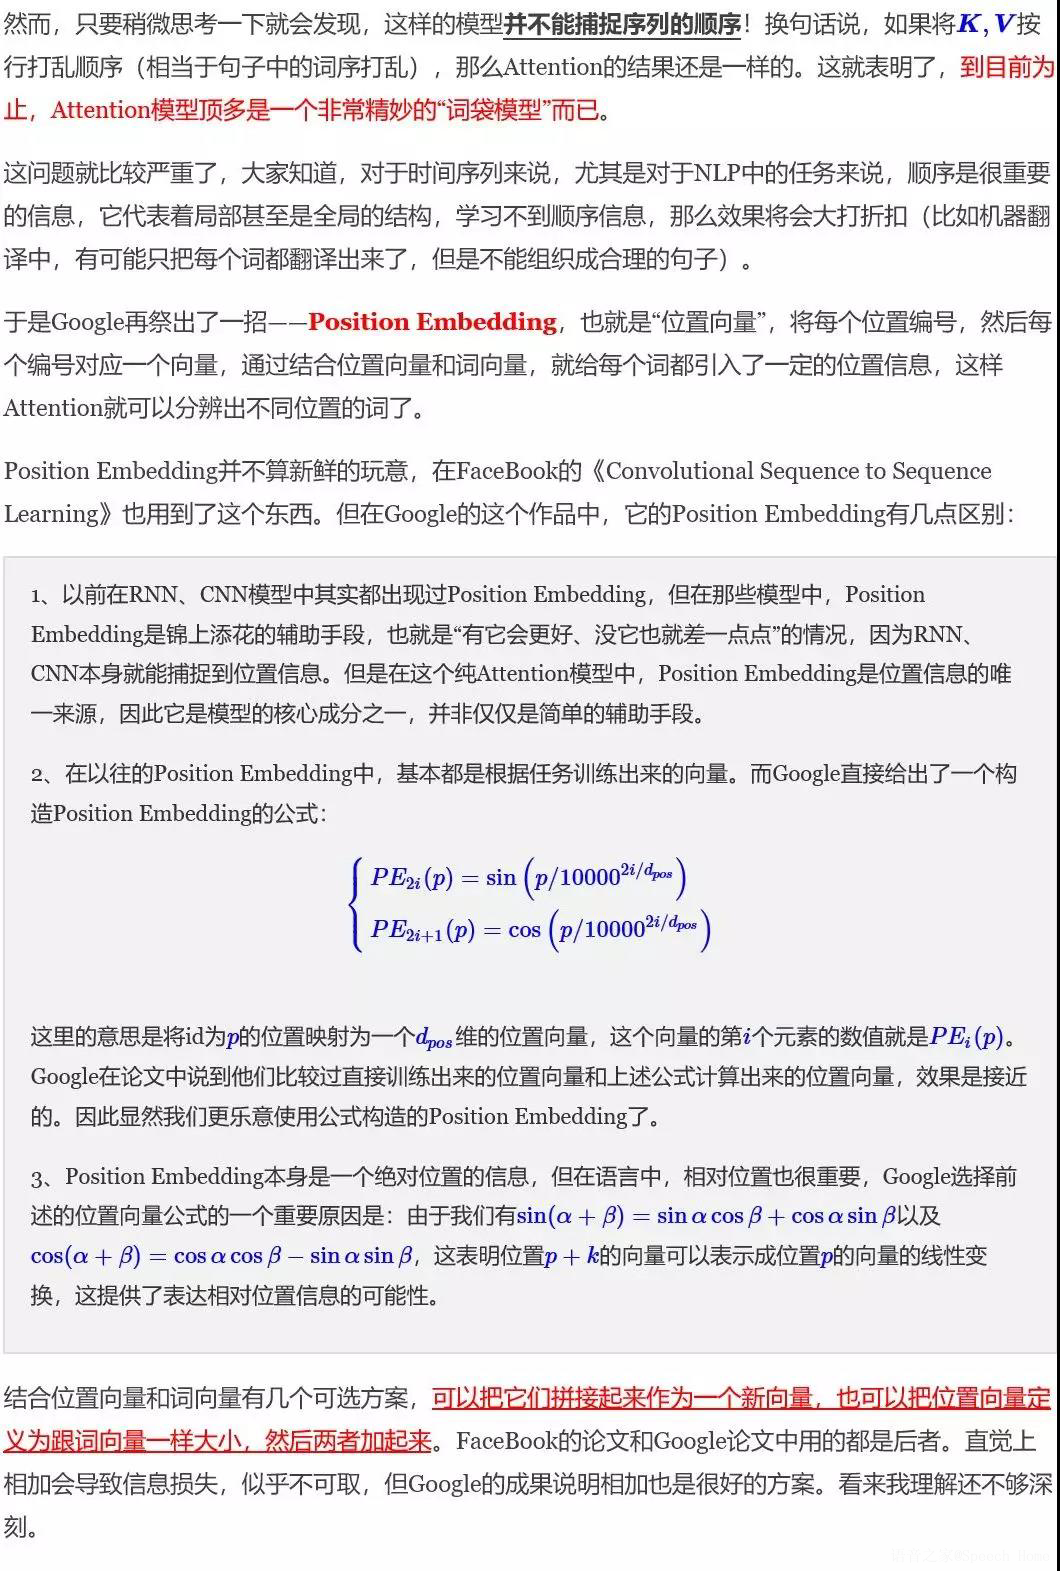
④ Position Embedding
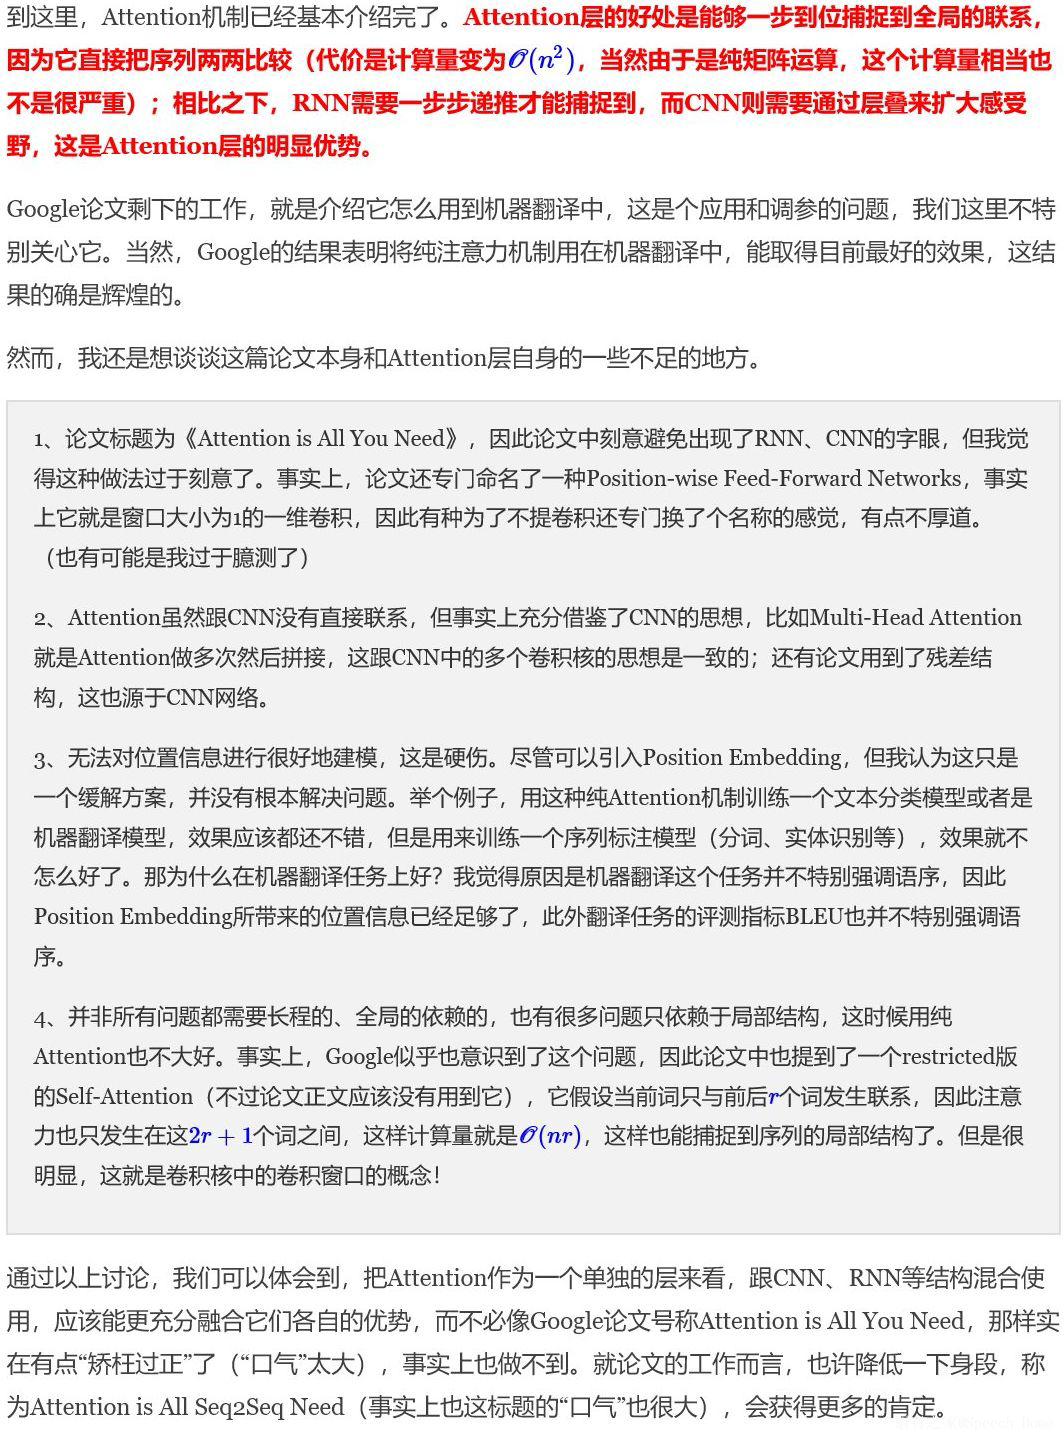
一些不足之处
代码实现
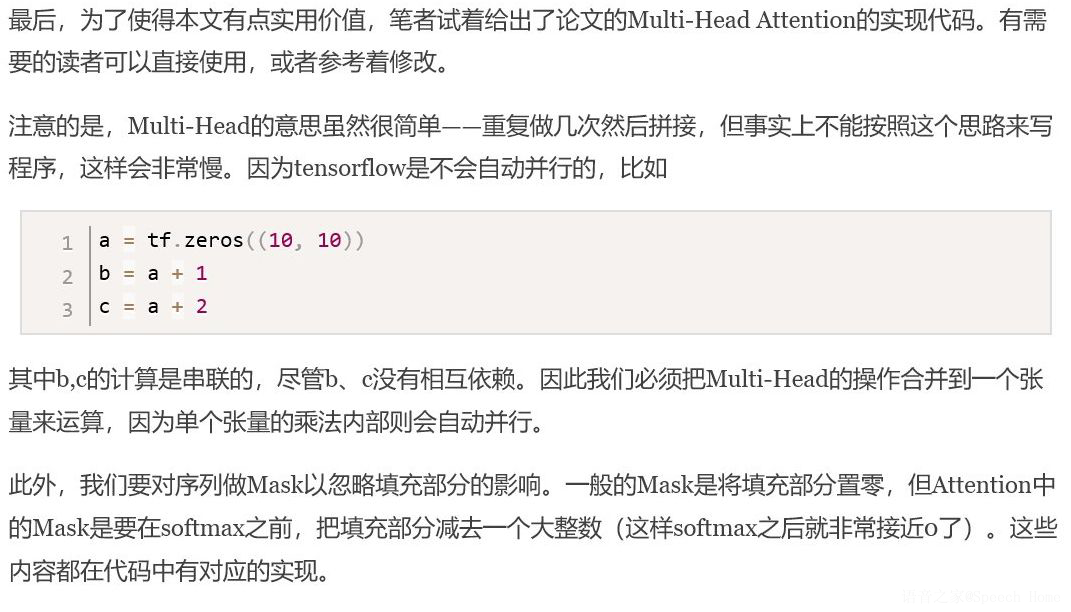
tensorflow版
下面是tf的实现:
https://github.com/bojone/attention/blob/master/attention_tf.py
Keras版
https://github.com/bojone/attention/blob/master/attention_keras.py
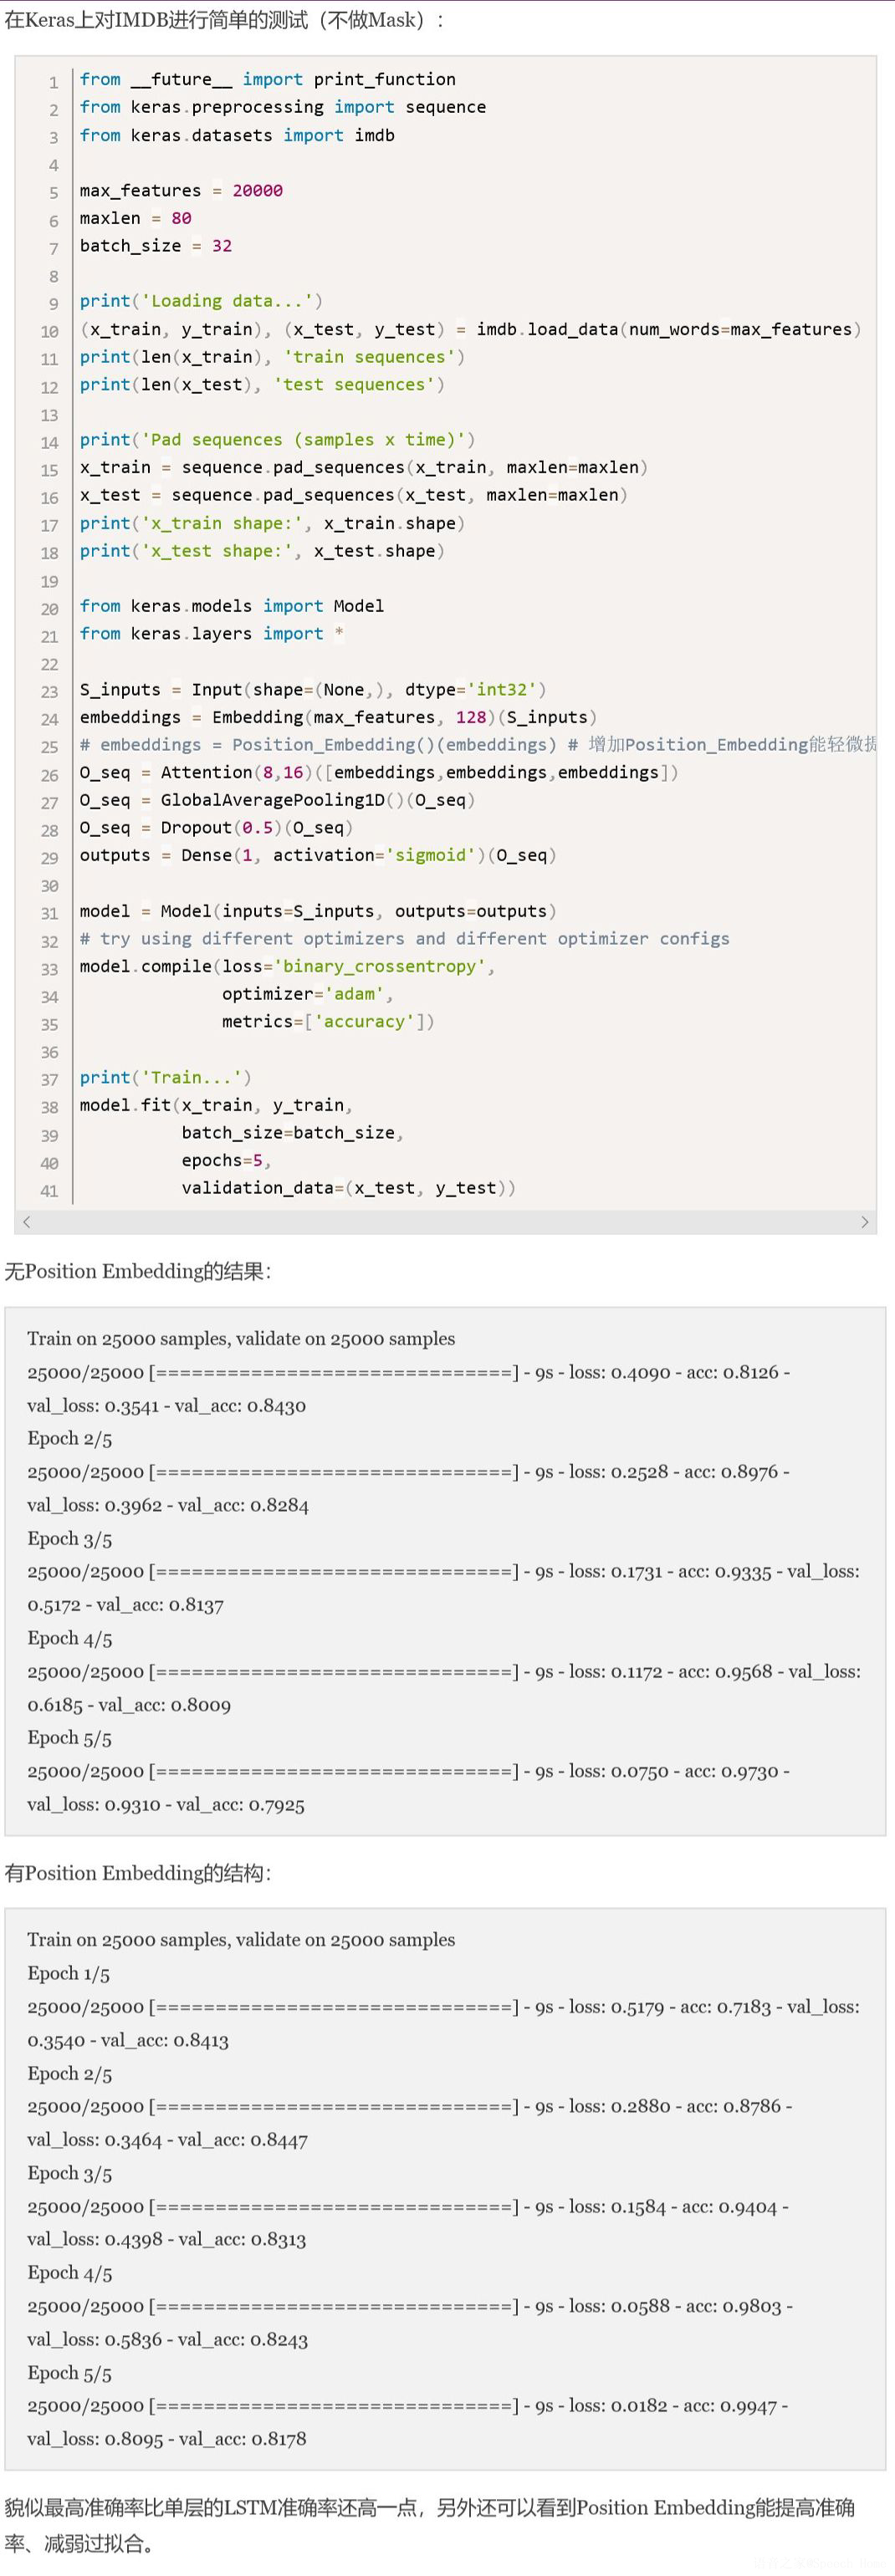
代码测试
计算量分析
可以看到,事实上Attention的计算量并不低。比如Self Attention中,首先要对XX做三次线性映射,这计算量已经相当于卷积核大小为3的一维卷积了,不过这部分计算量还只是O(n)O(n)的;然后还包含了两次序列自身的矩阵乘法,这两次矩阵乘法的计算量都是O(n2)O(n2)的,要是序列足够长,这个计算量其实是很难接受的。
这也表明,restricted版的Attention是接下来的研究重点,并且将Attention与CNN、RNN混合使用,才是比较适中的道路。
结语
感谢Google提供的精彩的使用案例,让我等在大开眼界之余,还对Attention的认识更深一层。Google的这个成果在某种程度上体现了“大道至简”的理念,的确是NLP中不可多得的精品。本文围绕着Google的大作,班门弄斧一番,但愿能够帮助有需要的读者更好的理解Attention。
