
 语音小管家
一、语音合成技术简介
语音合成,通常又称文语转换(Text To Speech,TTS),是一种可以将任意输入文本转换成相应语音的技术,是人机语音交互中不可或缺的模块之一。如果说语音识别技术是为了让机器能够“听懂”人说话,那么语音合成技术则让机器能够跟人“说话”。无论是在地图导航、语音助手、教育、娱乐等软件应用,还是在智能音箱、家电、机器人等硬件设备中,都有语音合成技术的身影。
如图 1 所示,语音合成系统通常包含前端和后端两个模块。 前端模块主要是对输入文本进行分析,提取后端模块所需要的语言学信息。对中文合成系统来说,前端模块一般包含文本正则化、分词、词性预测、多音字消歧、韵律预测等子模块。后端模块根据前端分析结果,通过一定的方法生成语音波形。后端模块一般分为基于统计参数建模的语音合成(Statistical Parameter Speech Synthesis,SPSS,以下简称参数合成),以及基于单元挑选和波形拼接的语音合成(以下简称拼接合成)两条技术主线。
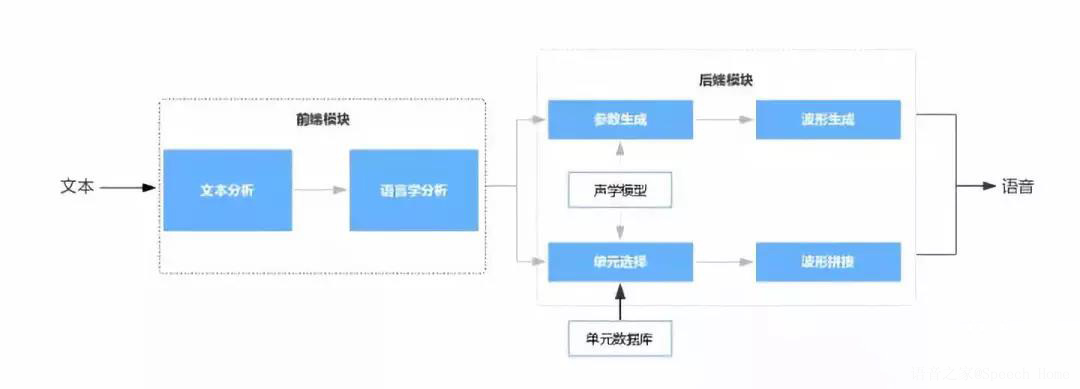
参数合成在训练阶段对语音声学特征、时长信息进行上下文相关建模,在合成阶段通过时长模型和声学模型预测声学特征参数,对声学特征参数做后处理,最终通过声码器恢复语音波形。该方法可以在音库相对较小的情况下,得到比较稳定的合成效果。缺点是统计建模带来的声学特征参数过平滑问题,以及声码器对音质的损伤。
拼接合成通常也会用到统计模型来指导单元挑选,训练阶段与参数合成基本相同。在合成阶段通过模型计算代价来指导单元挑选,采用动态规划算法选出最优单元序列,再对选出的单元进行能量规整和波形拼接。拼接合成直接使用真实语音片段,可以最大限度保留语音音质;缺点是需要的音库一般较大,而且无法保证领域外文本的合成效果。
传统的语音合成系统一般采用隐马尔可夫模型来做统计建模。近年来,深度神经网络由于其较高的建模精度,被越来越多地应用到语音合成领域。语音合成技术中用到的神经网络模型主要有 DNN、RNN、LSTM-RNN(以下简称 LSTM)等。在 2012 年成立之初,云知声发布了国内首个基于深度神经网络的语音识别公有云平台。同样地,在语音合成领域,云知声也将深度神经网络技术应用到自己的合成引擎中。
二、云知声基于 LSTM 的参数合成系统
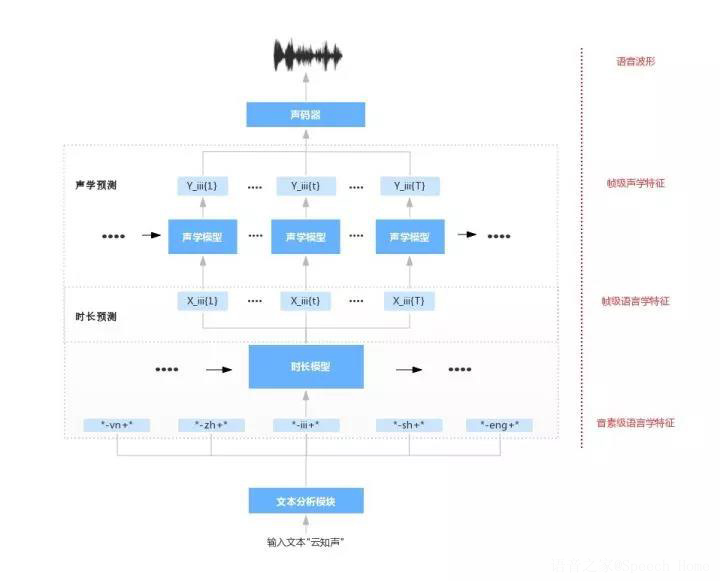
云知声参数合成系统框架如图 2 所示,主要包括文本分析、时长模型、声学模型、声码器等模块。对于一句输入文本,首先经过文本分析得到音素级别上下文相关语言学特征;然后根据时长模型预测结果扩展到帧级别特征,作为声学模型的输入;最后把声学模型输出的声学特征参数送入声码器,输出语音波形。这里我们采用 LSTM 做声学和时长建模,并且使用延迟输出和跳帧输出的策略,在提升建模效果的同时可以有效降低运算量。引入 Tacotron 系统中的 CBHG 网络对 LSTM 层的输出做后处理,以保证声学特征参数的平滑性。此外,还采用了生成式对抗网络,来得到更加自然的合成语音。接下来我们详细介绍云知声参数合成系统所采用的模型结构以及相关技术细节。
2.1 基于 LSTM 的统计参数建模
长短时记忆(Long Short Term Memory,LSTM)网络具有强大的序列建模能力,而 Bi-directional LSTM 由于能够充分考虑序列的上下文信息而得到广泛应用。在语音合成任务中,考虑到流式处理的需要,我们采用单向 LSTM 网络。为了更好地对输入特征进行抽象,在 LSTM 层之前加了两层全连接网络。
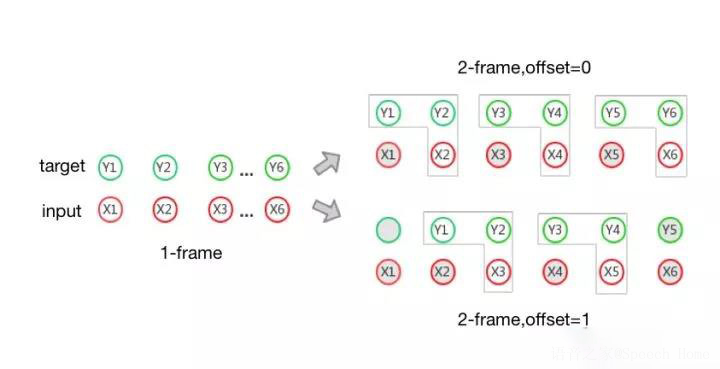
为了使单向 LSTM 网络也能够观测到未来的输入信息,我们采用了延迟输出策略。具体做法是在得到若干帧后的输入信息之后,才开始给出第一帧的输出。另外,为降低计算量,采用了跳帧输出策略。对于连续的 N 帧,只需要提供最后一帧的输入,即可得到全部 N 帧的输出序列,从而有效降低了计算量。LSTM 模型不像 BLSTM 那样可以输出平滑的特征参数,而采用 RNN 代替全连接作为输出层,可以得到更加平滑的特征参数输出。
2.2 CBHG 网络
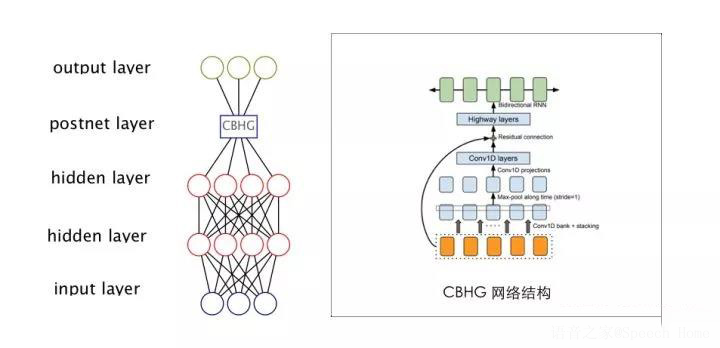
采用 RNN 作为输出层,可以生成平滑的谱参数,但是基频参数还是有比较明显的不平滑问题。为了解决这个问题,我们引入了 Tacotron 系统中用到的 CBHG(1-D convolution bank + highway network + bidirectional GRU) 网络。CBHG 网络结构如图4 所示,由一维卷积滤波器组,加上 Highway 网络和一个双向 GRU 网络组成。CBHG 是一种非常强大的网络,常被用来提取序列的表征。在 LSTM 网络后面加上 CBHG 网络,可以有效改善输出特征参数不平滑的问题,并进一步提升模型预测精度。
2.3 生成式对抗网络
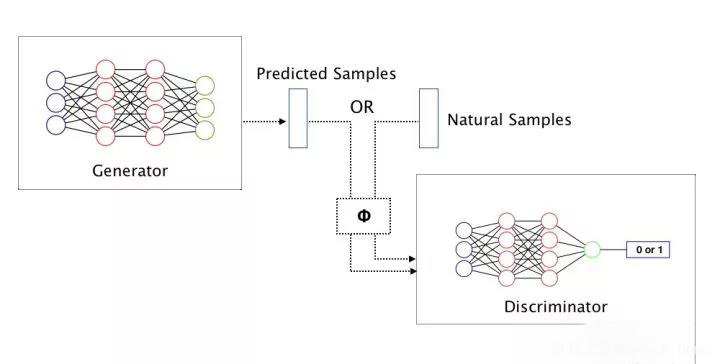
生成式对抗网络(Generative Adversarial Network,GAN)作为一种强大的生成式模型,已经成功地被应用到图像生成和其他一些领域。GAN 的结构如图 5 所示,由一个生成器 G 和一个鉴别器 D 组成。其中 G 作为参数合成系统中的声学模型,目标是生成逼近自然语音的特征参数;而 D 的作用是评估 G 输出的声学特征与真实的声学特征的相似度,并通过梯度的方式传递给 G,从而调整生成网络使得输出的声学特征更加逼近自然语音。采用 GAN 的网络结构,可以有效缓解参数合成带来的声学特征参数过平滑问题,从而使合成语音更加真实自然。传统 GAN 的生成器以随机噪声作为输入,这里输入的是语言学信息。而 G 的损失函数在传统损失函数基础上,还加入了输出声学特征和真实声学特征的均方误差。在训练阶段分别对 G 和 D 进行交叉训练,即在每次迭代先固定 D 的参数, 对 G 进行训练;然后再固定 G 的参数, 对 D 进行训练。
2.4 多发音人、多语种混合建模
传统的语音合成系统,对于每一个语种的每个发音人都要单独训练一个模型。考虑到 LSTM 强大的建模能力,我们完全可以用一个模型来对多个语种和多个说话人建模。为了简单起见,我们在系统中使用不同语种的语言特征集合作为模型的输入特征,另外还加入了语种标记和说话人标记,用来区分不同的语种和说话人。
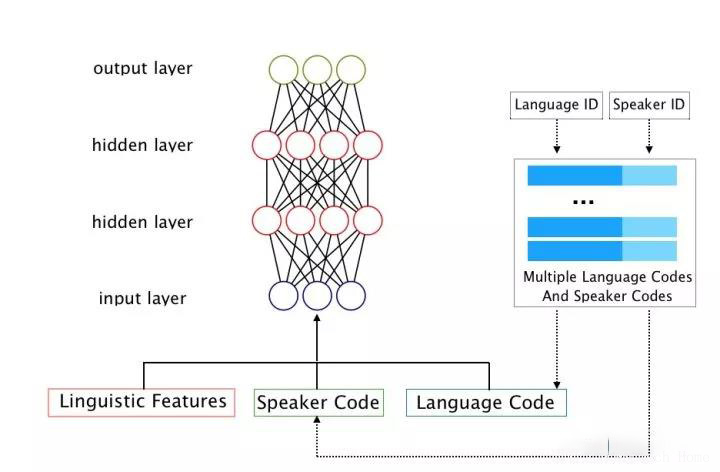
图6 多语种、多说话人联合建模
三、语音合成新方法
上述的语音合成系统基于传统参数合成框架,将其中的声学和时长模型采用深度神经网络来实现。相比于传统的参数合成,该系统可以输出更高自然度的合成语音,但是并没有跳出传统参数合成的框架。
近年来,一些新的语音合成方法不断被提出,并且取得了比较理想的合成效果。比如 DeepMind 团队提出的 WaveNet 合成系统,通过构建一个自回归模型,直接对时域采样点建模,得到了高自然度的合成语音。而 Yoshua Bengio 团队提出的 Char2Wav 和 Google 提出的 Tacotron 系统,则是直接建立输入文本到输出语音的映射关系,实现了端到端的语音合成,合成语音效果能够接近真人发音的水平。云知声在这个领域也做了大量的研究工作,并且取得了积极的进展。后续我们将为大家介绍语音合成技术的新方法,以及云知声在这方面最新的研究成果。
四、参考文献
Zen H, Sak H. Unidirectional long short-term memory recurrent neural network with recurrent output layer for low-latency speech synthesis[C]//Acoustics, Speech and Signal Processing (ICASSP), 2015 IEEE International Conference on. IEEE, 2015: 4470-4474.
Zen H, Agiomyrgiannakis Y, Egberts N, et al. Fast, compact, and high quality LSTM-RNN based statistical parametric speech synthesizers for mobile devices[J]. arXiv preprint arXiv:1606.06061, 2016.
Li B, Zen H. Multi-Language Multi-Speaker Acoustic Modeling for LSTM-RNN Based Statistical Parametric Speech Synthesis[C]//INTERSPEECH. 2016: 2468-2472.
Saito Y, Takamichi S, Saruwatari H. Statistical Parametric Speech Synthesis Incorporating Generative Adversarial Networks[J]. IEEE/ACM Transactions on Audio, Speech, and Language Processing, 2018, 26(1): 84-96.
Yang S, Xie L, Chen X, et al. Statistical parametric speech synthesis using generative adversarial networks under a multi-task learning framework[J]. arXiv preprint arXiv:1707.01670, 2017.
Wang Y, Skerry-Ryan R J, Stanton D, et al. Tacotron: Towards end-to-end speech syn[J]. arXiv preprint arXiv:1703.10135, 2017.
