
 语音小管家
语音开源模型这么多,你还在为如何部署烦恼吗?各种模型环境各式各样,你还在为安装环境晕头转向吗?老板说隐私很重要,要出一个离线的demo,你还在犹豫不知如何下手吗?语音那么多任务,又是vad,又是说话人,还得做识别合成,你还在为组合方案费尽心机吗?那么,别等了!今天给你安利一款快如闪电、轻如羽毛的语音AI神器——sherpa-onnx!✨它就像智能语音界的瑞士军刀🔧,小巧却全能:离线识别、多语言支持、一键部署,连树莓派都能轻松带飞!再也不用担心网络延迟或隐私泄露,毕竟——你的声音,只配被本地CPU悄悄宠幸💻!(我让deepseek写点俏皮话,这是它的答案..)
Sherpa onnx 是什么呢?且听我一一道来!(一定要看到最后,有惊喜!!!)
九大任务全搞定
Sherpa-onnx 虽然是新一代 Kaldi 的子项目,但经过军哥的多年打磨,早已不是单纯的语音识别推理框架,称呼它一声六边形战士它都不带脸红的。现在的Sherpa onnx 集成了语音的九大类任务,提供统一的 C++ 运行时,标准的 API, 让你体验模型一条龙,轻松无痛搭建 Demo 和原型系统,胆子大一点技术靠谱些,直接做成产品卖钱不是梦!那么 Sherpa onnx 具体支持了哪些任务呢,它们是语音识别(ASR),语音合成(TTS),说话人分离/确认(SID,SD,SV),话音检测(VAD),关键词检索(KWS),语音增强(SE),声音标签(AT),声源分离(SS),语言检测(SLID)等。所有这些任务都提供了预训练模型,开箱即用,随你选用!
开源模型全家桶
开源模型太多了?文档太复杂了?不知道 sherpa-onnx 里面具体支持啥模型,这里一次给你讲清楚!也欢迎大家推荐优秀的开源模型,大家一起来完善整个智能语音服务的生态。
语音识别(ASR)
语音识别一直是新一代 Kaldi 的主阵地,所以语音识别提供的模型是最多的。首先当然是我们自己研发的zipformer模型,在文档里 pretrained models 列的模型里,有 zipformer 相关字眼的都是,这些模型有些是我们自己训练的,有些是社区的朋友们贡献的。CTC 模型和 Transducer 模型都有,目前看大家最常用的是流式中英文(Bilingual 模型),当然其他如中文,英语、粤语、法语、俄语、韩语、日语、越南语、泰语等模型都有。 另外,我们还对第三方优秀的开源模型做了很好的支持,比如,最近一两年阿里也开源了很好的语音识别模型,sherpa-onnx 也支持了其中了paraformer和sensevoice。英伟达的 Nemo 里的很多开源模型也做了支持(比如 conformer ctc 等),英伟达最近开源的Parakeet tdt系列,sherpa-onnx 也支持了,文档里搜 nemo 相关字眼,ctc,tdt,transducer 模型都有,而且语言也很全。另外,像whisper系列从 tiny 到 large 都做了支持。还有国内公司开源的一些大规模数据的仿 whisper 模型,例如,电信的TeleSpeech,UsefulTensor 的Moonshine,小红书的FireRedAsr和 DataOcean 的Dolphin等。
语音合成(TTS)
语音合成任务,sherpa-onnx 目前大部分都是非零样本克隆的模型,比如vits模型,koroko,kitten,matcha等,其中 vits 的模型最多,基本涵盖常用的语言。军哥给大家准备了一个 all in one 的列表,里面都有demo,可以试听选用。https://k2-fsa.github.io/sherpa/onnx/tts/all/。 对于零样本克隆的模型,sherpa-onnx 最近也上新了我们自研的zipvoice模型,欢迎大家试用(目前只有 C++ 和 python 的接口)。
话音活动检测(VAD)
VAD 话音检测是语音识别的重要前置模块,目前 sherpa-onnx 支持silero-vad和ten-vad这两个开源模型。
关键词检索(KWS)
关键词检索目前 sherpa-onnx 支持基于zipformer模型的 wenetspeech 训练的一个中文模型,和 gigaspeech 训练的一个英文模型,预训练的模型对有些关键词可能效果不太好,一般通过调参数和微调来提升性能。目前的都是单一语言的模型,后续我们也会推出中英双语的模型。
说话人分离/确认(SI/SD/SV)
说话人的任务,目前sherpa-onnx 支持说话人识别,确认和分离,说话人的任务核心的模块是 说话人向量的提取,目前sherpa onnx 支持3D-speaker,wespeaker和NeMo里面相关模型,对于分离的话,还需要一个 segment 的模型,目前支持pyannote里面的 segmentation 模型。
声源分离(SS)
当前主要支持的是人声和背景音的分离,有两个模型,一个是闻名已久的spleeter,另一个是UVR,文档里搜 source separation 可以找到。
说话语言识别(SLID)
语言识别目前 sherpa-onnx 支持一个基于whisper的模型。
声音标签(AT)
声音事件检测目前支持一个基于 zipformer 的在 audioset 数据集训练的模型。
语音增强(SE)
语音增强一般也叫降噪,目前sherpa-onnx 仅支持gt-crn这一个模型。
全平台支持随你用
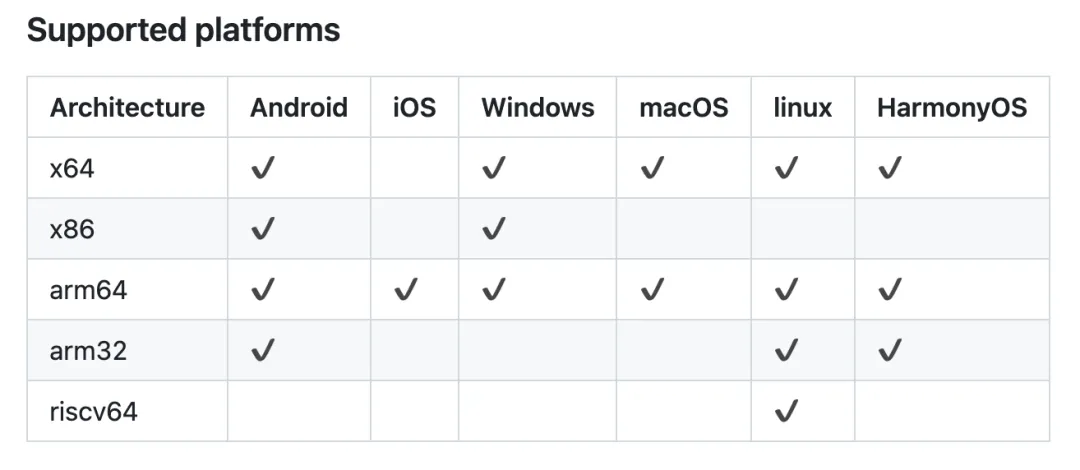
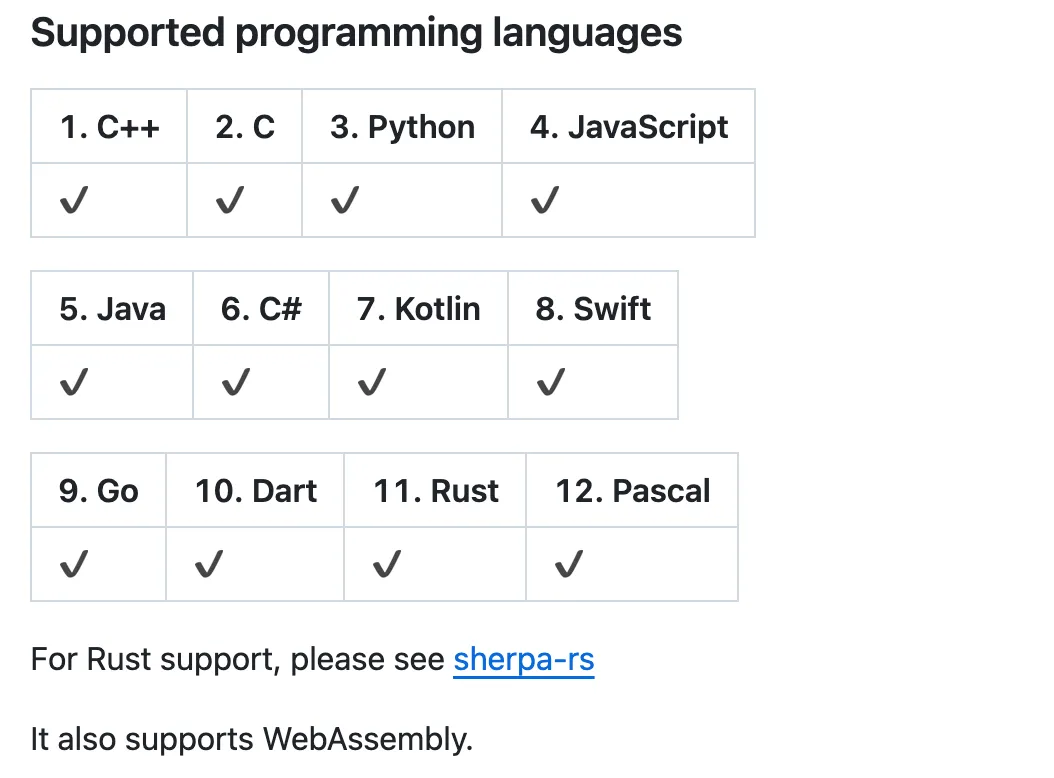
Sherpa-onnx 的全平台是囊括硬件/操作系统/编程语言的真全平台(军哥牛X!!),废话就不多说了,一图胜千言,下面两个图一目了然。这里的支持不仅仅是理论上能在上面跑,而且都提供了详细的样例和代码,严格按照文档来做,应该都能跑起来。
如何开始
Sherpa onnx 已经开发了好几年,各种 features 也是顺次加入的,也许初来者看起来有点复杂,我们的建议是先明确自己想要什么任务什么功能,然后找对应编程语言的examples 文件夹,先把官方提供的 demo 跑起来,然后再针对自己的需求修改。还有很多开发者总是找不到项目的代码和文档,这里加粗给大家!
项目地址: https://github.com/k2-fsa/sherpa-onnx
项目文档:https://k2-fsa.github.io/sherpa/onnx/index.html
