
 语音小管家
AudioCC交我学
在全球化浪潮下,多语种语音识别(Multilingual ASR)技术成为打破语言壁垒的关键支撑。从低资源语种适配到零资源场景突破,从模型效率优化到实际场景落地,近期 Interspeech、ICASSP 等顶会涌现出一系列创新成果。本文梳理了 2025 年多语种 ASR 领域的核心技术方向与代表性研究。
一、背景
当前多语种 ASR 面临三大核心难题:一是全量微调成本高昂,易引发灾难性遗忘;二是不同语种数据分布不均,低资源 / 零资源语种性能堪忧;三是语种识别误差传导,导致跨语种识别精度下降;四是模型缺乏语种无关特征提取能力,难以实现有效迁移。
针对这些痛点,最新研究主要围绕四大方向突破:高效架构设计、跨语种特征迁移、零 / 低资源语种适配、语种识别与 ASR 融合优化,形成了各具特色的技术路径。
二、LoRA 与 MoE 融合,兼顾效率与性能
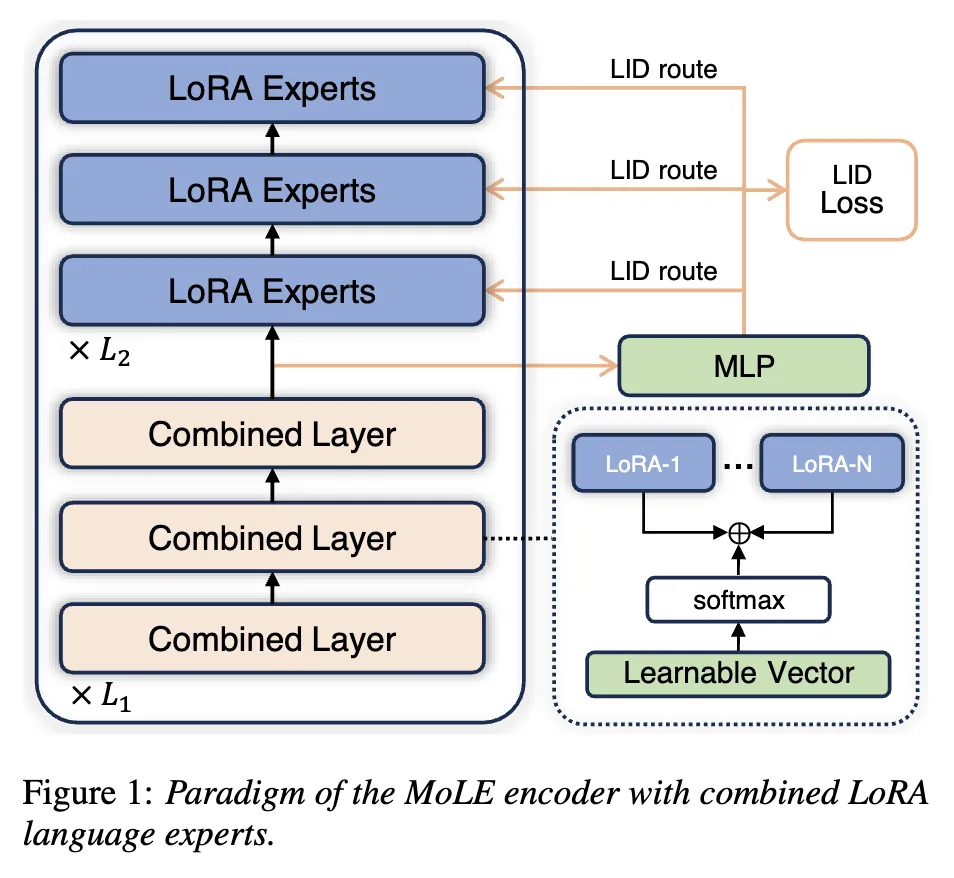
上海交大与腾讯 AI Lab 联合提出的LoRA MoLE(LoRA Language Experts) 架构,创造性地将 LoRA(低秩适配)与 MoE(混合专家系统)结合,解决了多语种微调的核心矛盾。
技术创新:前 L1 层通过联合 LoRA 提取语种识别(LID)特征,指导后续 MoE 层的路由选择,让不同语言对应专属专家模块;再通过层级知识蒸馏,将多个 MoE 参数压缩为单一 LoRA,实现参数高效合并。
实验效果:在中、英、韩、日等 8 种语言上测试,平均 WER(词错误率)低至 7.73%,相比全量微调(727M 参数)成本降低 99% 以上,同时避免了灾难性遗忘。
数据支撑:基于 Whisper-medium 模型,在 10000h 高资源语种(中、英)和 5000h 低资源语种数据上训练,低资源语种(如越南语、印尼语)WER 均有显著下降。
三、音标级特征学习:打破语种边界
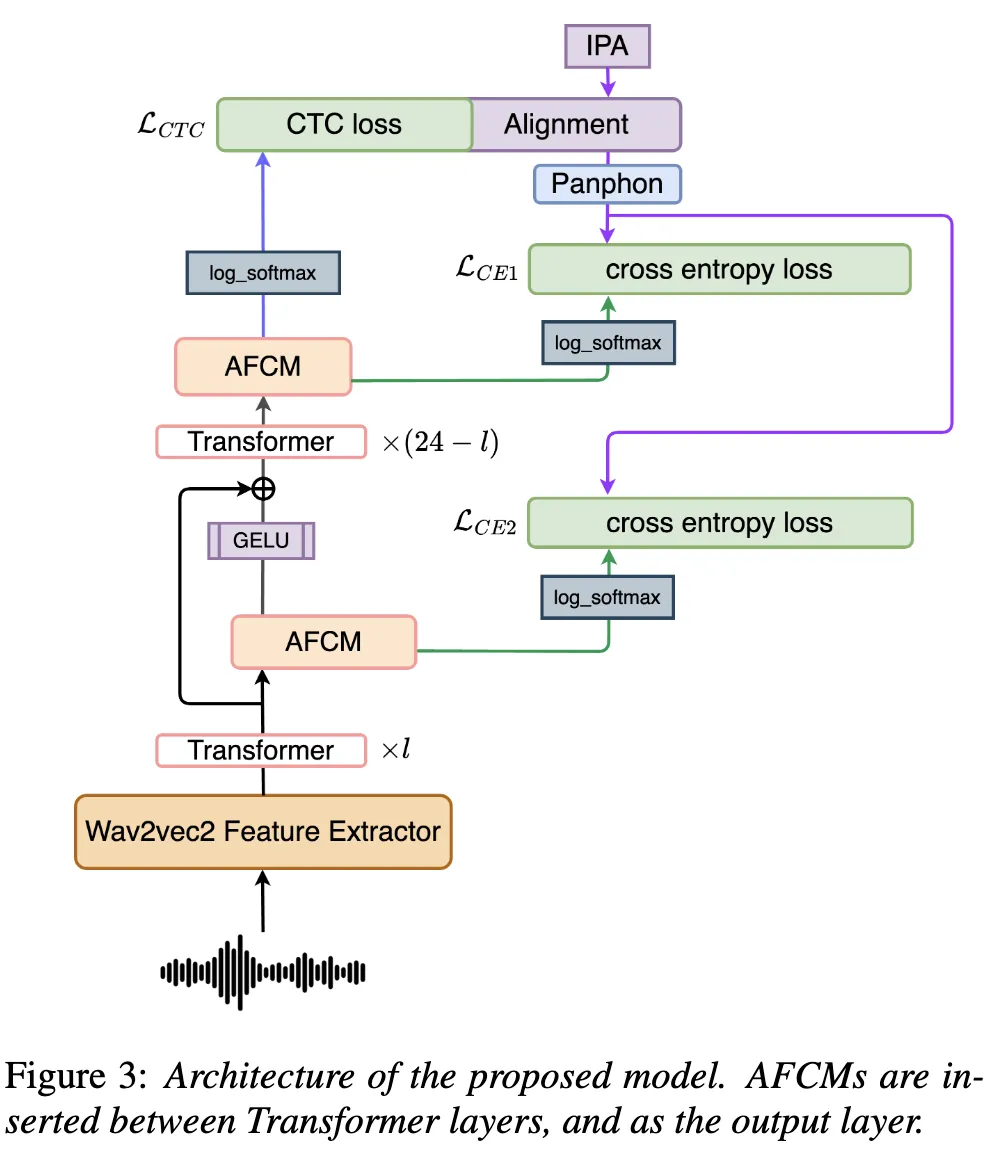
京都大学团队提出基于 IPA(国际音标)的多语种训练方案,针对无文字小语种和低资源语种实现突破:
核心思路:将 IPA 序列作为训练目标,在 Transformer 中间层插入 AFCM(发音特征分类模块),强制模型学习语种无关的语音学特征。
关键优势:无需依赖目标语种文本数据,直接输出 IPA 序列即可完成识别,对 2 种零资源语种测试的 CER(字符错误率)低至 36.48%。
适用场景:无文字小语种、低资源方言等极端场景。
四、Switch Conformer 架构:平衡计算量与迁移能力
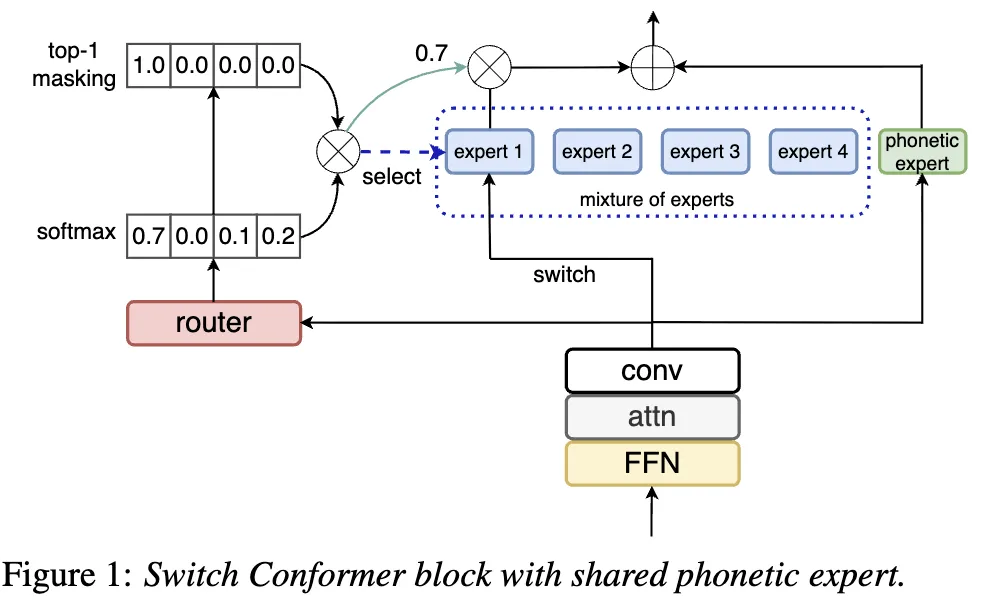
NTT 与京都大学联合提出的Switch Conformer,通过 MoE 替换 Conformer 的 FFN 层,同时引入共享语音专家模块:
技术亮点:采用 Expert Dropout 随机屏蔽专家模块,提升模型鲁棒性;结合 IPA 目标训练,强化跨语种特征迁移。
实验结果:在 Common Voice 10 种语言数据集上,低资源语种(如阿拉伯语、孟加拉语)WER 下降幅度超 15%,计算量较传统 Conformer 降低 30%。
五、Mamba 架构应用:高效处理长上下文与语码转换
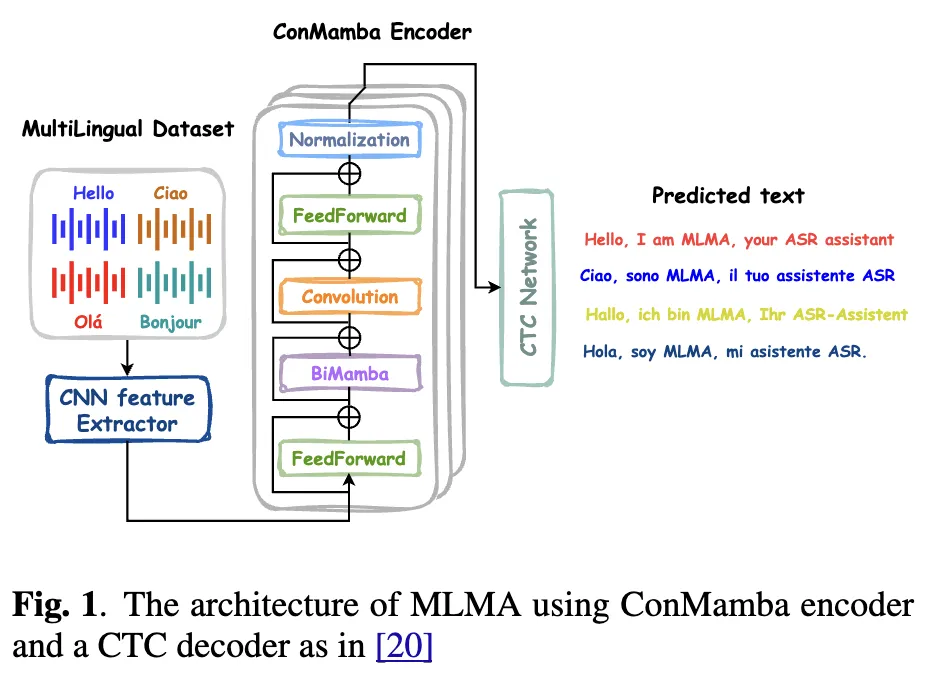
FBK 团队提出的MLMA 模型,将 Conformer 的 MHSA 层替换为 BiMamba,适配多语种长序列与语码转换(code-switching)场景:
核心优势:Mamba 对长序列的高效处理能力,完美适配多语种混合语音;31.6M 参数模型在英、法、德等 6 种语言上的平均 WER 优于传统 Conformer-CTC,且训练成本降低 50%。
六、语种识别与 ASR 融合:提升复杂场景鲁棒性语种验证机制:修正用户标签错误
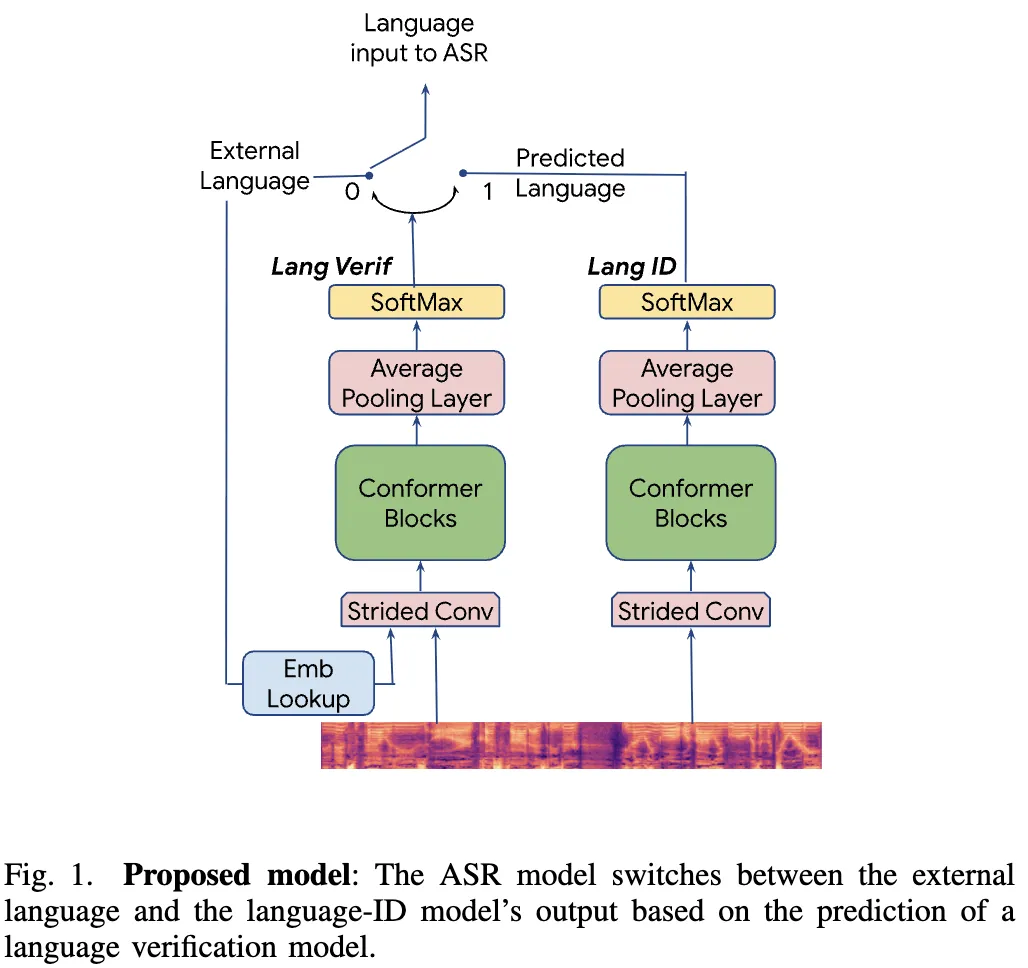
Google 团队针对用户语种标签错误问题,提出语言验证(Lang Verif)+LID 融合方案:
核心逻辑:通过 18M 参数的 Conformer 验证模型,判断用户输入的语种标签是否可靠;不可靠时自动切换为 LID 模型预测标签。
实验证明:当错误标签比例达 60% 时,该方案平均 WER 仅 17.5%,较单纯依赖用户标签(23.4%)和单纯依赖 LID(19.9%)均有显著优势。
七、N-best 重排序:修正 LID 错误传导
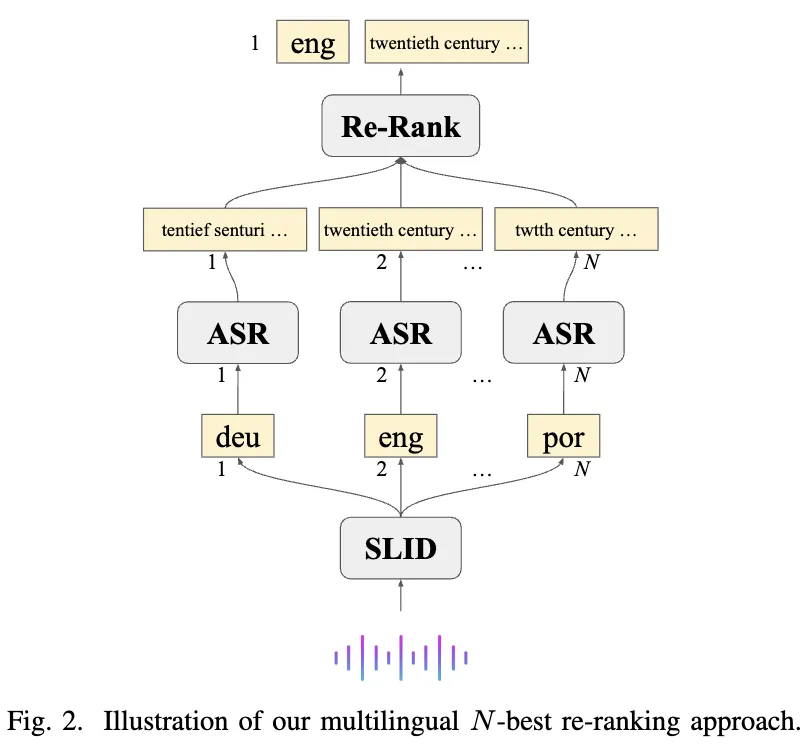
CMU 与 Meta FAIR 联合提出多阶段重排序策略,解决 LID 识别错误导致的 ASR 性能下降:
技术流程:初步 LID 筛选 Top-N 语种→对每个语种执行 ASR→通过语言模型、文本 LID、语音 LID、ASR 模型四者加权重排序。
关键发现:N=2 时即可实现性能与效率的平衡,在 MMS、Whisper、Seamless 三大模型上,平均 WER 相对下降 3%-5%。
八、未见过语种扩展:语言嵌入建模与增量学习
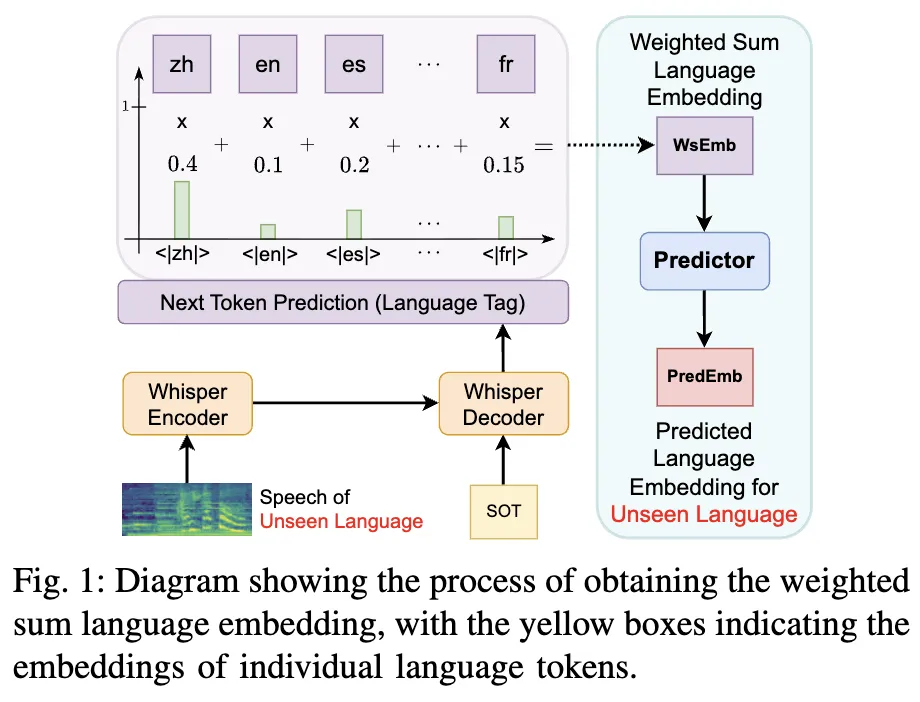
台湾大学团队针对 Whisper 无法处理未见过语种的问题,提出语言嵌入建模方案:
两种路径:一是基于已知语种嵌入的加权求和,二是训练嵌入预测器直接生成未知语种嵌入。
实验数据:在 ml-superb 143 种语言数据集上,对未见过的语种识别 WER 较基线模型下降 12%,且不影响原有 99 种语言的识别性能。
九、结语
多语种 ASR 技术正从 "高资源语种优化" 向 "全场景覆盖" 迈进,高效架构、通用语音学特征、数据高效利用成为三大核心驱动力。未来,随着大模型与语音技术的深度融合,以及跨模态特征迁移能力的提升,多语种语音识别将实现从 "能识别" 到 "准识别" 再到 "全场景适配" 的跨越,为全球化沟通、文化传承、信息普惠提供更强有力的技术支撑。
