
 语音小管家
AudioCC交我学
在当前大模型飞速发展的背景下,我们正在见证一系列基础架构的创新突破。本文将从技术角度深入解析门控注意力、线性注意力和扩散语言模型三大创新,探讨其设计动机、实现路径与发展趋势。
一、架构创新的共同驱动力
随着模型规模不断扩大,传统Transformer架构在长上下文处理、训练稳定性和推理效率方面面临严峻挑战。二次复杂度的注意力机制成为主要瓶颈,而单纯增加参数量的方法也面临边际效益递减的问题。
在此背景下,架构层面的创新成为突破当前技术瓶颈的关键路径。三大技术创新从不同角度出发,共同推动着大模型技术向更高效、更稳定的方向发展。
二、门控注意力:重新思考注意力机制的表达能力
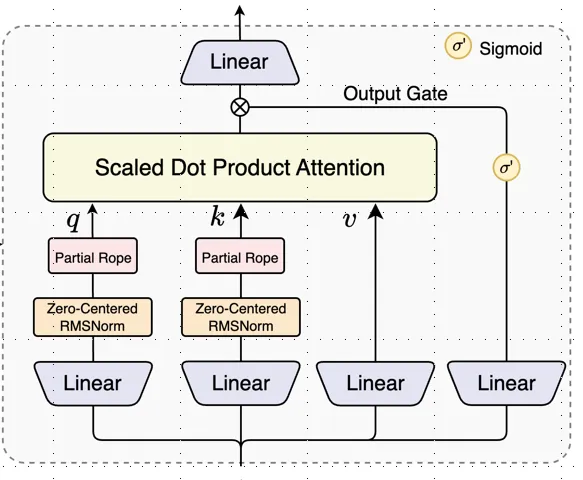
技术动机:
传统注意力机制存在明显的表达力瓶颈。价值投影和输出投影两个连续的线性变换,实际上构成了一个低秩线性映射,限制了模型的表达能力。同时,注意力下沉(Attention Sink)现象和长度外推能力不足等问题也亟待解决。
核心实现:
门控注意力的关键创新在于在SDPA(缩放点积注意力)输出后引入头特异性(head-specific)的Sigmoid门控。这一设计看似简单,却带来了多方面的显著提升:
1. 非线性增强:在连续线性变换间插入非线性激活,打破表达力瓶颈
2. 动态稀疏性:基于查询的依赖输入稀疏性,实现智能信息过滤
3. 训练稳定性:有效消除注意力下沉和异常激活现象
发展意义:
门控注意力的重要性在于它揭示了注意力机制中尚未被充分挖掘的潜力。阿里巴巴Qwen3-Next团队将其应用于25%的关键注意力层,在保持性能的同时显著提升训练稳定性。
三、线性注意力:从理论突破到工程实践
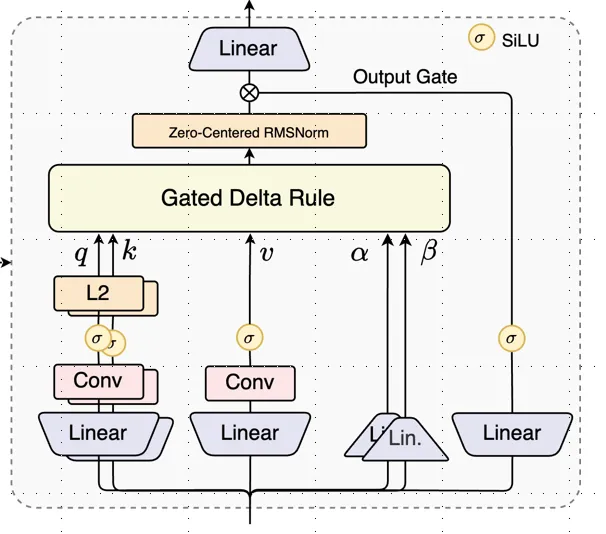
技术动机:
传统Softmax注意力的二次计算复杂度严重制约了长上下文处理能力。尽管有FlashAttention等内存优化技术,但时间复杂度的根本问题仍未解决。长序列场景下的应用需求推动了线性复杂度解决方案的探索。
技术演进路径:
线性注意力的发展经历了从简单模仿到理论创新的
完整历程:
1. 初期探索:直接去除softmax的朴素线性化方案,但存在记忆模糊问题
2. 遗忘机制引入:通过衰减因子缓解记忆过载,但表达能力受限
3. 理论突破:TTT(Test-Time Training)框架为线性注意力提供理论指导
4. DeltaNet:基于Delta规则实现精确记忆更新
5. Gated DeltaNet:结合门控机制的自适应记忆控制
工程价值:
Gated DeltaNet作为线性注意力的先进代表,在Qwen3-Next架构中承担了75%网络层的处理任务,实现了长上下文下的高效计算,为模型支持百万级上下文奠定基础。
四、扩散语言模型:生成范式的新探索
范式创新:
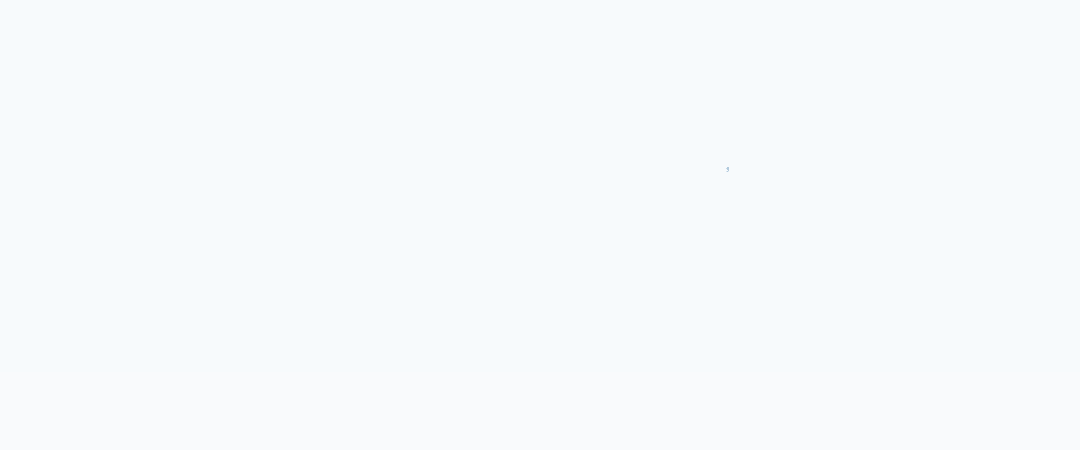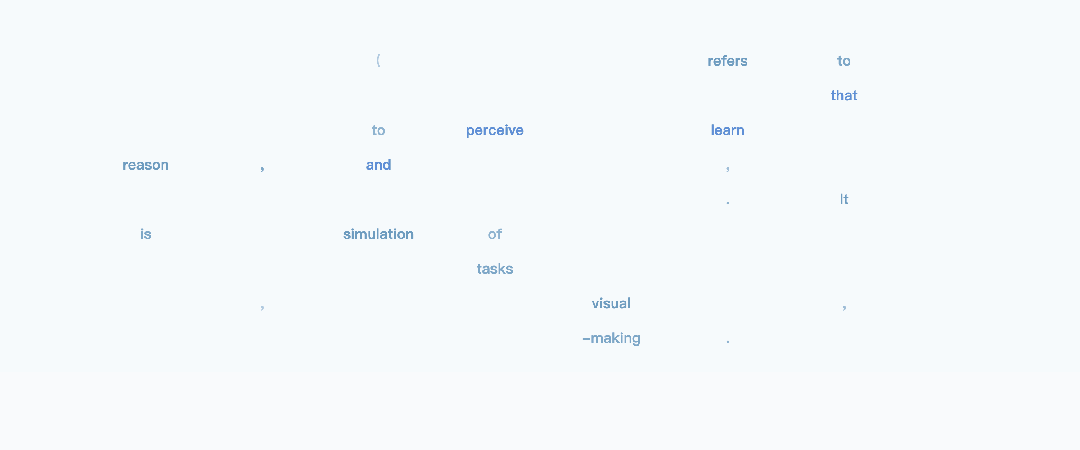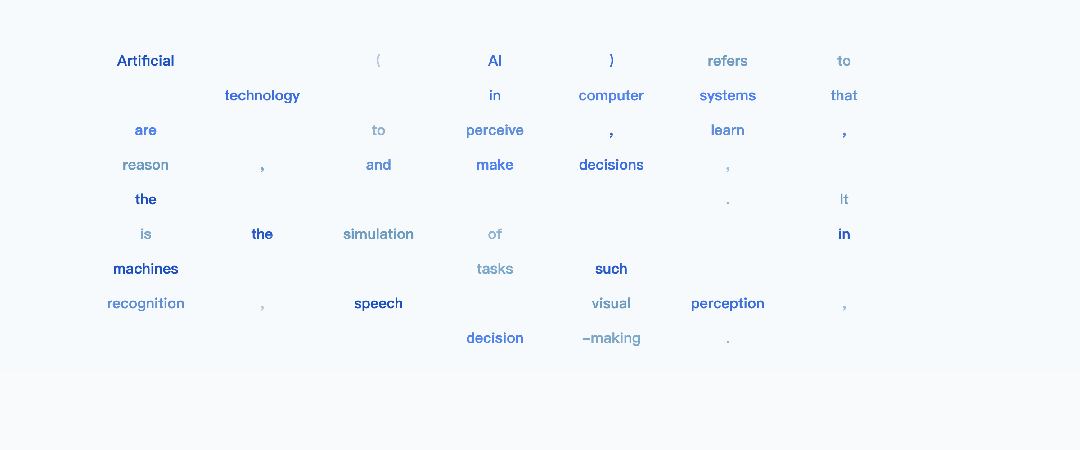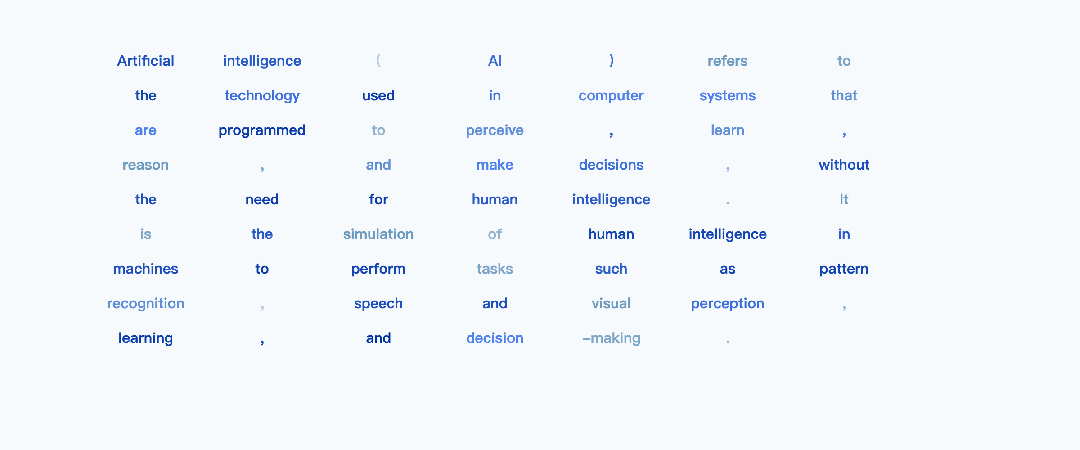
扩散语言模型代表了与传统自回归生成截然不同的技术路径。其核心思想是将文本生成过程重新构建为迭代去噪过程,突破自回归生成的方向性限制。
技术特点:
扩散语言模型的优势体现在多个维度:
1. 双向上下文利用:在生成过程中充分利用全文信息,避免自回归的错误累积
2. 迭代优化能力:通过多轮细化逐步提升生成质量
3. 理论一致性:与扩散模型的数学理论基础保持统一
实践进展:
LLaDA和Dream等工作证明了扩散语言模型在大规模预训练和监督微调中的可行性。虽然当前面临推理速度的挑战,但D2F等加速技术已显示出将推理速度提升至自回归模型1.6-2.5倍的潜力。
五、技术融合与系统优化
混合架构实践:
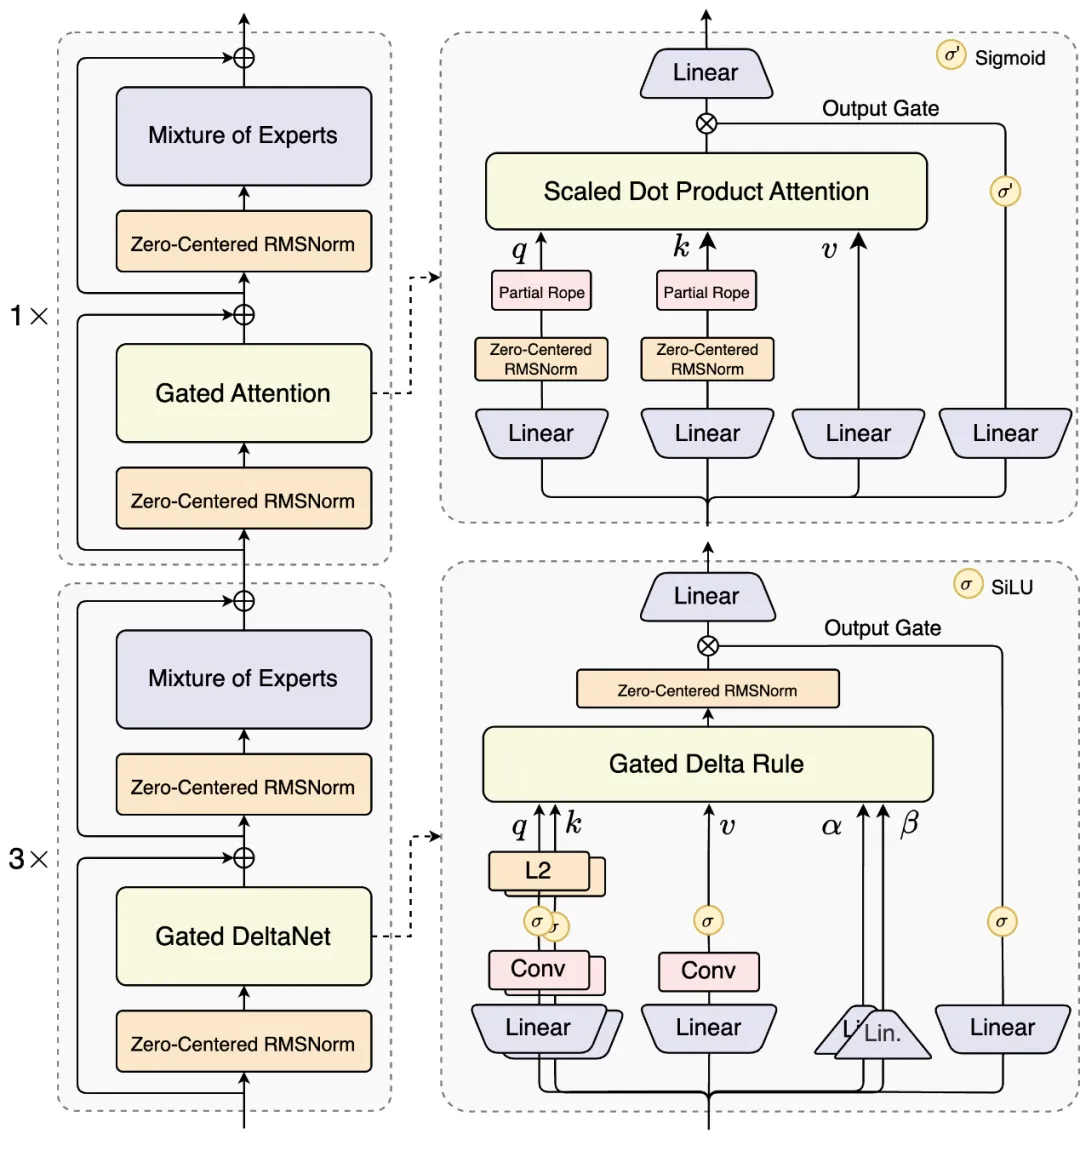
Qwen3-Next的混合注意力架构代表了技术融合的先进实践。3:1的Gated DeltaNet与Gated Attention组合,实现了效率与性能的优化平衡。
系统级优化:
除了核心算法创新,配套的系统优化同样重要:
• Zero-Centered RMSNorm提升训练稳定性
• MoE路由参数归一化确保专家均衡利用
• 多token预测机制优化推理效率
六、技术展望与挑战
近期发展趋势:
1. 算法层面:门控机制的普适性研究、线性注意力的理论完备性、扩散模型的加速优化;
2. 系统层面:混合架构的自动化设计、训练推理协同优化、硬件适配创新。
七、结语
门控注意力、线性注意力和扩散语言模型代表了大模型架构创新的三个重要方向。这些技术不仅解决了当前面临的具体问题,更重要的是为我们展示了架构创新的丰富可能性。
在追求更高性能的同时,我们需要持续关注基础理论的深化、工程实践的优化以及不同技术路线的融合创新。未来的大模型架构很可能不是单一技术的胜利,而是多种创新智能组合的结果。
本文基于最新技术文献和工程实践,技术细节可能随研究进展而更新。欢迎学术界和工业界同行共同探讨。
供稿:顾天腾,编辑:方楠,审核:韩冰
