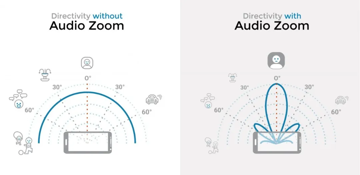
声影随行:音频变焦处理链路解析

想象一下你身处一个拥挤的派对:人声鼎沸,谈笑声不断,酒杯碰撞声此起彼伏。突然,几句话——或许是提到了你的名字——将你拉入了一场远方的对话。对话的两个人离你几米远,但当你把注意力集中到他们身上时,他们的话语似乎变得更加清晰易懂,甚至可能更加响…
22 0 0

想象一下你身处一个拥挤的派对:人声鼎沸,谈笑声不断,酒杯碰撞声此起彼伏。突然,几句话——或许是提到了你的名字——将你拉入了一场远方的对话。对话的两个人离你几米远,但当你把注意力集中到他们身上时,他们的话语似乎变得更加清晰易懂,甚至可能更加响…
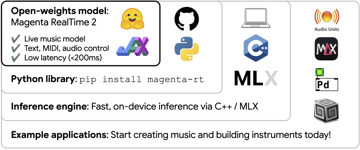
Google Magenta 团队发布并开源了Magenta RealTime 2(MRT2),一个 24 亿参数的实时音乐模型——你可以像演奏乐器一样使用它,并直接在 MacBook(Apple Silicon)本地运行。与"把提示词离线…
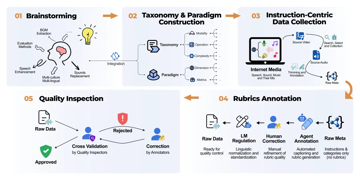
近年来,AI编辑技术取得了显著进展,推动生成模型从单一元素的编辑能力迈向更加灵活的交互式操作范式。在视觉领域,图像编辑模型(如 Nano-banana 2)已逐步走向成熟并进入实际生产流程,而以 Gemini-Omni 为代表的视频编辑模型…
来源丨21db声学人 蛤蜊、海螺这类带壳海洋软体动物和天敌的捕食互动,深刻影响着海岸生态系统,但这类过程大多藏在水下,很难直接观察。贝类能够稳固岸线、净化海水、维系区域生物多样性,是海岸生态平稳运转的关键。可如今受海洋酸化、碎壳型捕食生物活…
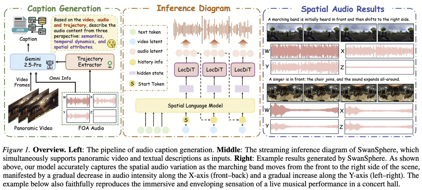
空间音频生成要求模型同时处理声源语义、时间同步和三维方位关系。现有方法通常在生成质量、推理延迟和空间条件建模之间存在取舍:非流式扩散模型依赖较长上下文,难以用于实时场景;通用视频编码器主要关注语义内容,对全景视频中的朝向、运动轨迹和声源位置…
以下文章来源于Amphion 在隐私通话、声带受损恢复等场景中,耳语转正常语音(Whisper-to-Normal, W2N) 技术至关重要。但这一领域长期被一个“死结”困住:数据极度匮乏。 耳语缺乏声带振动和基频,声学线索严重退化,导致转…
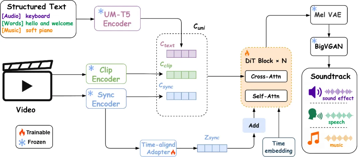
以下文章来源丨NJU语音实验室 南京大学与Video Rebirth 等单位联合提出并开源 Foley-Omni。区别于仅同时支持多种单任务的通用生成模型,Foley-Omni 进一步面向完整视频音轨生成,在统一框架中联合建模语音、音效与音…
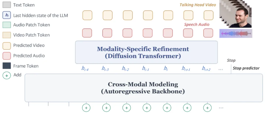
近日,HKUST Audio 团队推出新一代联合音视频生成模型 Talker-T2AV。该模型面向talking head 场景,将传统 TTS 从单一语音生成进一步拓展到 文本到音频+视频联合生成,能够同时生成自然语音与同步的人脸运动,为…
