INTERSPEECH 2026 论文预讲会由中国中文信息学会、CCF语音对话与听觉专委会、深圳市人工智能学会、语音之家发起,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2026 录用论文的作者进行报告交流。
INTERSPEECH 2026 论文预讲会第十一期邀请到清华大学语音与音频技术实验室(SATLab)做本次会议的专场分享,欢迎大家观看。
实验室概况
清华大学语音与音频技术实验室(SATLab)致力于研究语音、音频、音乐、听觉信息处理的理论、方法及其应用。主要研究方向为语音识别与分析、音频识别与分析、音乐与声学信号处理,机器学习等。
实验室牵头承担了自然科学基金重点项目、国家重点研发课题等多个国家项目和企事业单位合作项目,并在多项语音音频技术国际挑战赛中获得冠军。
第十一期清华大学语音与音频技术实验室【专场】
时间:9月17日(周四)19:00 ~ 20:40
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
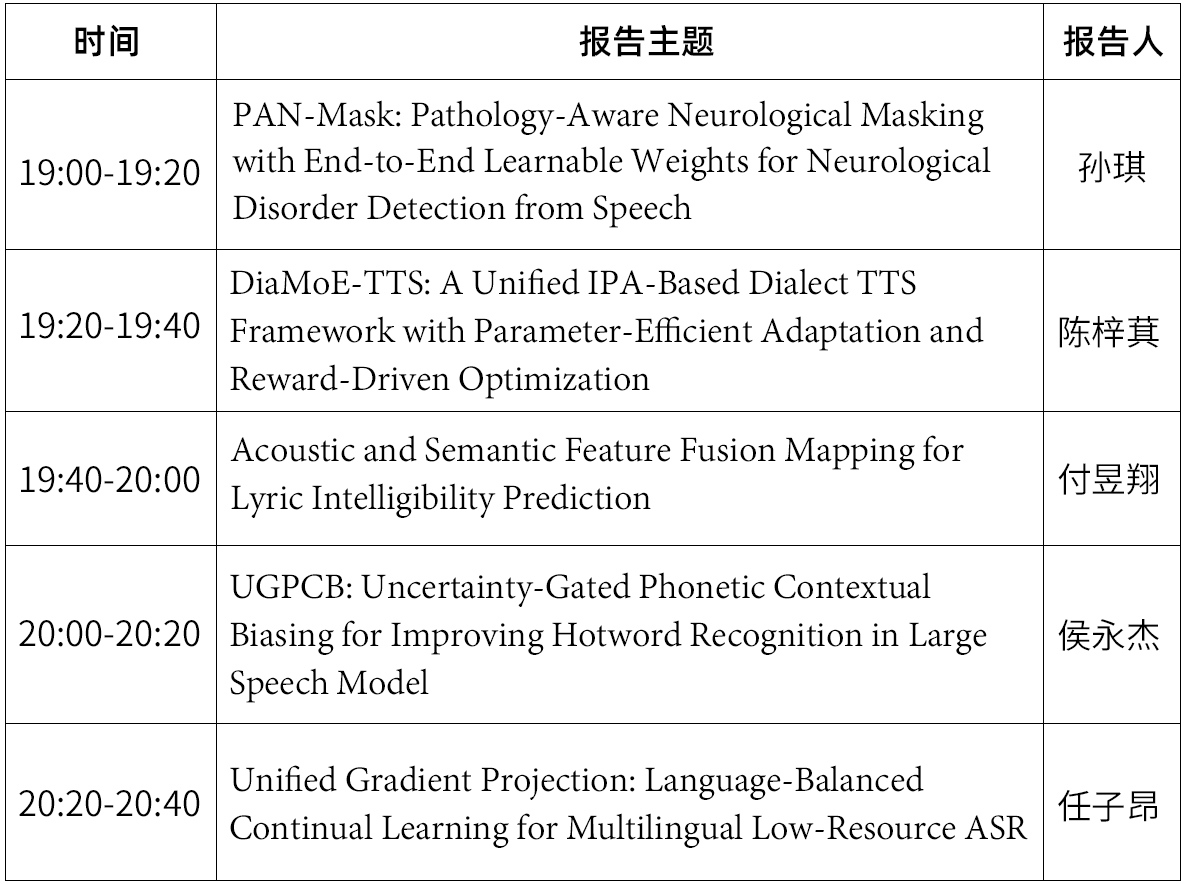
嘉宾&主题
嘉宾简介:孙琪,清华大学SATLab三年级硕士生,研究方向为病理语音分析与语音大模型,聚焦阿尔茨海默病等神经与精神疾病的语音检测。
报告题目:PAN-Mask: Pathology-Aware Neurological Masking with End-to-End Learnable Weights for Neurological Disorder Detection from Speech
摘要:以 WavLM 为代表的自监督模型在语音分类中表现优异,但其内容无关的随机掩码忽视了病理线索稀疏、时间局部的特点,模型也容易过度依赖少数显著帧产生“捷径学习”,影响表征的稳健性。本文提出病理感知掩码框架 PAN-Mask(Pathology-Aware Neurological Masking),通过轻量检测器提取六类可解释声学特征,经可学习注意力聚合为帧级病理显著性,再利用可微软掩码选择性衰减高显著性片段,促使编码器学习更分散、稳健的表征。检测器与分类器端到端联合优化,在不同任务中自适应学习特征权重,无需逐数据集调参。在覆盖三类疾病、五种语言的六个公开数据集上,采用相同超参数时,PAN-Mask 较随机掩码的准确率平均提升 13.82 个百分点,最高提升 22.72 个百分点;仅使用声学信号便在其中五个数据集上超过代表性对比系统。学到的注意力权重还为理解不同疾病的声学特征提供了与临床文献一致的解释线索。
嘉宾简介:陈梓萁,清华大学SATLab三年级硕士生,研究方向为低资源语音识别与合成。
报告题目:DiaMoE-TTS: A Unified IPA-Based Dialect TTS Framework with Parameter-Efficient Adaptation and Reward-Driven Optimization
摘要:方言语音承载着丰富的文化和语言多样性,然而,由于数据稀缺、音系表示不一致以及联合建模中的方言干扰,构建统一的方言文本转语音(TTS)系统仍然具有挑战性。我们探索了一种基于扩散Transformer(DiT)架构的统一方言TTS流程。采用统一的国际音标(IPA)前端来减少跨方言的发音歧义。在F5-TTS框架的基础上,我们引入了一种方言感知的混合专家(MoE)文本编码器,以缓解多方言训练中的风格平均化问题。对于低资源方言扩展,我们采用参数高效微调(PEFT),仅用几小时的语音数据即可实现适应。我们进一步研究了将高质量方言数据纳入统一模型的方法。实验表明,基于GRPO的强化学习降低了目标方言及若干相关方言的词错误率(WER)。
论文链接:https://arxiv.org/abs/2509.22727
嘉宾简介:付昱翔,清华大学SATLab二年级硕士生,研究方向为语音可懂度预测。
报告题目:Acoustic and Semantic Feature Fusion Mapping for Lyric Intelligibility Prediction
摘要:歌词可懂度,即听众理解歌曲歌词的难易程度,会影响听觉体验、记忆效果以及语言学习。本文提出一套基于数据驱动的系统,用于提取声学特征与 Whisper 编码器表征。特征工程包含时序统计量以及相关特征间的交互项,以此提升预测性能。回归模块借助神经网络模型(全卷积网络 FCN、混合专家模型 MOE、卷积门控循环组合 CNN+GRU、Transformer)与梯度提升树(CatBoost、LightGBM、XGBoost),将特征映射为可懂度分数。在人工标注数据集上开展的实验表明,梯度提升树的表现优于神经网络;其中 CatBoost 取得 27.367 的均方根误差(RMSE),相关系数(Corr)为 0.654。实验结果验证了结构化特征建模以及 Whisper 导出表征的有效性。
嘉宾简介:侯永杰,天津工业大学四年级本科生,清华大学SATLab实习生,研究方向为基于大模型的语音识别,聚焦热词增强。
报告题目:UGPCB: Uncertainty-Gated Phonetic Contextual Biasing for Improving Hotword Recognition in Large Speech Model
摘要:自动语音识别(ASR)系统在处理热词时会出现识别偏差。上下文偏置技术通过引入用户自定义词表,能够有效缓解该问题,提升关键词转录准确率。尽管语音匹配技术通过解决子词碎片化问题改进了上下文偏置方案,但现有方法仍存在过度偏置与同音字误判两大难题。针对该问题,本文提出一套无需训练、仅在解码阶段生效的框架:不确定性门控语音上下文偏置(UGPCB)。该框架采用熵驱动门控机制与双模态对比惩罚,基于Dolphin基础模型开展实验。实验结果表明:热词召回率提升16.04%,F1 分数达到90.81%,同时将精确率下降幅度控制在 0.78%以内。即便引入1000个干扰词,召回率依旧提升14.26%,充分证明该方法在自动语音识别任务中的应用潜力。
嘉宾简介:任子昂,北京理工大学四年级本科生,清华大学SATLab实习生,研究方向为多语言语音识别。
报告题目:Unified Gradient Projection: Language-Balanced Continual Learning for Multilingual Low-Resource ASR
摘要:以 Whisper 为代表的大规模预训练语音识别模型在低资源语言上表现仍有不足,通过微调进行适配是常见思路,但顺序适配多种语言时模型往往会破坏已有语言的关键表征,产生灾难性遗忘。针对稳定性与可塑性的矛盾,本文提出一种统一梯度投影(UGP)持续学习框架。该方案在梯度层面对各历史语种均等采样以构建语言均衡的参考梯度,抑制现有方法中的主导语言偏差,并将冲突梯度投影至正交补空间;同时在数据层面深度融合经验回放(ER),锚定参数更新以防止表征漂移。实验结果表明,上述机制的结合可在多个低资源语言组与不同模型规模上显著降低遗忘率,效果优于各类主流基线方法。该研究方法为大规模基础模型的多语言持续适配提供了高效可行的解决方案。
论文链接:https://arxiv.org/abs/2607.11163
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2026 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2026 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。