INTERSPEECH 2026 论文预讲会由中国中文信息学会、CCF语音对话与听觉专委会、深圳市人工智能学会、语音之家发起,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2026 录用论文的作者进行报告交流。
INTERSPEECH 2026 论文预讲会邀请到香港中文大学(深圳)SMIIP Lab在6月29日、6月30日分别做两期专场分享,本文介绍第一场相关内容,欢迎大家预约观看。
实验室概况
香港中文大学(深圳)人工智能学院语音及多模态智能信息处理实验室,Speech and Multimodal Intelligent Information Processing (SMIIP)Lab, 致力于智能语音处理,多模态行为信号分析与理解这两个研究领域,PI为李明老师。智能语音处理领域研究方向:多说话人及抗干扰对话系统,生成式语音增强与提取,多模态具身听觉与对话系统,音频水印与隐私保护;多模态行为信号分析与理解领域研究方向:面向行为评估的多模态大模型后训练,面向行为干预的AI智能体。实验室目前招收博后,研究助理,27年博士生,硕士生等多种职位,欢迎感兴趣的同学联系,mingli369@cuhk.edu.cn。
实验室主页:https://smiip-mli.github.io
第二期-香港中文大学(深圳)SMIIP Lab【第一场】
时间:6月29日(周一)19:00 ~ 20:40
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
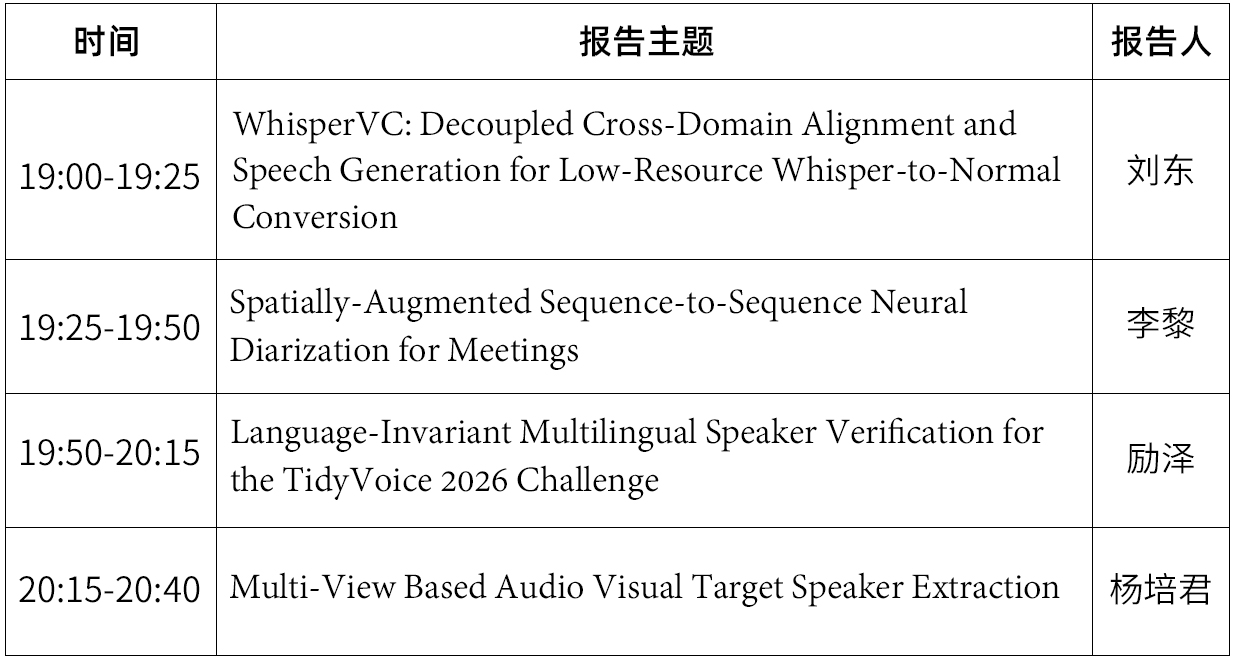
嘉宾&主题
嘉宾简介:刘东,武汉大学计算机学院二年级博士研究生,香港中文大学(深圳)语音及多模态智能信息处理实验室研究实习生。目前研究方向为语音合成、耳语语音修复/转换、全双工对话系统等,目前以第一作者及合作者身份在Interspeech、ICPR、 IALP、ISCSLP、ACM MM等国际会议上发表论文6篇。
分享主题:WhisperVC: Decoupled Cross-Domain Alignment and Speech Generation for Low-Resource Whisper-to-Normal Conversion
作者信息:Dong Liu, Juan Liu, Wei Ju, Yao Tian, Ming Li
论文单位:武汉大学、香港中文大学(深圳)、OPPO
论文链接:https://smiip-mli.github.io/assets/pdf/2026/01/Interspeech_2026_WhisperVC.pdf
Code链接:https://github.com/Raydonld/WhisperVC
Demo链接:https://demo-whispervc.github.io/demo-whispervc
论文介绍:
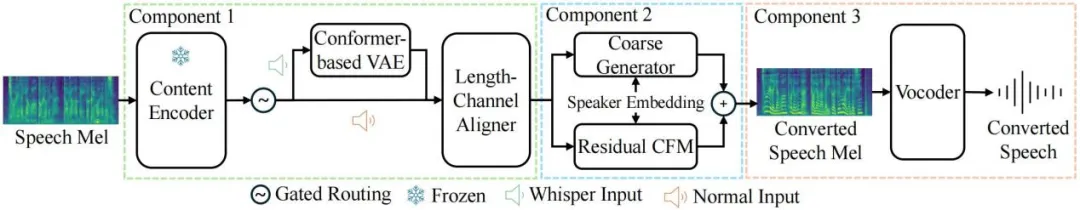
图1 提出的耳语到正常语音转换框架图
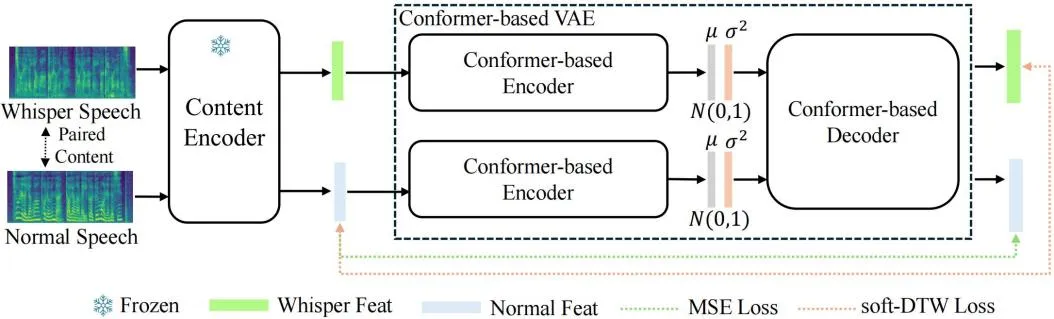
图2 提出的Conformer-based VAE module.
对齐模块训练示意图耳语到正常语音转换旨在将缺乏声带振动的耳语恢复为自然、可懂的正常语音。与普通语音增强不同,耳语不仅表现为能量降低,还缺失稳定的基频信息,并伴随显著的频谱结构变化和时序差异。因此,该任务需要同时恢复语言内容、正常发声特征和说话人音色,是一个具有较高难度的跨域语音生成问题。
现有耳语到正常语音转换方法多采用单阶段声学映射框架,即直接学习从耳语特征到正常语音特征的转换。然而,在低资源条件下,模型需要同时处理耳语—正常语音对齐、说话人建模和声学生成,容易受到跨域差异和数据不足的影响。针对这一问题,本文提出 WhisperVC,一个解耦式的耳语到正常语音转换框架。其核心思想是将 whisper-normal alignment 与 normal-speech generation 分离,使有限的成对耳语—正常语音数据主要用于跨域对齐,而声学生成模块可以更多依赖正常语音数据进行建模。
WhisperVC 由三个阶段组成。第一阶段是耳语特定的跨域语义对齐。模型使用基于 Whisper-large V3 的内容编码器提取语音表示,并引入 Conformer-based VAE 对耳语和正常语音特征进行建模。通过双编码器、共享解码器以及 soft-DTW 对齐损失,模型能够在允许时间弹性变化的条件下,将耳语表示对齐到正常语音表示空间,从而为后续生成模块提供更加稳定的内容条件。第二阶段是正常语音空间中的粗到细声学生成。模型首先通过Length–Channel Aligner 将内容表示调整到与 mel 频谱一致的时间尺度和通道维度,然后由粗粒度 mel 生成器预测整体声学结构。在此基础上,WhisperVC 使用基于 Optimal-Transport Conditional Flow Matching 的残差生成模块,对粗预测结果与真实 mel 频谱之间的残差进行建模。相比直接生成完整 mel 频谱,残差建模将全局结构恢复与局部细节修正解耦,有助于提升低资源场景下的生成稳定性。
在声学生成阶段,WhisperVC 还引入说话人嵌入作为条件,使模型在恢复正常发声形式的同时,尽可能保留目标说话人的音色特征。此外,系统设计了 gated dual-path routing 机制:耳语输入会经过跨域对齐模块,而正常语音输入可以绕过该模块直接进入生成路径。该机制使 WhisperVC 不仅是一个耳语到正常语音转换系统,也能够在统一框架下保留常规语音转换能力。第三阶段是声码器适配。由于推理阶段的mel 频谱由模型预测得到,与真实 mel 频谱存在分布差异,直接使用未经适配的声码器可能影响最终波形质量。因此,WhisperVC 使用预测 mel 对 HiFi-GAN 进行微调,以减小声学生成模块和声码器之间的分布不匹配。
实验结果表明,在AISHELL6-Whisper 中文耳语数据集上,WhisperVC 相比原始耳语输入显著提升了语音质量和可懂度。DNSMOS 从 1.102 提升至 3.072,接近真实正常语音的 3.141;CER 从 22.937% 降低至 16.932%。相比直接使用通用语音转换模型,WhisperVC 也表现出更好的内容保持能力,说明耳语到正常语音转换不能简单依赖普通 voice conversion 模型,而需要专门的跨域对齐与生成机制。
消融实验进一步验证了各模块的作用。去除VAE 跨域对齐后,系统性能明显下降,说明耳语与正常语音之间的表示对齐是关键环节;残差 OT-CFM 相比直接建模完整 mel 更稳定,表明粗到细的生成策略更适合该任务;声码器适配则进一步提升了最终合成语音质量。英文 wTIMIT 数据集上的补充实验也表明,在目标语言数据支持下,该框架具有一定的跨语言适配潜力。
总体而言,WhisperVC 的主要贡献在于将低资源耳语到正常语音转换从单一声学映射问题重新组织为跨域对齐、正常语音生成和声码器适配三个相互解耦的子问题。该框架有效缓解了耳语与正常语音之间的域差异,并在保持语音内容和说话人音色的同时,实现了较高质量的正常语音重建。未来,该方向可进一步探索实时化、轻量化以及面向弱声交流、隐私保护通信和声带术后辅助交流等实际场景的系统部署。
嘉宾简介:李黎,武汉大学计算机科学与技术专业一年级博士研究生,香港中文大学(深圳)语音及多模态智能信息处理实验室研究实习生。研究方向为说话人日志、多说话人语音识别等。
分享主题:Spatially-Augmented Sequence-to-Sequence Neural Diarization for Meetings
作者信息:Li Li, Ming Cheng, Juan Liu, Ming Li
论文单位:武汉大学、香港中文大学(深圳)
论文链接:https://smiip-mli.github.io/assets/pdf/2026/01/Interspeech_2026_lili.pdf
论文介绍:
围绕多通道会议场景下的在线与离线说话人日志任务开展研究,该工作针对真实会议中重叠语音和说话人表征不稳定等问题,探索如何利用空间方位信息提升“谁在何时说话”的建模能力。传统说话人日志方法主要依赖声学特征或说话人嵌入,在多人同时说话或远场会议环境中容易出现混淆。而会议中的说话人通常位于不同空间位置,因此方向到达角(Direction-of-Arrival, DOA)可以提供与声学信息互补的空间线索。基于这一观察,本文提出了 SA-S2SND 框架,将 SRP-DNN 估计得到的 DOA 信息作为显式空间特征注入到 Sequence-to-Sequence Neural Diarization(S2SND)主干模型中,从而增强模型对复杂会议场景的区分能力。
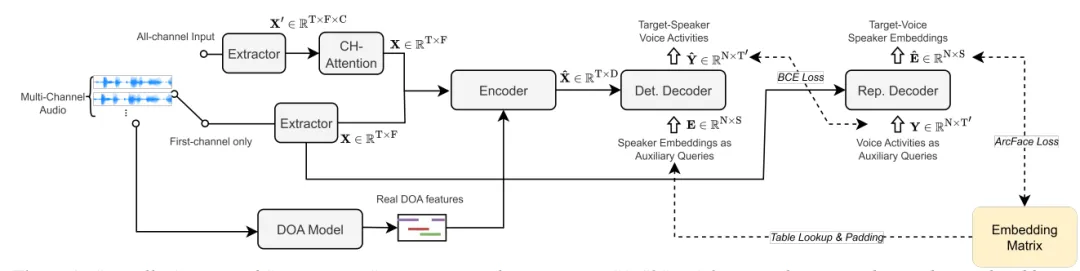
图1 空间增强的序列到序列说话人日志框架
具体而言,SA-S2SND 首先利用 SRP-DNN 从多通道音频中估计活跃说话人的方位信息,并将其离散化为 DOA 矩阵;随后通过插值和线性投影,将空间方位特征与声学表征进行融合。这样,模型不仅能够利用语音内容和说话人表征,还能显式感知说话人的空间位置。该设计类似于为说话人日志模型加入“空间位置编码”,有助于区分时间上重叠但来自不同方向的说话人。此外,本文设计了一个分阶段训练策略:首先训练单通道音频结合 DOA 特征的模型,再进一步扩展到多通道输入,并结合跨通道注意力模块进行优化。同时,论文还引入了模拟 DOA 生成方法,使模型能够在缺乏大规模匹配多通道语料的情况下有效利用空间信息,提升了方法对不同阵列和复杂环境的适应能力。
实验结果表明,SA-S2SND 在 AliMeeting 会议数据集上稳定优于 S2SND 基线。在单通道设置下,引入 DOA 后,系统在离线模式下取得了 7.4% 的相对 DER 降低;当进一步结合多通道注意力时,整体性能提升超过 19%,展现出较强的会议说话人日志性能。
总体而言,该工作通过将显式 DOA 线索与序列到序列神经日志模型相结合,为会议说话人日志提供了一种简单有效的空间增强方案。
嘉宾简介:励泽,武汉大学计算机科学与技术专业三年级硕士研究生,昆山杜克大学语音及多模态智能信息处理实验室研究实习生,研究方向为声纹识别与说话人日志。目前已有五篇以第一作者身份发表的学术论文,被ICASSP、Interspeech、ICME和SLT等国际会议接收。
论文题目:Language-Invariant Multilingual Speaker Verification for the TidyVoice 2026 Challenge
作者信息:Ze Li, Xiaoxiao Miao, Juan Liu, Ming Li
论文单位:武汉大学、昆山杜克大学、香港中文大学(深圳)
代码链接:https://github.com/ZXHY-82/LI-MSV-TidyVoice2026
论文链接:https://smiip-mli.github.io/assets/pdf/2026/01/Interspeech_2026_lize.pdf
论文介绍:
多语言说话人验证(Speaker Verification, SV)由于跨语言训练数据有限,以及说话人嵌入中存在较强的语言相关信息,仍面临较大的挑战。本文介绍了我们在 TidyVoice 2026 Challenge 中提交的说话人验证系统。如图1所示,该系统以大规模多语言自监督预训练模型 w2v-BERT 2.0 为骨干网络,结合层适配器和多尺度特征聚合模块,充分利用不同层级的特征信息以提取更加鲁棒的说话人表示。为增强系统的跨语言泛化能力,本文引入基于梯度反转层(Gradient Reversal Layer, GRL)的语言对抗训练策略,通过减少语言信息对嵌入表示的影响,学习更加语言无关的说话人特征。此外,利用多语言零样本文本转语音(Zero-shot Text-to-Speech, ZS-TTS)系统 Qwen3-TTS 为每位说话人合成多种语言的语音数据,进一步提升训练数据的语言多样性。在 TidyVoice 2026 开发集和评测集上的实验结果表明,基于大规模预训练模型的微调能够显著提升说话人验证性能。相比 ArcFace,SphereFace2 损失函数取得了更优的结果。语言对抗训练能够进一步减弱语言差异带来的影响,提高系统的跨语言鲁棒性;同时,在训练数据有限的情况下,基于合成语音的数据增强策略也能够带来稳定的性能。实验结果验证了所提出方法在多语言场景下的有效性,为构建鲁棒的跨语言说话人验证系统提供了参考。
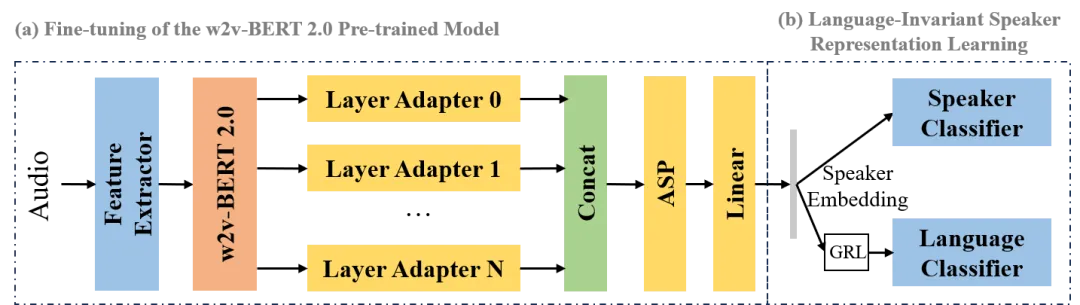
图1 基于 w2v-BERT 2.0 的语言无关说话人验证系统框架
嘉宾简介:杨培君,武汉大学网络安全学院二年级硕士研究生。研究方向为音视频目标说话人分离/提取等。
论文题目:Multi-View Based Audio Visual Target Speaker Extraction
作者信息:Peijun Yang , Zhan Jin , Juan Liu , Ming Li
论文单位:武汉大学、香港中文大学(深圳)
Demo与模型链接:https://b23ca07a.github.io/MVTF-Gridnet
论文链接:https://smiip-mli.github.io/assets/pdf/2026/01/Interspeech_2026_peijun.pdf
论文介绍:
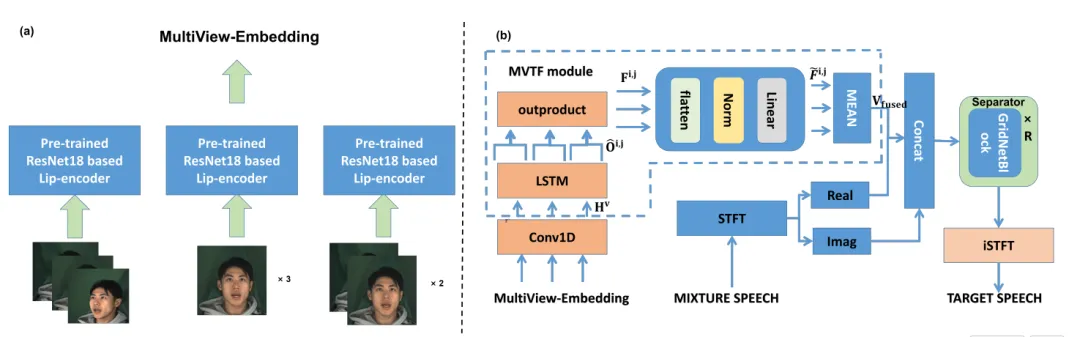
图1 (a) 展示了三种可见情况:三个不同视角、单个视角(复制三次)、两个视角(其中一个视角复制两次)。(b) 展示了 MVTF-GridNet 的整体结构。
在多视角音视频目标说话人提取(AVTSE)任务中,现有方法普遍依赖单一正面视角视频,这在实际场景中难以应对头动或非正面拍摄等常见情况。不同视角的唇部视频往往包含互补的发音运动信息,若能合理利用,有望显著提升模型对视角变化的鲁棒性。
基于这一观察,我们围绕一个核心问题展开研究:如何将多视角唇部嵌入中的互补信息,稳定地转化为单视角测试时的性能增益?论文首先比较了多种跨视角融合方式,包括:
- 投影加法:将各视角特征投影到共享空间后逐元素相加,仅捕捉加性交互;
- 注意力融合:使用交叉注意力机制融合多视角信息,但随机查询-键-值分配导致训练不稳定
- 多视角张量融合(MVTF):通过成对外积显式建模不同视角之间的乘性交互,并引入常数1以同时捕获单模态和双模态信息。
实验发现,简单加法难以建模视角间的非线性互补关系,注意力融合则因随机性而表现不佳。相比之下,MVTF通过成对外积与平均池化,在几乎不增加参数量的前提下,稳定地提升了单视角测试性能。加入重复视角(如将单视角复制三份)的训练策略后,模型依然能够利用训练阶段学到的跨视角知识补偿测试时的视角缺失。
在确定基础融合框架后,论文进一步验证了MVTF在两种测试场景下的表现:
- 单视角输入(模拟实际单摄像头环境):模型在MEAD数据集的七个视角上平均SI-SDR达到15.718 dB,相比仅用正面视角训练的基线提升1.616 dB,尤其对俯视等困难视角增益显著;
- 多视角输入(多摄像头固定场景):任意3个视角组合均能稳定达到约15.85 dB SI-SDR,且对摄像头相对位置不敏感,表现出部署灵活性。
实验覆盖了正面、俯视、左/右30°、左/右60°等七种视角,并构造了混合视角序列(模拟头动)以评估鲁棒性。结果表明:
- MVTF在混合视角序列上的SI-SDR(15.834 dB)显著高于单视角随机训练(15.179 dB)和纯正面训练(10.425 dB);
- 隐式互补视角训练(训练时使用多个随机视角)比固定正面视角训练带来更稳定的泛化能力。
这项工作说明,多视角增强的关键并不只是简单地增加视角数量,而在于显式建模视角间的乘性交互,使模型学会提取跨视角共享的发音表示。论文也为音视频目标说话人提取提供了一种无需测试时多摄像头、即可应对真实世界中头动与视角变化的鲁棒前端方案。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2026 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2026 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。