INTERSPEECH 2026 论文预讲会由中国中文信息学会、CCF语音对话与听觉专委会、深圳市人工智能学会、语音之家发起,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2026 录用论文的作者进行报告交流。
INTERSPEECH 2026 论文预讲会第五期邀请到香港理工大学做本次会议的专场分享,欢迎大家观看。
第五期-香港理工大学【专场】
时间:7月13日(周一)19:00 ~ 21:00
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
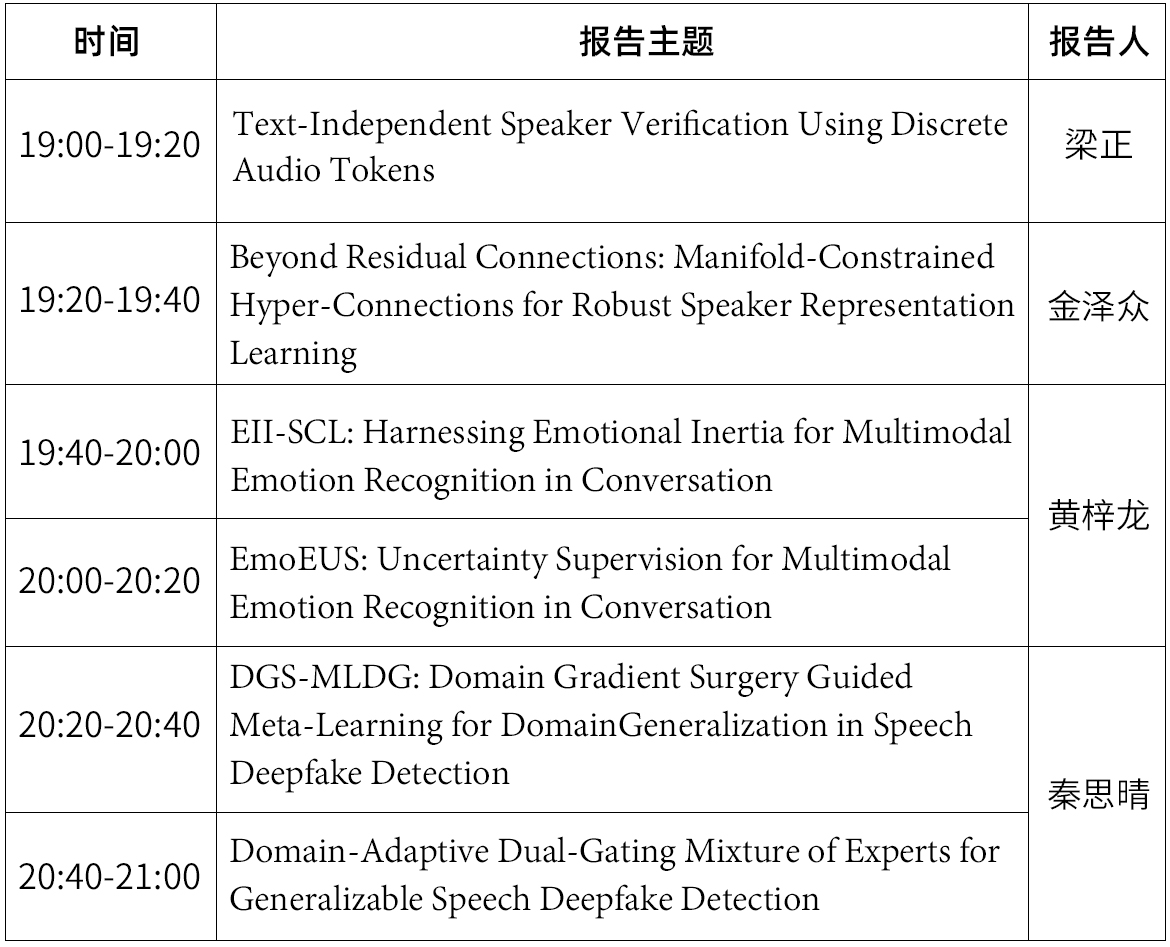
嘉宾&主题
嘉宾简介:梁正,硕士毕业于香港理工大学电子信息工程专业,师从于Kong-Aik Lee教授。现担任香港理工大学电机及电子工程学系的研究助理。关注的研究方向有神经音频压缩、声纹识别和深度伪造。
报告题目:Text-Independent Speaker Verification Using Discrete Audio Tokens
摘要:该研究针对神经音频编解码器离散 Token 在自动声纹验证(ASV)任务中性能不佳的问题,提出了一种跨特征知识蒸馏(CFKD)框架。该框架通过让基于 Token 的学生模型在嵌入层去模仿强有力的 Fbank 教师模型,成功释放并利用了 Token 中隐含的说话人特征;同时研究指出,由于离散 Token 空间缺乏传统频谱的维度连续性,因此对顺序不敏感的 1D 架构(如 ECAPA-TDNN)比 2D 架构更适合建模此类离散表征。在 VoxCeleb 数据集上的实验表明,该方法在最大码率下实现了 49.5% 的相对性能提升,显著缩小了离散音频 Token 与传统连续频谱特征之间的性能差距。
嘉宾简介:金泽众,香港理工大学电机及电子工程学系博士研究生,师从麦文伟教授(Prof. Man-Wai Mak)和 Kong Aik Lee 教授,中国计算机学会(CCF)会员。研究方向主要包括说话人识别、序列生成、知识蒸馏和自监督学习。曾先后在微软亚洲研究院多媒体计算组、腾讯及字节跳动开展研究实习,参与语音与人工智能相关研究。目前已以第一作者身份在 TASLP、EMNLP、ICASSP、INTERSPEECH 等国际高水平期刊和会议发表论文11篇。
报告题目:Beyond Residual Connections: Manifold-Constrained Hyper-Connections for Robust Speaker Representation Learning
摘要:残差连接(Residual Connection)是深度说话人识别模型(如 ECAPA-TDNN 和 ResNet)中的核心组成部分。然而,传统的残差连接采用简单的恒等映射(identity mapping),信息只能沿着单一路径传播,从而限制了特征表示能力。为了解决这一问题,我们提出了流形约束超连接(Manifold-Constrained Hyper-Connections,mHC)。该方法将传统的单一路径残差连接重新建模为一种多路径信息演化(multi-stream evolution)过程,使多个信息流能够通过一个双随机矩阵(doubly stochastic matrix)进行交互和融合。为了保证这种信息融合的稳定性,我们利用 Sinkhorn-Knopp 迭代算法对混合矩阵进行约束,使其始终保持双随机性质。这种约束能够实现能量守恒(energy conservation),即在信息传播过程中保持信号强度和特征均值不发生偏移,从而稳定梯度传播,并减轻深层网络中的信号衰减问题。我们将 mHC 替换了多种主流骨干网络中的标准残差连接,包括 ECAPA-TDNN、ResNet-34、Res2Net 和 E-Res2Net,并在 VoxCeleb1 数据集上进行了大量实验。实验结果表明,mHC 在所有网络结构上均能够稳定提升性能,验证了其在鲁棒说话人表示学习中的有效性。
嘉宾简介:黄梓龙,目前是香港理工大学电机及电子工程学系博士研究生,导师为Man-Wai Mak教授和Kong-Aik Lee教授。目前,他作为访问学者在京都大学语音与音频处理实验室开展研究。研究方向主要包括多模态情感计算、大语言模型以及对话中的情感识别。
报告题目一:EII-SCL: Harnessing Emotional Inertia for Multimodal Emotion Recognition in Conversation
摘要:对话中的情感表达通常遵循情感惯性(Emotional Inertia)规律,即同一说话人的情绪状态在局部时间范围内具有持续性,并呈现渐进而非突变的变化模式。本文提出EII-SCL框架,在监督对比学习中引入情感惯性约束,通过构建同一说话人在局部时间窗口内的hard negative样本,并结合动态时间窗口建模情绪变化过程,使模型能够学习更加具有判别性的情感表示。实验结果表明,该方法能够作为通用模块无缝集成到现有多模态情感识别模型中,并在IEMOCAP和MELD数据集上取得了领先性能。
报告题目二:EmoEUS: Uncertainty Supervision for Multimodal Emotion Recognition in Conversation
摘要:不同模态在对话中的可靠性并不一致,噪声、缺失信息以及模态间冲突都会影响情感识别效果。本文提出EmoEUS框架,通过显式不确定性监督学习,对文本、语音和视觉模态分别估计其不确定性,并利用不确定性感知的多模态融合策略动态调整各模态贡献。同时,引入基于分布表示和2-Wasserstein距离的显式监督损失,对不确定性进行直接约束,使模型能够更加准确地衡量各模态的可靠程度。实验结果表明,该方法有效提升了多模态融合的鲁棒性,并在多个基准数据集上取得了优于现有方法的性能。
嘉宾简介:秦思晴,香港理工大学电机及电子工程学系的一名博士研究生,导师是李功益教授,主要的研究方向有语音鉴伪,声纹识别,元学习等。硕士阶段就读于天津大学,在王龙标教授的指导下从事自动语音识别方向。
报告题目一:DGS-MLDG: Domain Gradient Surgery Guided Meta-Learning for Domain Generalization in Speech Deepfake Detection
摘要:语音深度伪造检测因领域迁移而面临重大挑战。领域泛化(Domain Generalization,DG),尤其是基于元学习的领域泛化(Meta-Learning for Domain Generalization,MLDG),通过模拟并缓解领域偏移,提供了有前景的解决方案。然而,MLDG 常受限于元训练(meta-train)目标与元测试(meta-test)目标之间的梯度冲突,导致性能不佳。为了解决该问题,我们提出了域梯度手术(Domain Gradient Surgery,DGS),这是一种通过非对称投影策略来消除冲突的元学习方法。DGS 从元测试梯度中移除具有破坏性的分量,确保与元训练梯度之间的无冲突优化轨迹。此外,我们引入了逐层 DGS(Layer-wise DGS,LW-DGS),作为 DGS 的高效变体,能动态识别并仅对易发生冲突的层进行干预。大量在具有挑战性的基准上的实验表明,DGS-MLDG 与 LW-DGS-MLDG 分别实现了平均相对等错误率(EER)降低 5.29% 与 4.04%。
报告题目二:Domain-Adaptive Dual-Gating Mixture of Experts for Generalizable Speech Deepfake Detection
摘要:近来,语音深度伪造检测(SDD)利用专家混合(Mixture of Experts,MoE)提升泛化能力。然而,现有的门控网络常忽视深度伪造的声学与时序线索。为此,本工作提出了一种用于应对未见攻击类型与声学条件的域自适应双门控MoE(Domain-Adaptive Dual-Gating MoE,DADG‑MoE)框架。我们创新性的双门控机制基于Sinc层滤波器,分别处理低层声学信号(原始波形)和来自大型自监督学习(SSL)模型的高层语音表示;并通过域原型引导专家路由,以捕捉隐含的深伪模式。输入经路由后由轻量级仿射专家处理。实验表明,DADG‑MoE 在具有挑战性的数据集外基准上相比基线可显著提升性能,最高实现相对等错误率(EER)降低40.8%,展示了优异的泛化能力与高效设计。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2026 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2026 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。