INTERSPEECH 2025 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2025 录用论文的作者进行报告交流。
INTERSPEECH 2025 论文预讲会邀请到华南理工大学电子信息学院在7月12日和7月13日分别做两期专场分享,本文介绍第二场相关内容,欢迎大家预约观看。
第四期
华南理工大学电子信息学院(二)【专场】
时间:7月13日(周日)19:00 ~ 21:05
形式:线上
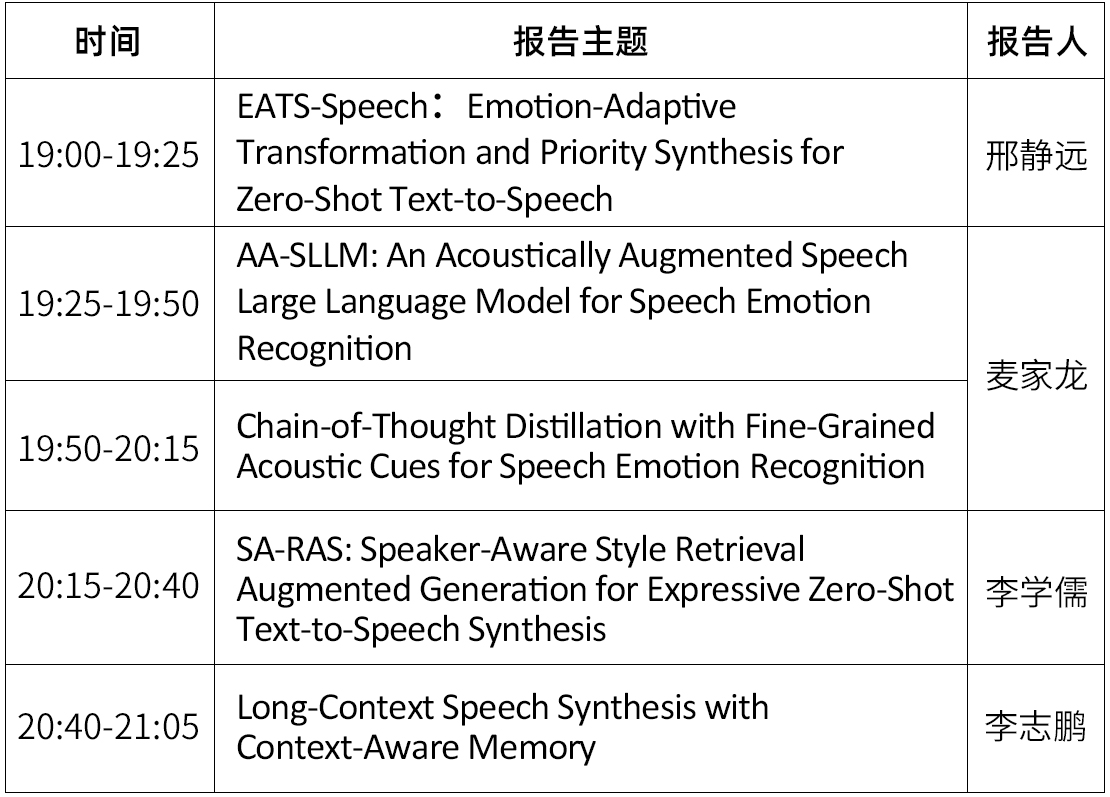
议程:每位嘉宾分享25分钟(含5分钟QA)
嘉宾&主题
嘉宾简介:邢静远,华南理工大学未来技术学院二年级硕士生,研究方向为语音合成,语音大模型,语音对话。
分享主题:EATS-Speech:Emotion-Adaptive Transformation and Priority Synthesis for Zero-Shot Text-to-Speech
摘要:本文提出了一种名为EATS-Speech(Emotion-Adaptive Transformation and Priority Synthesis for Zero-Shot Text-to-Speech)的新型零样本文本到语音(TTS)框架,旨在解决传统零样本TTS方法在情感转移方面的不足。传统方法通常将情感视为全局风格的一部分,导致情感表达不一致。EATS-Speech通过并行管道将语音分解为非情感风格、情感和内容三个部分,并优先生成情感部分以增强表达力。此外,EATS-Speech引入了一种基于大语言模型(LLM)的情感转换机制,从参考语音中学习文本-情感映射模式,并将其转移到目标文本上,以实现情感的自适应转移。实验结果表明,EATS-Speech在LibriTTS数据集上显著提高了情感表达能力和情感适应的准确性。主观评估和客观评估均验证了该框架在情感一致性和表达力方面的优越性。本文的贡献包括:提出情感优先合成框架,通过并行流分解语音;引入基于LLM的情感转换机制,确保合成语音的情感与目标文本一致;在LibriTTS数据集上的实验验证了EATS-Speech在情感表达和适应方面的有效性。
Demo链接:https://test1341.github.io/demo/
嘉宾简介:麦家龙,华南理工大学电子与信息学院硕士研究生。导师是邢晓芬教授。研究方向为多模态语音大模型、语音合成、情感识别。
分享主题 1:AA-SLLM: An Acoustically Augmented Speech Large Language Model for Speech Emotion Recognition
摘要1:AA-SLLM 近年来,语音大语言模型(SpeechLLMs)的快速发展极大地加速了语音情感识别(SER)领域的研究进展。然而,语音大语言模型依赖强大的语义编码器和与声学无关的预训练数据,对与语音情感密切相关的声学信息关注有限。 在本文中,我们利用与情感相关的声学特性自动生成声学描述,并将这些描述与语义表示相结合作为大语言模型的输入,以增强情感识别能力。据此,我们提出了AA-SLLM,这是一种通过低秩自适应(LoRA)进行指令微调的声学增强语音大语言模型。实验结果表明,AA-SLLM在改善整体性能的同时有效缓解了类别不平衡问题。此外,AA-SLLM在IEMOCAP、MELD和LSSED数据集上均取得了最先进的结果。
分享主题2 :Chain-of-Thought Distillation with Fine-Grained Acoustic Cues for Speech Emotion Recognition
摘要2:近年来,大型语言模型(LLMs)通过思维链(CoT)提示展现出强大的推理能力,但其在语音情感识别(SER)中的应用仍有待探索。此外,当前SER模型缺乏基于情感相关声学特征的可解释性。为此,我们提出AECoTD方法,该方法通过利用细粒度情感声学特征和文本转录,将大型LLM的推理能力迁移至特定领域的SER-LLM。该方法使用LoRA(低秩自适应)蒸馏推理链,并通过情感聚焦损失保留正确的情感注意力,从而增强模型的可解释性。消融实验凸显了细粒度声学信息、情感CoT推理和情感聚焦损失的影响。在不使用预训练表征的情况下,我们的方法在域内和域外均实现了最先进的性能,展现出强大的泛化能力。
嘉宾简介:李学儒,华南理工大学电子与信息学院的本科生,导师是邢晓芬老师,主要研究方向是语音合成。
分享主题:SA-RAS: Speaker-Aware Style Retrieval Augmented Generation for Expressive Zero-Shot Text-to-Speech Synthesis
摘要:零样本语音合成(TTS)模型可通过参考语音克隆未见说话人。在给定多段参考语音的情况下,检索增强生成(RAG)技术在提升合成质量方面展现出潜力。现有方法面临两个关键局限:基于语义的检索容易引入风格偏差,且文本与语音之间的确定性映射无法充分捕捉说话人的独特风格。针对这些问题,我们提出了说话人感知检索增强语音合成模型(SA-RAS)。该模型由两阶段TTS模型Split-TTS和零样本CLAP组成:前者将风格特征与音色特征分离嵌入,以获取用于检索的风格空间;后者通过将说话人信息融入检索模型,优化文本与风格之间的相关性。实验证明,SA-RAS增强了合成语音的风格表现力。
嘉宾简介:李志鹏,华南理工大学电子与信息学院三年级硕士生,研究方向为语音合成。
分享主题:Long-Context Speech Synthesis with Context-Aware Memory
摘要:在长文本语音合成任务中,现有方法通常以句子为单位将文本转换为语音,并通过拼接生成伪段落级语音。这类方法忽略了段落内的上下文连贯性,导致长段落语音的自然度下降,且容易出现前后风格和音色不一致等问题。为了解决上述问题,我们提出了一种基于上下文感知记忆的长文本语音合成模型。该模型通过上下文感知记忆模块,结合长期记忆与局部上下文细节,实现段落内动态记忆的检索、集成与更新,有效指导句子级语音的生成。此外,前缀掩码机制通过对前缀符元启用双向注意力,进一步增强了模型的上下文信息建模能力。实验结果表明,所提出的方法在段落级语音的韵律表现力、连贯性以及上下文推理效率等方面,优于基线模型和现有主流的长文本语音合成方法。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2025 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式来选择预讲会的嘉宾。

为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2025 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
预讲会报名方式
联系人邮箱:bd@speechhome.com
联系人微信