INTERSPEECH 2025 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2025 录用论文的作者进行报告交流。
INTERSPEECH 2025 论文预讲会邀请到华南理工大学电子信息学院在7月12日和7月13日分别做两期专场分享,本文介绍第一场相关内容,欢迎大家预约观看。
第三期
华南理工大学电子信息学院(一)【专场】
时间:7月12日(周六)19:00 ~ 20:40
形式:线上
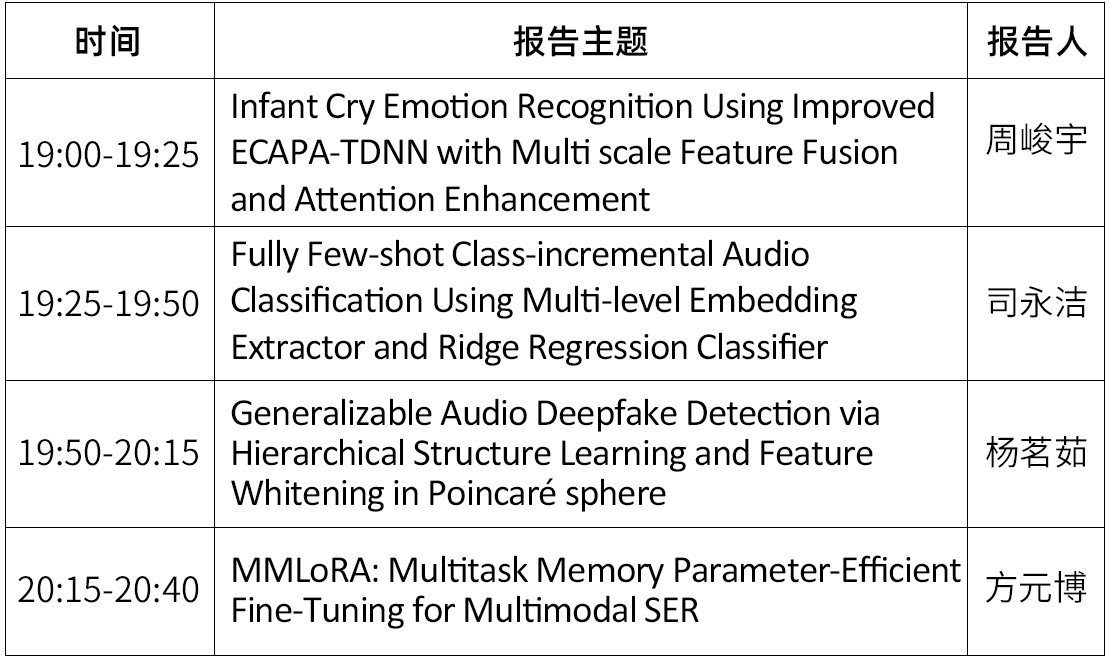
议程:每位嘉宾分享25分钟(含5分钟QA)
嘉宾&主题
嘉宾简介:周峻宇,华南理工大学数学学院2022级本科生,专注于数学与计算科学领域的学习与研究。导师是李艳雄老师,主要研究方向为情感语音识别,致力于通过数学建模、深度学习算法以及信号处理技术等手段,探索语音情感信息的提取与分析方法。
分享主题:Infant Cry Emotion Recognition Using Improved ECAPA-TDNN with Multi scale Feature Fusion and Attention Enhancement
摘要:提出了一种改进的ECAPA-TDNN模型,用于婴儿哭声情绪识别。婴儿哭声情绪识别对于育儿和医疗应用至关重要,但面临着情绪变化细微、噪声干扰以及数据有限等挑战。改进的ECAPA-TDNN通过引入多尺度特征融合和注意力增强机制,有效解决了传统方法的不足。该模型在公共数据集上达到了82.20%的准确率,模型参数量为1.43MB,计算复杂度(FLOPs)为0.32Giga,相较于基线方法具有更高的准确率。具体而言,改进的ECAPA-TDNN框架中加入了残差SE模块(RSE)、多尺度通道注意力模块(MCA)和差分注意力模块,分别用于增强时频域交互、捕获多尺度特征以及优化通道权重分配。通过多尺度特征提取和通道注意力机制的结合,模型能够更好地捕捉婴儿哭声中的情绪信息。实验通过消融实验验证了各模块的有效性,并与其他先进模型(如ECAPA-TDNN和ResNet18)进行了对比,结果表明改进的ECAPA-TDNN在准确率上具有明显优势。未来工作将探索结合空间-频谱关系的混合注意力架构,并优化模型复杂度以适应边缘设备部署。
论文链接:https://arxiv.org/abs/2506.18402
代码链接:https://github.com/kkpretend/IETMA
嘉宾简介:司永洁,华南理工大学电子与信息学院2022级博士生,研究方向为音频信号处理和机器学习。
分享主题 :Fully Few-shot Class-incremental Audio Classification Using Multi-level Embedding Extractor and Ridge Regression Classifier
摘要:在小样本类增量音频分类(Few-shot Class-incremental Audio Classification, FCAC)任务中,每个基类的训练样本都需要足够丰富才能有效训练模型。然而,由于数据稀缺和高收集成本,为许多基类收集大量训练样本并不容易。在这项工作中,论文讨论了一个更现实的问题,即完全小样本类增量音频分类(Fully Few-shot Class-incremental Audio Classification, FFCAC),其中基础类和增量类的训练样本都只有少量。此外,论文提出了一种FFCAC方法,该方法使用一个解耦为多级表征提取器和岭回归分类器的模型。表征提取器由音频频谱变换器的编码器和融合模块组成,在基础会话中训练,但在所有增量会话中冻结。分类器在每个增量会话中不断更新。三个公共数据集(LS-100、NSynth-100和FSC-89)的结果表明,论文方法在准确性上超过了以往的方法,在复杂性上也优于大多数方法。
论文链接:https://arxiv.org/abs/2406.08122
代码链接:https://github.com/YongjieSi/MAR
嘉宾简介:杨茗茹,华南理工大学电子与信息学院2023级硕士生,研究方向为音频信号处理和机器学习。
分享主题:Generalizable Audio Deepfake Detection via Hierarchical Structure Learning and Feature Whitening in Poincaré sphere
摘要:音频深度伪造检测(Audio Deepfake Detection,ADD)在应对多样化的现实伪造攻击和领域差异时面临严峻的域泛化挑战。然而,现有方法主要依赖欧几里得距离在欧氏空间中进行真假语音的二分类,难以充分捕捉利用数据中与攻击类别和领域因素相关的内在层次结构。为了解决这个问题,论文设计了一个新颖的框架——Poin-HierNet,用于在庞加莱球面中构建领域不变的层次化特征表示空间。Poin-HierNet 包含三个关键学习过程:庞加莱原型学习、层次结构学习和庞加莱特征白化。庞加莱原型学习通过多个数据原型对齐样本特征,捕捉真假标签之外的多级层次结构;层次结构学习根据顶级原型与数据原型之间的关系,构建树状层级结构;庞加莱特征白化通过特征白化抑制对领域敏感特征的学习,从而增强领域不变性。在四个主流的开源数据集上评估了论文方法,实验结果表明Poin-HierNet优于当前最先进的方法。
嘉宾简介:方元博,华南理工大学电子与信息学院博士研究生。他的研究兴趣包括语音情感识别,语音大模型。
分享主题:MMLoRA: Multitask Memory Parameter-Efficient Fine-Tuning for Multimodal SER
摘要:情感表达的个体差异给有效情感识别系统的开发带来了显著挑战。尽管大型语言模型(LLMs)已展现出强大的性能,但其在情感识别任务中的泛化能力常受限于个体情感表达的差异,这一问题即使通过LoRA等参数高效微调技术也未能得到充分解决。为应对这些挑战,我们提出了一种多任务记忆参数高效微调方法(MMLoRA),通过引入性别作为辅助任务来增强多模态语音情感识别(SER)。该方法利用共享的LoRA专家促进任务间的信息交换,并采用LoRA专家混合机制处理任务特定信息。同时,引入的任务记忆机制将任务特定信息进行跨层传递。实验结果表明,与原始LoRA方法相比,所提出的MMLoRA显著提升了情感识别的性能。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2025 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式来选择预讲会的嘉宾。

为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2025 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
预讲会报名方式
联系人邮箱:bd@speechhome.com
联系人微信