INTERSPEECH 2025 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 INTERSPEECH 2025 录用论文的作者进行报告交流。
INTERSPEECH 2025 论文预讲会第二期邀请到国防科技大学并行与分布计算全国重点实验室的徐齐胜和宁波大学人工智能模型与数据安全课题组的黄煜珩做本次会议的专场分享,欢迎大家观看。
第二期 — 个人联合专场
时间:7月1日(周二)19:30 ~ 20:30
形式:线上
议程:每位嘉宾分享30分钟(含5分钟QA)
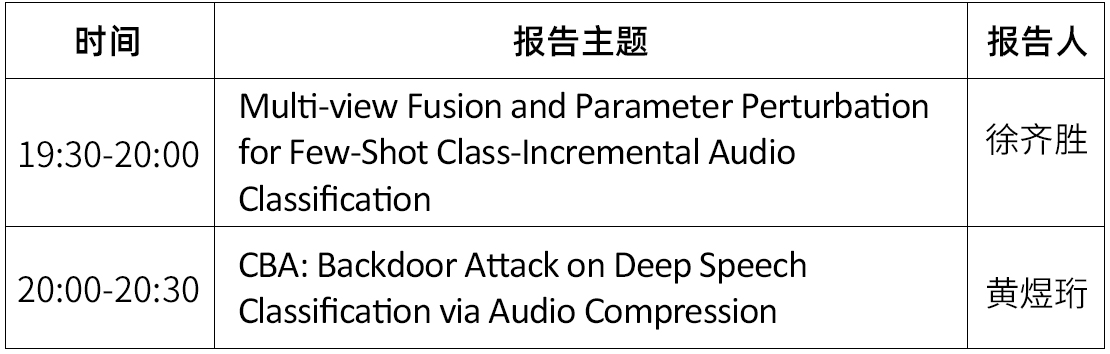
嘉宾&主题
嘉宾简介:徐齐胜,国防科技大学二年级博士生,导师为许可乐副研究员、窦勇研究员,主要研究方向为音频表征学习、音频信号分类、音频分类持续学习算法
分享主题:Multi-view Fusion and Parameter Perturbation for Few-Shot Class-Incremental Audio Classification
摘要:音频分类任务通常建立在固定类别数量的假设之上,然而该假设在实际应用场景中常难以成立,因为目标类别集合往往是开放动态的或先验未知的。当模型需要持续适应新增类别时,一个核心挑战随之凸显——“灾难性遗忘”现象,即模型对已学习类别的识别性能显著退化,该挑战在新类别数据有限的情况下尤为显著。尽管已有研究提出了诸如基于动态网络和基于原型精炼的方法以应对上述挑战,但这些方法仍存在两个关键局限:(1) 原始音频样本的表征能力有限,制约了模型的泛化性能;(2) 过拟合风险,限制了模型的适应能力。针对这些问题,本文提出了一种新的增量学习框架——多视图融合与参数扰动 (Multi-View Fusion and Parameter Perturbation, MVF2P)。该框架借鉴互补学习系统思想,在一个统一的增量学习范式中,协同提升模型的泛化性与适应性。具体而言,MVF2P 通过集成多视图学习策略以增强特征表征能力,并引入参数扰动机制以缓解过拟合风险,从而有效克服了现有方法的不足。
嘉宾简介:黄煜珩于2023年开始在宁波大学攻读硕士学位,导师为严迪群副教授。他的研究主要集中在多媒体与信息安全,特别关注针对深度神经网络的后门攻击及防御策略。
分享主题 :CBA: Backdoor Attack on Deep Speech Classification via Audio Compression
摘要:随着深度神经网络在诸多社会领域的广泛应用,其易受后门攻击威胁的特性已受到广泛关注,攻击者可通过植入定制化触发器来操控模型行为。然而,现有的大多数音频后门攻击方法普遍存在两个局限:一是依赖单一静态触发器易被检测,二是往往会在样本中引入人类可感知的扰动。针对上述问题,本文提出了一种面向音频压缩场景的新型后门攻击策略——基于音频压缩的后门攻击(Compression-based Backdoor Attack, CBA)。该方法创新性地结合特征融合机制与迭代优化策略,生成具有样本自适应性的动态触发器,从而在维持高攻击成功率的同时,显著提升了触发器的隐蔽性与鲁棒性。广泛实验验证表明,CBA在攻击效能和抗检测能力等方面展现出优越的性能。
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
INTERSPEECH 2025 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式来选择预讲会的嘉宾。

为了共创高质量的论文预讲会,我们诚挚邀请所有 INTERSPEECH 2025 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
预讲会报名方式
联系人邮箱:bd@speechhome.com
联系人微信