ICASSP 2025 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2025 录用论文的作者进行报告交流。
ICASSP 2025 论文预讲会第十二期邀请到上海交通大学听觉认知与计算声学实验室做本次会议的专场分享,欢迎大家观看。
实验室概况
上海交通大学听觉认知与计算声学实验室(SJTU Auditory Cognition and Computational Acoustics Lab, AudioCC Lab),由计算机系钱彦旻教授领导,集结了一支由青年教师、博士生、硕士生、本科生以及专职科研等组成的近四十人研究团队。该实验室专注于完整的听觉人工智能与计算声学领域相关技术的研究,力求用计算和智能的方法重点解决语音,音频,音乐,自然声信号等听觉相关技术挑战并构建高效系统。涵盖智能语音处理、音乐与音频生成、自然语言理解和多媒体信号分析等方向。实验室的研究工作得到了国家脑科学计划、国家重点研发计划、国家自然科学基金等国家级和来自腾讯,蚂蚁,美团,荣耀等企业级项目的资助。实验室可调动丰富的数据资源以及多达百块最先进GPU卡的丰富计算资源,包括A100,H800,4090,A10等,可以做产业级和大规模的人工智能技术研究。近5年,在国际期刊和会议上发表了数百项学术成果。实验室业余活动丰富,成员全面发展,毕业生均前往国内外顶级企业和研究机构就业或深造。
第十二期:上海交通大学听觉认知与计算声学实验室【专场】
时间:3月26日(周三)19:00 ~ 21:00
形式:线上
议程:每位嘉宾分享20分钟(含5分钟QA)
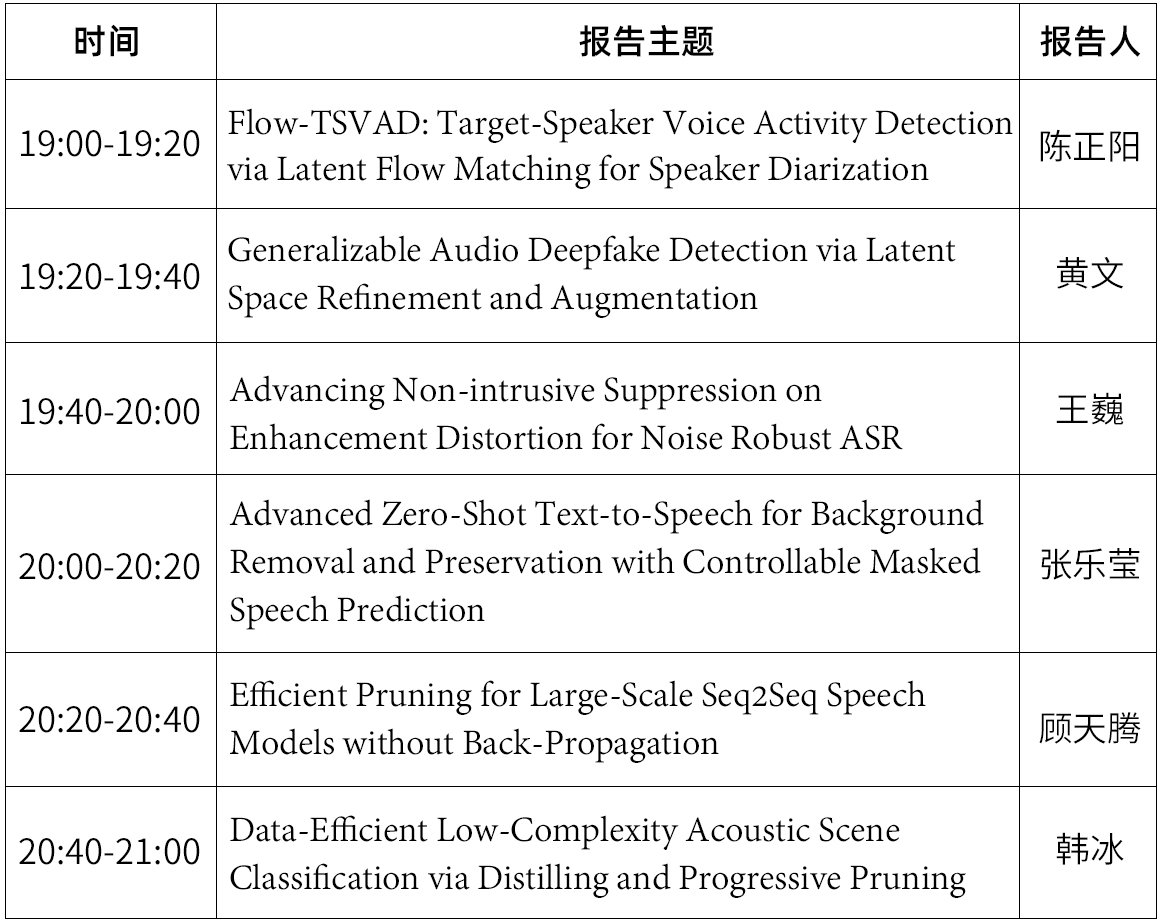
嘉宾&主题
嘉宾简介:陈正阳,上海交通大学听觉认知与计算声学实验室博士毕业生,主要研究方向包括语音中的说话人建模,大规模语音预训练和语音生成。他在语音相关的顶级期刊和会议上以一作身份已经发表论文十余篇,谷歌论文总引用量2500+。他同时还是说话人识别开源项目Wespeaker的主要贡献者和维护者。目前已入职字节跳动。
分享主题:Flow-TSVAD: Target-Speaker Voice Activity Detection via Latent Flow Matching for Speaker Diarization
摘要:基于深度神经网络的说话人日志系统可以根据语音的输入直接输出每一个人的说话区域。在之前的系统中,这些基于神经网络的方法往往使用的是判别式算法,也就是对于同样的输入,会有同样的输出。然而说话人日志的标签往往是有一定误差的,是不准确的。这种标签的不准确性可能会对判别式算法的优化带来负面的影响。在这篇工作中,我们尝试把生成式算法用到基于目标说话人活动检测的说话人日志系统,来建模标签的这种不准确性,也就是标签的分布。同时,我们发现将生成式流匹配算法直接用到二值离散标签空间效果并不好,为此我们提出了将二值标签序列压缩到连续隐空间再进行生成式方法建模的策略,并相对于基线判别式系统有了进一步提升。
嘉宾简介:黄文,上海交通大学听觉认知与计算声学实验室二年级硕士生,主要研究方向包括语音伪造检测、说话人验证、声学场景事件检测等。在ICASSP、Interspeech等会议发表多篇论文,曾获 ISCSLP 2024最佳学生论文。
分享主题:Generalizable Audio Deepfake Detection via Latent Space Refinement and Augmentation
摘要:近年来,文本转语音(TTS)和语音转换(VC)等语音合成技术的进步,使得深度伪造语音的检测变得越来越具有挑战性。现有的防伪技术在面对未知攻击时往往难以有效泛化。为了解决这一问题,我们提出了一种新策略,将潜在空间优化(LSR)和潜在空间增强(LSA)结合,以提升深度伪造检测系统的泛化能力。LSR 通过为伪造类别引入多个可学习的原型,优化潜在空间,从而更精细地刻画伪造数据的复杂变化。LSA 直接在潜在空间中应用数据增强技术,使模型能够学习更广泛的伪造模式,从而进一步丰富伪造数据的表示。我们在四个代表性数据集(ASVspoof 2019 LA、ASVspoof 2021 LA、ASVspoof 2021 DF 和 In-The-Wild)上对所提出的方法进行了评估。实验结果表明,LSR 和 LSA 各自均能显著提升检测性能,而它们的结合可以达到甚至超越当前最先进方法的性能。
论文链接:https://ieeexplore.ieee.org/document/10888328
嘉宾简介:王巍,上海交通大学听觉认知与计算声学实验室四年级博士生,主要研究方向为抗噪语音识别,领域自适应语音识别、语音增强。曾获得SLT CSRC童声识别挑战赛第一名, MISP多模态识别挑战赛第三名,两届URGENT增强挑战赛的主办方成员。在领域主要期刊和会议上(ICASSP,InterSpeech, TASLP)发表论文十余篇。
分享主题:Advancing Non-intrusive Suppression on Enhancement Distortion for Noise Robust ASR
摘要:近年来,语音增强(SE)技术在提升语音清晰度和可懂度方面取得了显著进展,使其在复杂声学环境下的应用更加广泛。然而,将 SE 集成到自动语音识别(ASR)系统中往往会引入增强过程中产生的失真,从而导致识别性能下降。尽管已有多种方法提升 SE-ASR 系统的识别准确率,但通常需要对 SE 或 ASR 模型进行微调或重新训练,这在许多实际应用中并不现实。本文提出了一种轻量级的失真抑制(DS)网络,在不修改 SE 或 ASR 模型的情况下有效缓解增强失真,并将 SE 和 ASR 视作不可变的黑盒。该 DS 模块作用于原始和增强复频谱的时频(T-F)频带,通过原始 T-F 信息高效补偿 SE 失真。我们在中文和英语 ASR 任务上验证了该方法,涵盖单通道和多通道 SE 前端,并适用于多种 ASR 后端。实验结果表明,即使在商用 ASR 后端中,DS 模块仍能显著提升 SE-ASR 系统的性能。
嘉宾简介:张乐莹,上海交通大学听觉认知与计算声学实验室二年级博士生,本科、硕士毕业于上海交通大学,研究工作聚焦于语音合成、多模态处理。她在NeurIPS, ICASSP, INTERSPEECH等领域顶级会议上发表论文十余篇,曾获国家奖学金、上海市优秀毕业生等。
分享主题:Advanced Zero-Shot Text-to-Speech for Background Removal and Preservation with Controllable Masked Speech Prediction
摘要:在人类的自然对话中,背景声音起着至关重要的作用。它提供了语境,帮助听众理解说话人所处的环境和情形。然而,过于强烈的背景声则会干扰听众对语音的理解。如何处理这些背景声音取决于具体情境:有时,我们需要去除背景以确保获取清晰的语音,但有时,我们希望保留背景声音从而帮助听众理解所处的环境。尽管零样本文本到语音和语音克隆技术近年来取得了进展,但现有的系统在处理包含背景的语音提示时仍常常面临挑战。为解决这些难题,我们提出了一种可控掩蔽语音预测策略,并双说话人编码器,利用与任务相关的控制信号来同时指导和实现去除背景声和保留背景声的任务。实验结果表明,我们的方法能够在各种声学条件下精确控制背景的去除或保留,并在未见场景中展现出强大的泛化能力。
论文链接:https://ieeexplore.ieee.org/abstract/document/10887658
Demo链接:https://vivian556123.github.io/TTS-for-BR-and-BP/
嘉宾简介:顾天腾,上海交通大学听觉认知与计算声学实验室一年级硕士生,方向为模型压缩和推理加速。
分享主题:Efficient Pruning for Large-Scale Seq2Seq Speech Models without Back-Propagation
摘要:大规模序列到序列语音模型(如Whisper)在语音识别领域表现出色,但其高计算需求限制了在资源受限设备上的部署。本文提出了一种新颖高效的剪枝方法,可在无需重新训练和反向传播的前提下压缩此类模型,特别针对具有编码器-解码器架构的模型。我们将分层剪枝技术扩展至大型语音模型,并引入一种仅利用前向传播的混合稀疏度分配策略。该方法在有效缩小模型规模的同时保持了高性能。通过在Whisper-Large-v3模型上的多数据集评测表明,我们的方法能以约60%的参数减少量基本保持Whisper的性能和鲁棒性。该方法还可与蒸馏等其他模型压缩技术结合,进一步缩小模型规模。
论文链接:https://ieeexplore.ieee.org/abstract/document/10890791
嘉宾简介:韩冰,上海交通大学听觉认知与计算声学实验室三年级博士生,主要研究方向包括说话人识别、音频分析与合成等。他在TASLP、IJCAI、ICASSP、INTERSPEECH等领域主要期刊会议上发表论文十余篇。
分享主题:Data-Efficient Low-Complexity Acoustic Scene Classification via Distilling and Progressive Pruning
摘要:声学场景分类(Acoustic Scene Classification, ASC)是一项重要的音频识别任务,旨在根据环境声音对其所属的场景进行分类。然而,ASC 任务在实际应用中面临设备不匹配、计算资源受限以及训练数据有限等挑战。为此,本文提出了一种数据高效、低复杂度的 ASC 方法,结合轻量级卷积网络 Rep-Mobile、知识蒸馏(Knowledge Distillation, KD)以及渐进式剪枝(Progressive Pruning)来提高模型的分类性能和推理效率。Rep-Mobile 通过多分支可重参数化(multi-branch reparameterization)机制提升特征提取能力,同时保持推理阶段的高效性。为了增强数据有限条件下的泛化能力,我们引入多教师模型蒸馏策略,结合 CNN 和 Transformer 模型进行知识迁移。此外,渐进式剪枝方法通过逐步减少冗余参数,实现模型压缩的同时保持精度。在 TAU Urban Acoustic Scene 2022 Mobile 数据集上的实验结果表明,我们的方法在准确率和计算效率上均优于主流模型,并在 DCASE2024 竞赛中获得第一名,验证了所提方法的有效性。
论文链接:https://ieeexplore.ieee.org/abstract/document/10890296
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
ICASSP 2025 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2025 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
预讲会报名方式
联系人邮箱:bd@speechhome.com
联系人微信