ICASSP 2025 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2025 录用论文的作者进行报告交流。
ICASSP 2025 论文预讲会第十一期邀请到上海交通大学跨媒体语言智能实验室做本次会议的专场分享,欢迎大家观看。
实验室概况
上海交通大学跨媒体语言智能实验室(SJTU Cross Media Language Intelligence Lab, X-LANCE)成立于2012年,前身是“智能语音实验室”(SpeechLab),经过多年发展,成为了涵盖视听文语言信息处理各核心研究领域的“跨媒体语言智能实验室”。目前,跨媒体语言智能实验室的教师组有一位教授、四位副教授和一位科研助理,获得国家级重大人才工程、重大青年人才、国家自然科学基金委优青等多项国家级人才项目,拥有二十余名博士研究生,近四十名硕士研究生,还包括ACM班、AI班、IEEE班、电院CS等专业、巴黎卓越工程师学院、密西根学院等的三十余名本科生。
第十一期:上海交通大学跨媒体语言智能实验室【专场】
时间:3月25日(周二)19:00 ~ 20:40
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
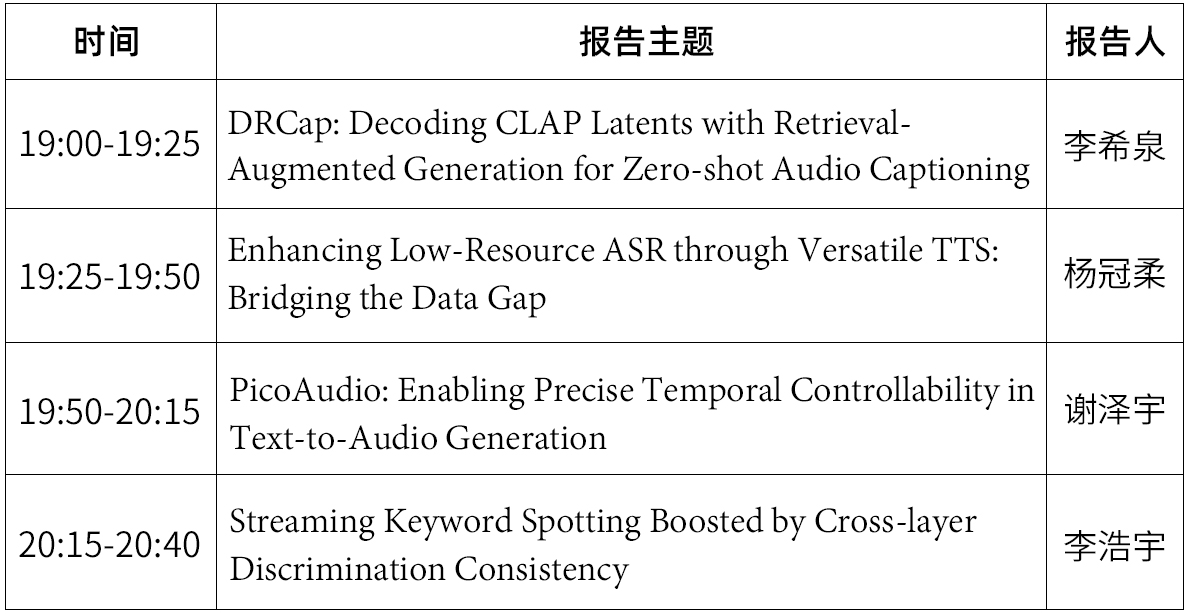
嘉宾&主题
嘉宾简介:李希泉,上海交通大学一年级硕士生,导师为陈谐副教授,主要研究方向为音频字幕生成,音频理解大语言模型,端到端对话系统。
分享主题:DRCap: Decoding CLAP Latents with Retrieval-Augmented Generation for Zero-shot Audio Captioning
摘要:尽管自动音频字幕生成(AAC)取得了显著进展,传统的完全监督式AAC模型仍然面临两个关键挑战:训练时需要昂贵的音频-文本配对数据,以及在跨领域迁移时性能下降。为了解决这些问题,我们提出了DRCap,这是一种数据高效且灵活的零样本音频字幕生成系统,只需要文本数据进行训练,并且能够在无需额外微调的情况下快速适应新领域。DRCap以对比语言-音频预训练(CLAP)模型和大型语言模型(LLM)为核心。在训练过程中,模型使用CLAP中的固定文本编码器来预测真实字幕;而在推理过程中,文本编码器被音频编码器取代,用于对音频片段生成字幕,从而实现零样本生成。为了解决CLAP模型的模态差距问题,我们从编码器端使用投影策略,从解码器端使用检索增强生成策略。具体来说,音频嵌入首先被投影到文本嵌入支持上,以吸收CLAP联合多模态空间内的广泛语义信息。同时,从数据存储库中检索出的相似字幕作为提示,输入到LLM中,结合外部知识,充分发挥其强大的生成能力。在投影后的CLAP嵌入和检索到的相似字幕的共同作用下,模型能够生成更加准确且语义丰富的文本描述。通过根据目标领域定制文本嵌入支持和字幕数据存储库,DRCap获得了无需训练即可适应新领域的强大能力。实验结果表明,DRCap在域内场景中优于所有其他零样本模型,并在跨领域场景中达到了最新的性能水平。
论文链接:https://arxiv.org/abs/2410.09472
代码链接:https://github.com/X-LANCE/SLAM-LLM/tree/main/examples/drcap_zeroshot_aac
嘉宾简介:杨冠柔,上海交通大学二年级硕士生,导师为陈谐副教授,主要研究方向为语音合成和语音识别。
分享主题:Enhancing Low-Resource ASR through Versatile TTS:Bridging the Data Gap
摘要:虽然自动语音识别(ASR)系统在大规模数据集上性能显著,但在低资源设定下,其性能仍然不足。这些领域包括方言、口音、小语种和长尾热词等,它们具有重要的实际意义。最近多功能且强大的语音合成(TTS)模型不断出现,它们能够生成具有接近人自然度、表现力和多样化说话人特征的语音,利用TTS进行ASR数据增强为提升ASR系统提供了一种低成本且实用的方法。在丰富的低资源数据集上进行的全面的实验表现出了一致且显著的ASR性能提升,证明了通过强大TTS模型进行数据增强的方法是非常有效的,并具有广泛的应用前景。此外,我们进一步探讨了合成语音数据中有助于ASR性能提升的关键特征,分析了文本多样性、说话人多样性和合成数据量等因素,其中文本多样性在本研究中被首次探索。我们希望我们的研究结果能为基于TTS的数据增强的实际应用提供有益的指导和参考,并进一步推动低资源ASR的发展。
论文链接:https://arxiv.org/abs/2410.16726
嘉宾简介:谢泽宇,上海交通大学X-LANCE实验室三年级硕士生,导师为吴梦玥副教授。研究方向为一般音频处理,包括自动音频摘要生成、音频生成等任务。
分享主题:PicoAudio: Enabling Precise Temporal Controllability in Text-to-Audio Generation
摘要:近期,音频生成任务引起了相当多的研究兴趣。尽管在生成与文本描述大致对齐的高保真音频方面取得了快速进展,但在精确的时间可控性方面仍面临挑战,而这一点对于将音频生成与实际应用相结合至关重要。在本研究中,我们提出了一个时间可控的音频生成框架——PicoAudio。它通过数据爬取、分割和筛选来仿真细粒度的时间对齐音频-文本数据。此外,PicoAudio通过定制的模型设计整合时间信息以引导音频生成。凭借大型语言模型的有效文本处理能力,PicoAudio能够接受自然语言输入并生成与输入中的时间描述高度对齐的音频。主观和客观评估均表明,PicoAudio在时间戳和出现频率可控性方面显著优于当前最先进的生成模型。生成样本可在Demo网页中查看。
论文链接:https://arxiv.org/abs/2407.02869v2
Demo链接:https://zeyuxie29.github.io/PicoAudio.github.io/
嘉宾简介:李浩宇,上海交通大学二年级硕士生,导师为俞凯教授,主要研究方向为关键词检测和语音增强。
分享主题:Streaming Keyword Spotting Boosted by Cross-layer Discrimination Consistency
摘要:连接主义时间分类(CTC)是一种非自回归训练标准,广泛应用于在线的关键词检测任务(KWS)。然而,现有的基于 CTC 的 KWS 解码策略或依赖于自动语音识别(ASR),但是这类方法在声学空间中的广泛搜索而表现不佳,缺乏关键词特定的优化;或依赖于 KWS 特定的解码图,但是这些解码图的实现和维护相对复杂。本文提出了一种通过跨层辨别一致性(CDC)增强的流式解码算法,专为基于 CTC 的 KWS 设计。具体来说,我们引入了一种简化而有效的解码算法,能够在任意位置检测关键词的开始。此外,我们利用跨层的辨别一致性信息,更好地区分正样本与误报样本。我们在干净和嘈杂的 Hey Snips 数据集上的实验表明,我们所提出的流式解码策略优于基于 ASR 和解码图的 KWS 基线。在CDC 增强的下,流式解码策略的性能被进一步提高,与基于解码图的基线相比,在每小时0.05次误唤醒下,平均绝对召回率提升 6.8%,漏报率相对减少 46.3%。
论文链接:https://ieeexplore.ieee.org/document/10890010
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
ICASSP 2025 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2025 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
预讲会报名方式
联系人邮箱:bd@speechhome.com
联系人微信