ICASSP 2025 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2025 录用论文的作者进行报告交流。
ICASSP 2025 论文预讲会第十期邀请到新加坡富迪科技做本次会议的专场分享,欢迎大家观看。
企业概况
Fortemedia(富迪科技)是一家专注于音频处理和语音增强技术的高科技公司,总部位于美国加利福尼亚州,并在中国台湾、中国大陆、新加坡等地设有研发和业务中心。公司以AI 驱动的语音处理技术和先进的音频算法著称,核心技术涵盖远场语音增强(FFV)、语音分离、回声消除、降噪等领域,广泛应用于智能语音助手、智能家居、车载语音交互系统、耳机、智能手机等产品。Fortemedia 研发的SAM(Small Array Microphone)和 FFV(Fortemedia Far-Field Voice)技术,能在复杂环境中显著提升语音识别的准确性。公司长期与苹果、三星、华为、联想、小米等知名企业合作,为其提供高品质的音频解决方案。作为语音信号处理行业的重要参与者,Fortemedia 通过软硬件结合的创新方案,推动智能语音技术在边缘计算设备中的优化,使设备在低功耗环境下依然能实现高效语音处理,广泛应用于智能设备、汽车电子和远程会议系统等领域。
第十期:新加坡富迪科技【专场】
时间:3月20日(周四)19:00 ~ 20:30
形式:线上
嘉宾&主题
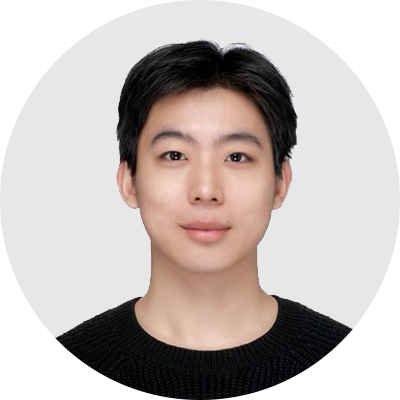
嘉宾简介:尹涵,西北工业大学航海学院-联丰迅声环境声音感知联合实验室三年级硕士生,研究方向为声音事件检测、音频分离及增强、伪造音频检测。曾在新加坡Fortemedia公司和阿里巴巴语音实验室进行研究实习。多次参加DCASE、ICASSP信号处理挑战赛等国际竞赛并获得前三甲。在声学学报,Signal Processing,ICASSP等期刊和会议上发表多篇论文。
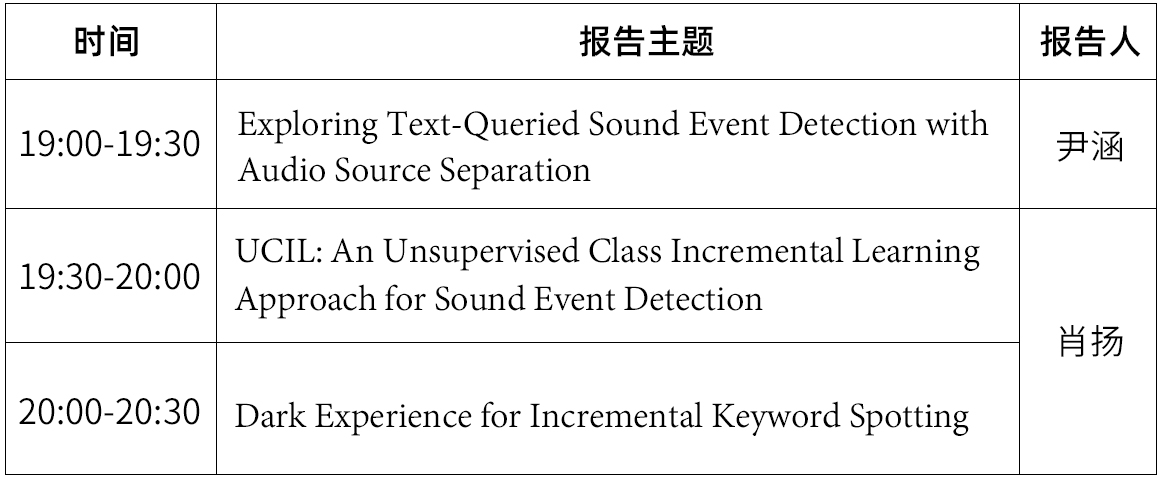
分享主题:Exploring Text-Queried Sound Event Detection with Audio Source Separation
摘要:在声音事件检测(SED)中,重叠的声音事件是主要挑战,某些事件可能被背景噪声或其他事件掩盖,导致检测性能下降。为此,我们提出文本查询SED(TQ-SED)框架。具体而言,我们首先预训练语言查询音源分离(LASS)模型,以分离输入音频中不同事件的音轨。然后,利用多个目标SED分支检测各个事件。AudioSep是当前最先进的LASS模型,但由于其纯卷积结构,难以提取动态音频信息。为了解决这一问题,我们在模型中引入双路径循环神经网络(DPRNN)模块,构建了AudioSep-DP。该模型在DCASE 2024任务9(语言查询音源分离)单模型赛道中获得第一名。实验结果表明,TQ-SED相比传统的SED框架,F1分数提升7.22%,显著提高了检测性能。此外,我们探讨了模型复杂度的影响。
论文链接:https://ieeexplore.ieee.org/document/10889789
代码链接:https://github.com/apple-yinhan/TQ-SED
嘉宾简介:肖扬,新加坡富迪科技AI工程师,研究方向为声音事件检测,唤醒词检测,伪造音频检测等。新加坡南洋理工大学人工智能硕士毕业,指导老师是Prof. Eng Siong Chng. 在IEEE Signal Processing Letters, ICASSP 和INTERSPEECH等期刊和会议上发表论文超过10篇。
分享主题1 :UCIL: An Unsupervised Class Incremental Learning Approach for Sound Event Detection
摘要1:本研究探讨了用于声音事件检测(SED)的类别增量学习(CIL),以提升其在真实场景中的适应性。CIL 在计算机视觉领域的成功启发了我们针对 SED 设计的方法,以应对多样且复杂的音频环境所带来的独特挑战。我们的方法采用独立的无监督学习框架,结合蒸馏损失函数,使模型能够在增量学习过程中整合新的声音类别,同时保持 SED 模型的一致性。此外,我们在该框架中引入了一种无标签数据的样本选择策略,以及平衡的样本更新机制,以确保声音表示的多样性和代表性。我们在 DCASE 2023 Task 4 数据集上评估了多种持续学习方法,结果表明,本研究为构建能够适应新增声音类别的真实 SED 系统提供了有价值的见解,同时也为 CIL 在动态音频环境中的未来发展指明了方向。
论文链接:https://ieeexplore.ieee.org/document/10887631
分享主题2:Dark Experience for Incremental Keyword Spotting
摘要2:语音关键词检测(KWS)在音频输入中识别关键词至关重要,广泛应用于Apple Siri和Google Home等智能助手,特别是在边缘设备上。然而,当前基于深度学习的 KWS 系统通常仅针对有限的关键词集进行训练,当遇到新领域时,性能可能会下降。为了解决这一问题,研究人员通常采用小样本微调(few-shot fine-tuning),但这种方法往往会导致灾难性遗忘(catastrophic forgetting),即模型在新任务上的适应性提升的同时,其在原始数据上的表现大幅下降。为了解决这一挑战,研究人员提出了渐进式持续学习(CL)策略,但这些方法依赖任务 ID 信息,并且存储需求较大,限制了其在轻量级设备上的实用性。针对这些问题,我们提出了一种新颖的持续学习方法——Dark Experience for Keyword Spotting(DE-KWS),它利用暗知识(dark knowledge)在训练过程中蒸馏过去的经验。DE-KWS 结合重放(rehearsal)和蒸馏(distillation)策略,同时使用真实标签(ground truth labels)和存储在记忆缓冲区中的 logits,以维持模型在不同任务上的性能。在Google 语音命令(Google Speech Command)数据集上的评估结果表明,DE-KWS 在不增加模型大小的情况下,优于现有的持续学习基线方法,平均准确率更高,为资源受限的边缘设备提供了一种高效的解决方案。相关代码已开源至 GitHub。
论文链接:https://ieeexplore.ieee.org/document/10890228
代码链接:https://github.com/NeverlandCookies/DE-KWS
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇
预讲会征集
ICASSP 2025 论文预讲会面向全球线上招募,结合定向邀请与征集报名的方式,来选择预讲会的嘉宾。
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2025 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
预讲会报名方式
联系人邮箱:bd@speechhome.com
联系人微信