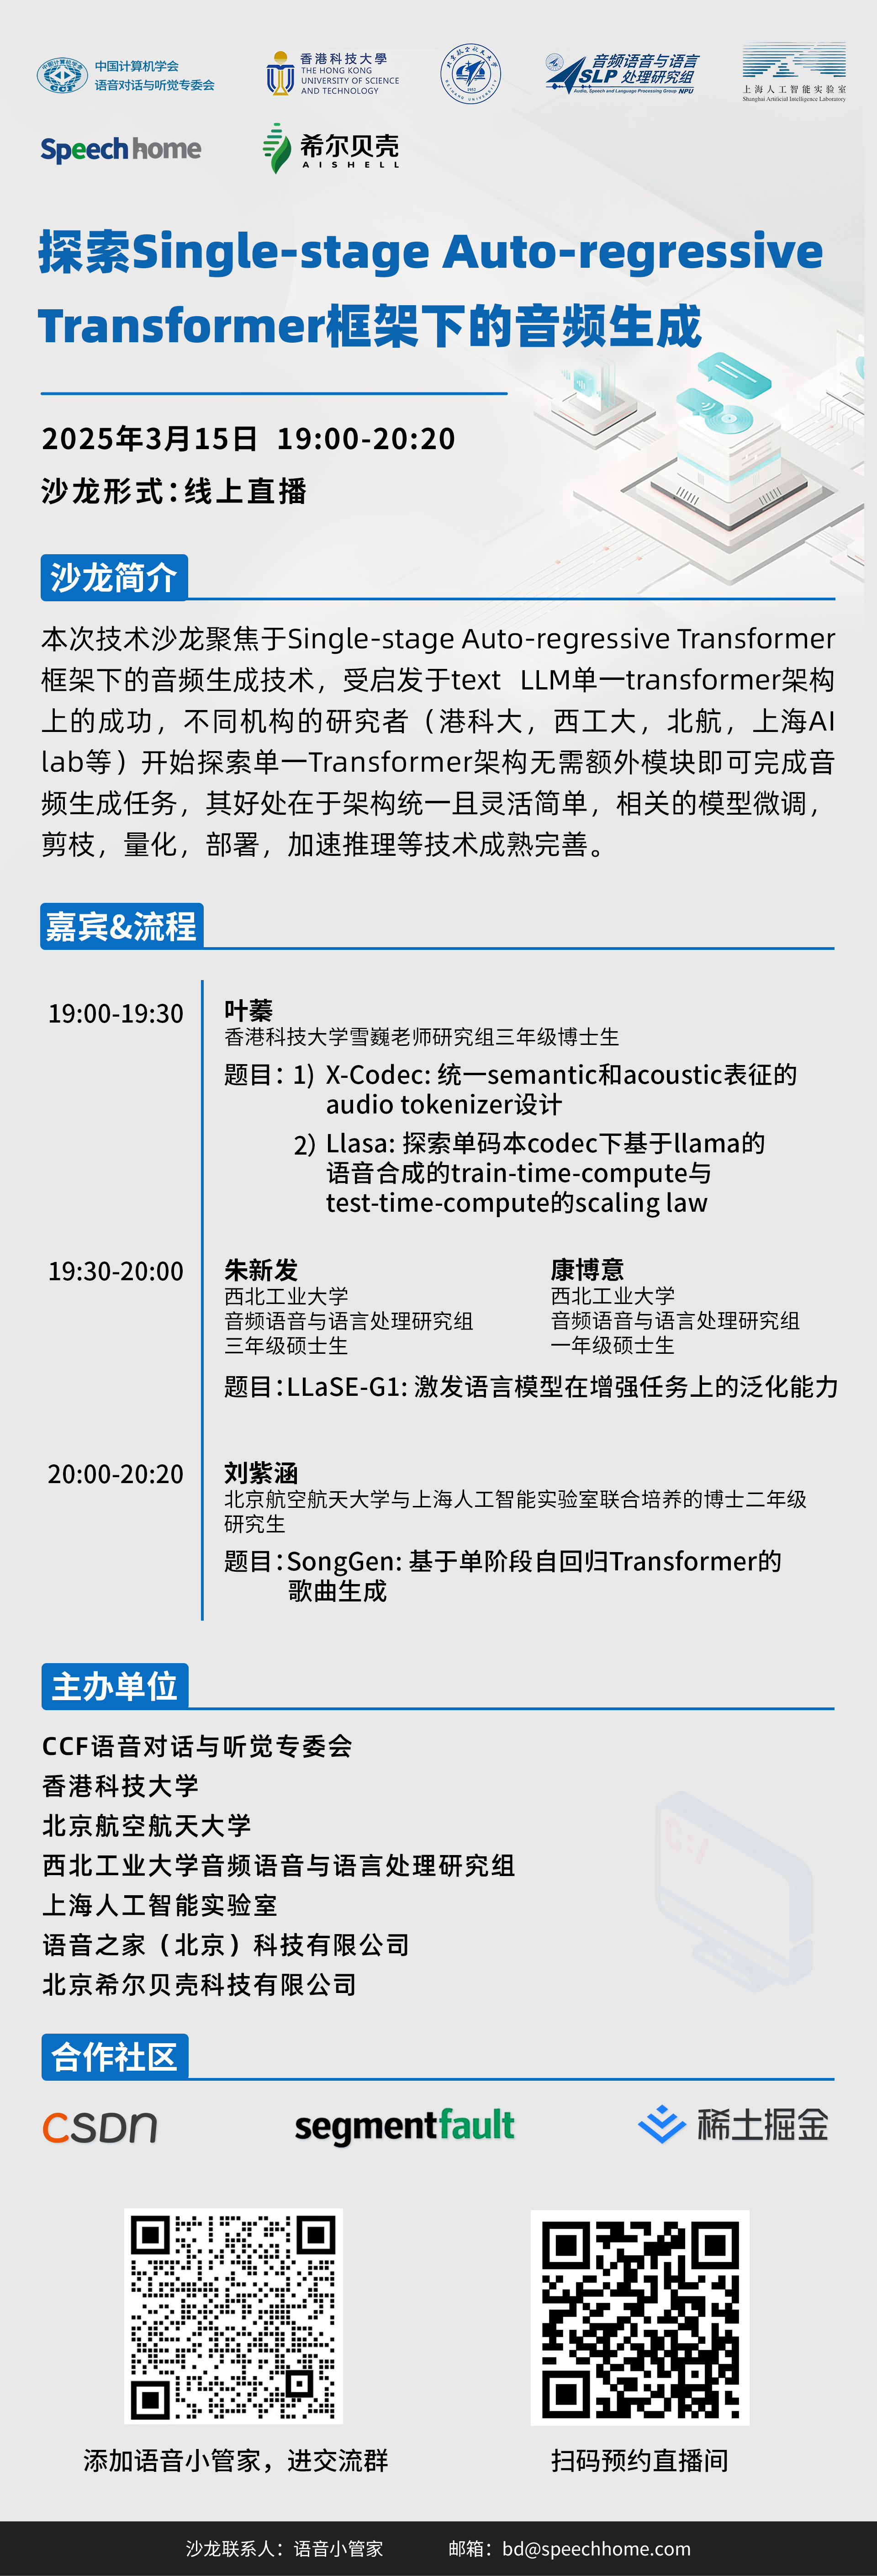
由CCF语音对话与听觉专委会 、香港科技大学、北京航空航天大学、西北工业大学音频语音与语言处理研究组、上海人工智能实验室、语音之家、希尔贝壳共同主办的 技术沙龙 — 探索Single-stage Auto-regressive Transformer框架下的音频生成,将于2025年3月15日19:00-20:20线上直播,欢迎大家预约观看。
沙龙简介
本次技术沙龙聚焦于Single-stage Auto-regressive Transformer框架下的音频生成技术,受启发于text LLM单一transformer架构上的成功,不同机构的研究者(港科大,西工大,北航,上海AI lab等)开始探索单一Transformer架构无需额外模块即可完成音频生成任务,其好处在于架构统一且灵活简单,相关的模型微调,剪枝,量化,部署,加速推理等技术成熟完善。本次技术沙龙,从音频的tokenizer设计开始,讨论单一Transformer架构在语音合成(Llasa)、语音增强(LLaSE-G1)及歌曲生成(SongGen)等任务中的应用,分享前沿突破与未来启发。
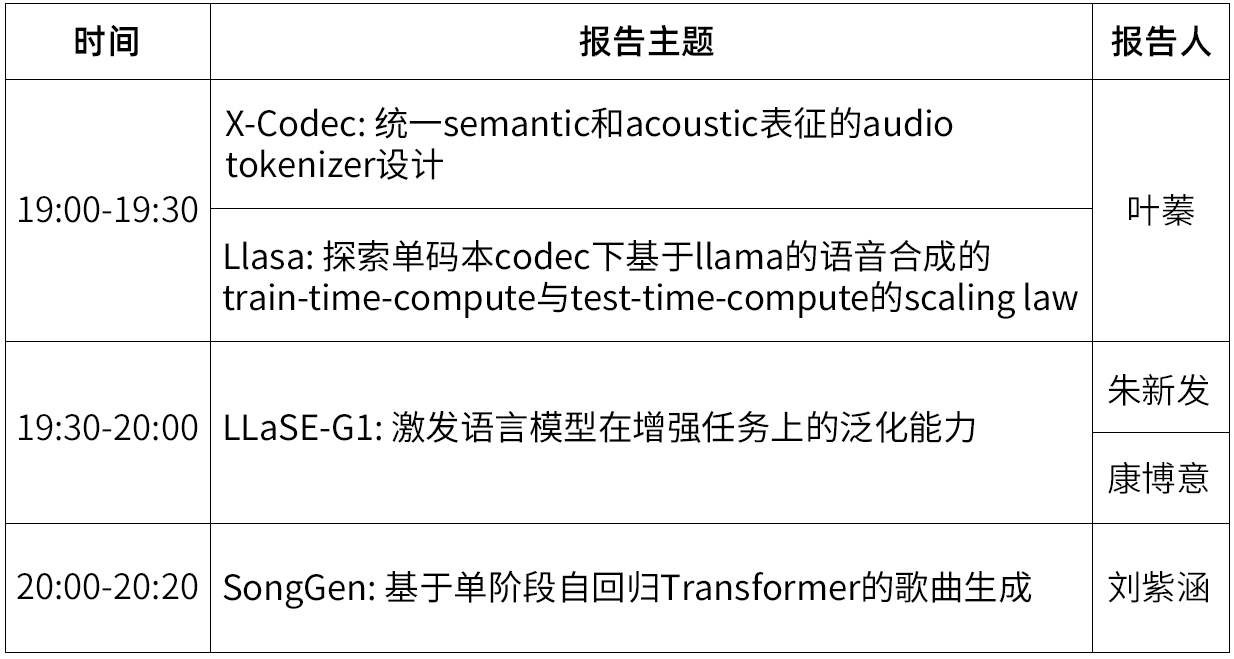
沙龙议程
时间:3月15日(周六)19:00 - 20:20
报告嘉宾
嘉宾简介:叶蓁,香港科技大学雪巍老师研究组三年级博士生,研究方向为音频生成。在ICLR、ACM MM、AAAI、IJCAI、NAACL、EMNLP等会议发表一作及合作论文十余篇。
报告题目1:Codec Does Matter: Exploring the Semantic Shortcoming of Codec for Audio Language Model
摘要1:近年来,大型语言模型(LLM)的能力显著推动了音频生成技术的进步。目前关于音频LLM的研究主要集中在优化音频语言模型的架构和规模、利用更大的数据集,以及通常使用如EnCodec等声学Codec进行音频tokenization。然而,这些codec最初是为音频压缩设计的,在音频LLM的背景下可能会导致性能不佳。我们的研究旨在解决当前音频LLM中codec的不足,特别是它们在生成音频时维持semantic上的挑战。例如,像VALL-E这样的现有方法,常常因acoustic tokens的缺乏对语义的理解而出现内容不准确和高词错率(WER),导致单词遗漏和错误。
为了克服这些问题,我们提出了一种简单而有效的方法,称为X-Codec。X-Codec在Residual Vector Quantization(RVQ)阶段之前引入了预训练语义encoder的语义特征比如hubert,并在RVQ之后引入了语义reconstruction loss。通过增强codec的语义能力,X-Codec在语音合成任务中显著降低了WER,并将这些优势扩展到非语音应用场景,包括音乐和声音生成。我们在text-to-speech、music continuation以及text-to-sound任务中的实验表明,整合语义信息能够大幅提升语言模型在音频生成中的整体性能。
论文:https://arxiv.org/abs/2408.17175
代码:https://github.com/zhenye234/xcodec
模型:https://huggingface.co/ZhenYe234/xcodec/tree/main
Demo:https://x-codec-audio.github.io/
报告题目2:Llasa: Scaling Train-Time and Inference-Time Compute for Llama-based Speech Synthesis
摘要2:近年来,基于文本的LLMs,特别是GPT系列和o1模型,展示了增加training-time和inference-time计算资源对性能提升的有效性。然而,当前利用LLMs的TTS(text-to-speech)系统往往是多阶段的,需要额外的模型(例如LLM之后的diffusion models),这使得在训练或测试时决定是否对某个特定模型进行scaling变得复杂。本研究做出了以下贡献:首先,我们探索了语音合成中train-time和inference-time compute的scaling law。其次,我们提出了一个简单的语音合成框架Llasa,该框架采用单层vector quantizer(VQ)codec和单一的Transformer架构,完全对齐类似Llama这样的标准LLMs。我们的实验表明,为Llasa增加train-time计算资源能够持续改善合成语音的自然度,并更好的理解text输入,以及生成更复杂、更准确的prosody韵律模式。此外,从scaling inference-time compute的角度,我们在搜索过程中使用speech understanding模型作为verifiers,发现增加inference-time计算资源会使sampling向特定verifier的偏好偏移,从而提升情感表达能力、音色一致性和内容准确性。另外,我们公开发布了TTS模型(1B、3B、8B)和codec模型的checkpoint及训练代码。
论文:https://arxiv.org/abs/2502.04128
代码:https://github.com/zhenye234/LLaSA_training https://github.com/zhenye234/X-Codec-2.0
模型:https://huggingface.co/collections/HKUSTAudio/llasa-679b87dbd06ac556cc0e0f44
Demo:https://llasatts.github.io/llasatts/
嘉宾简介:朱新发,西北工业大学音频语音与语言处理研究组三年级硕士生,研究方向为语音理解与生成,包括表现力语音合成、基于语言模型的语音生成与语音理解等。在TASLP、ACM MM、ICASSP、ICME等语音顶级期刊或会议发表一作及合作论文数十篇,国家奖学金获得者。
嘉宾简介:康博意,西北工业大学音频语音与语言处理研究组一年级硕士生,研究方向为语音增强与理解。2024年推免至ASLP实验室,曾获西工大本科生国家奖学金。
报告题目:LLaSE-G1: Incentivizing Generalization Capability for LLaMA-based Speech Enhancement
摘要:语言模型 (LM) 的最新进展已展示出强大的语义理解和上下文建模能力,并在生成式语音增强 (SE) 中蓬勃发展。然而,许多基于 LM 的 SE 方法主要关注语义信息,往往忽略了声学信息的关键作用,这导致增强后的声学不一致,并且在各种 SE 任务中的泛化有限。在本文中,我们介绍了 LLaSE-G1,这是一种基于 LLaMA 的语言模型,旨在激励语音增强的泛化能力。LLaSE-G1 提供了以下关键贡献:首先,为了减轻声学不一致,LLaSE-G1 采用来自 WavLM 的连续表示作为输入,并预测来自 X-Codec2 的语音标记,从而最大限度地保留声学信息。其次,为了提高泛化能力,LLaSE-G1 引入了双通道输入和输出,统一了多个 SE 任务,且无需任务ID。第三,LLaSE-G1优于之前特定于任务的判别和生成 SE 模型,并展示了扩展效果以及针对未见过的 SE 任务的涌现能力。
论文:https://arxiv.org/pdf/2503.00493
代码:https://github.com/Kevin-naticl/LLaSE-G1
模型:https://huggingface.co/ASLP-lab/LLaSE-G1
Demo:https://submission-papers.github.io/LLaSE-G1-demo-page/
嘉宾简介:刘紫涵,北京航空航天大学与上海人工智能实验室联合培养的博士二年级研究生,研究方向为音乐生成与理解。在KDD, IJCAI等会议发表一作论文2篇。
报告题目:SongGen: A Single Stage Auto-regressive Transformer for Text-to-Song Generation
摘要:Text-to-Song 任务旨在根据文本描述控制歌曲生成。然而,由于歌曲的复杂性和标注数据的稀缺性,该任务面临诸多挑战。现有方法通常依赖多阶段生成流程,例如先合成人声,再为其配上伴奏,这种方式导致训练和推理过程较为繁琐。本文提出了SongGen,一个完全开源的单阶段自回归Transformer模型。SongGen 能够基于文本描述灵活控制多种音乐属性,包括乐器、音乐流派、情绪和音色等。此外,模型支持可选的三秒参考人声片段,实现个性化音色克隆。SongGen 采用统一的自回归架构,并支持两种输出模式:混合模式(mixed mode),直接生成融合人声与伴奏的完整音频;双轨模式(dual-track mode),分别合成人声和伴奏,以提供更大的后期处理灵活性。针对不同模式,我们探索了多种 token 组合策略,显著提升了生成效果,并提供了深入的分析与见解。
论文:https://arxiv.org/abs/2502.13128
代码:https://github.com/LiuZH-19/SongGen
Demo:https://liuzh-19.github.io/SongGen/
参与方式
直播将通过语音之家微信视频号进行直播
手机端、PC端可同步观看
👇👇👇