ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会第二十一期邀请到南开大学人类语言技术实验室做本次会议的专场分享,欢迎大家观看。
实验室概况
第二十一期
南开大学人类语言技术实验室【专场】
时间:3月30日(周六)19:00 ~ 20:00
形式:线上
议程:每位嘉宾分享30分钟(含5分钟QA)
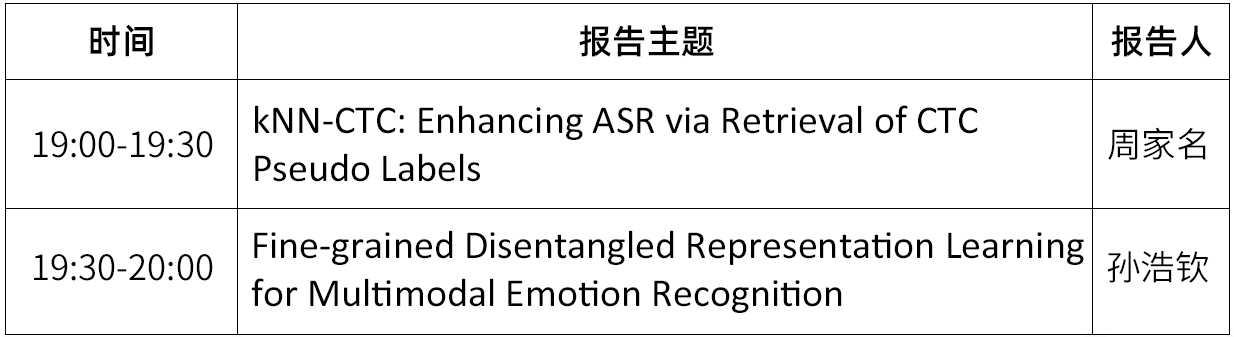
嘉宾&主题
嘉宾简介:周家名,南开大学计算机学院人类语言技术实验室,二年级硕士生,导师为秦勇教授。主要研究方向语音识别,领域适配。
分享主题:kNN-CTC: Enhancing ASR via Retrieval of CTC Pseudo Labels
我们的代码将开源在:https://github.com/NKU-HLT/KNN-CTC
嘉宾简介:孙浩钦,南开大学计算机学院人类语言技术实验室,一年级博士生,导师为秦勇教授。主要研究方向多模态情感识别。
摘要:多模态情感识别(MMER)是一个活跃的研究领域,旨在通过融合多种感知模态来准确识别人类情感。然而,各模态之间固有的异质性带来了分布差距和信息冗余,给多模态情感识别带来了巨大挑战。在本文中,我们提出了一种细粒度解耦表征学习(FDRL)框架来应对这些挑战。具体来说,我们设计了模态共享和模态私有编码器,将每个模态分别投射到模态共享子空间和模态私有子空间中。在共享子空间中,我们引入了细粒度对齐组件来学习模态共享表征,从而捕捉模态一致性。随后,我们定制了一个细粒度差异组件来约束私有子空间,从而学习模态私有表征并增强其多样性。最后,我们引入了细粒度预测组件,以确保编码器输出表征的标签属性保持不变。在 IEMOCAP 数据集上的实验结果表明,FDRL 的表现优于最先进的方法。
直播将通过语音之家微信视频号进行直播
讨论群
扫码添加语音小管家,进入语音之家讨论群
为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信