ICASSP 2024 论文预讲会由CCF语音对话与听觉专委会、语音之家主办,旨在为学者们提供更多的交流机会,更方便、快捷地了解领域前沿。活动将邀请 ICASSP 2024 录用论文的作者进行报告交流。
ICASSP 2024 论文预讲会邀请到西工大音频语音与语言处理研究组在3月20日和3月21日分别做两期专场分享,本文介绍第一场相关内容,欢迎大家预约观看。
实验室概况
西北工业大学音频语音与语言处理研究组(ASLP@NPU)依托于空天地海一体化大数据应用技术国家工程实验室和陕西省语音与图像信息处理重点实验室。研究组成立于1995年,经过近20多年的快速发展,已形成了人机语音交互、语音与音频信号处理、音视频多模态信息处理、多媒体内容分析、机器学习等主要研究方向。研究组与比利时、英国、美国、新加坡等多所高校与研究机构建立了长期合作关系,同时,实验室与工业界联系密切,目前已经与华为、腾讯、微软、阿里巴巴、小米、网易、字节跳动、美团、爱奇艺、网易、出门问问等行业头部企业与初创公司开展了广泛深入的科研合作,众多研究成果已经在实际产品中获得应用,获得华为技术合作奖、美团科研合作奖等。实验室在领域顶级期刊和会议上发表学术论文300余篇,在多个重要会议上获得多篇优秀论文奖,参加多个国际国内技术评测获得第一名,取得了丰硕的研究成果。实验室入选2019《互联网周刊》十大顶尖高校人工智能实验室。

第十二期
西工大音频语音与语言处理研究组(一)【专场】
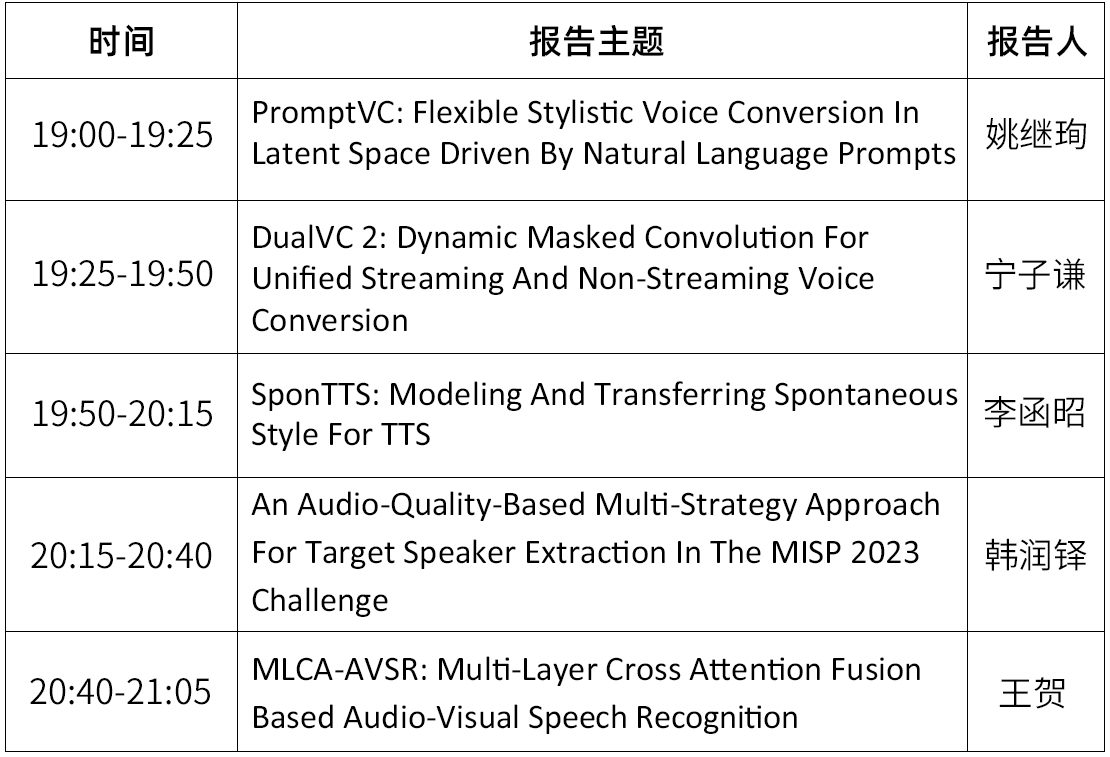
时间:3月20日(周三)19:00 ~ 21:05
形式:线上
议程:每位嘉宾分享25分钟(含5分钟QA)
嘉宾&主题
嘉宾简介:姚继珣,西北工业大学音频语音与语言处理研究组三年级博士生,研究方向为语音转换,包括带噪语音转换、风格语音转换以及说话人匿名化。在TASLP、AAAI、ICASSP、INTERSPEECH等语音顶级期刊或会议发表一作及合作论文十余篇。
分享主题:PromptVC: Flexible Stylistic Voice Conversion In Latent Space Driven By Natural Language Prompts
摘要:风格语音转换旨在将源语音的风格转换为目标风格。但大多数当前的风格语音转换方法依赖于预定义的标签或参考语音来控制风格转换过程,这导致了风格多样性受限以及风格表示的直观性和可解释性方面存在不足。本文提出了一种基于扩散模型(LDM)的风格语音转换方法,采用潜在扩散模型生成由自然语言提示(Prompt)驱动的风格向量。在训练期间,风格向量由风格编码器提取,然后独立训练潜在扩散模型从噪声中对风格向量进行采样,该过程以自然语言描述作为条件。为了提高风格转换的表现力,利用HuBERT提取离散Token,并用K-Means中心簇替换离散Token作为语言内容,从而最小化源语音中的残余风格信息。此外去重相同的离散Token,并使用可微的时间预测器重新预测每个标记的时长,以适应相同语言内容在不同风格下的时长。主观和客观实验结果表明了本文提出的方法的有效性。
摘要:随着语音转换(VC)的逐渐流行,越来越多的应用场景需要具有流式推理能力的模型。我们先前提出的 DualVC 试图通过流式模型架构设计和模型内知识蒸馏以及混合预测编码来弥补未来信息的不足,从而实现这一目标。然而DualVC 存在以下几个问题。首先,自回归解码器具有误差累积的特性,也限制了推理速度。其次,因果卷积实现了流式推理能力,但无法充分使用chunk内的未来信息。第三,该模型无法有效处理无人声段中的噪声,从而降低了整体音质。为此,本文提出了 DualVC 2 来解决这些问题。具体来说,我们将模型主干结构迁移到基于 Conformer 的架构上,从而实现并行推理。以带有动态chunk掩码的非因果卷积取代因果卷积,更好地利用块内的未来信息。此外还引入了安静注意力(quite attention)机制,以增强模型的噪声鲁棒性。实验表明,DualVC 2 在主观和客观指标上均优于 DualVC 和其他基线系统,延迟时间仅为 186.4 毫秒。
嘉宾简介:李函昭,西北工业大学音频语音与语言处理研究组二年级研究生,主要研究方向为歌唱合成、表现力语音合成、语音 Codec多个方向。已在 ICASSP、INTERSPEECH 等语音会议发表一作及合作论文四篇。
摘要:自发语音合成(Spontaneous speech synthesis)旨在模仿人类自然说话的方式,包括讲话中出现的不自觉停顿、拖音等自发现象,以及更加多变的语气、语调、语速和节奏,甚至包括一些非语言内容,如笑声。这些因素使得自发风格语音合成具有挑战性。此外,受限于高质量的自发风格数据稀缺的情况,合成带有目标说话人音色的自发风格语音成为一项挑战。为了解决这些问题,本文借助神经网络瓶颈 (BN) 特征来解耦说话人音色和风格,提出了一种基于两段式的方法来建模和迁移自发风格,称为 SponTTS。第一阶段使用条件变分自编码器(CVAE)从 BN 特征中学习自发风格表征,并通过自发现象标签预测损失来约束该表征与自发现象相关。为了在推理阶段能够预测出符合上下文语境的自发现象并丰富韵律变化,引入了基于流(Flow)的自发风格预测器,从文本中预测自发风格表征。第二阶段使用类似 VITS 的模块,利用 BN 特征和目标说话人音色嵌入作为输入来合成目标说话人音频。实验结果表明,SponTTS 能够有效使用目标说话人音色模拟自发说话风格,生成高自然度、高表现力、高音色相似度的自发风格语音。零样本(zero-shot)测试结果进一步验证了 SponTTS 在生成未见说话人的自发风格语音方面的鲁棒性和泛化能力。
嘉宾简介:韩润铎,西北工业大学音频语音与语言处理研究组一年级研究生,主要研究方向为单通道语音增强、目标说话人提取、模型压缩。在ICASSP、INTERSPEECH和ASRU语音顶会发表一作及合作论文共4篇,竞赛方面获得MISP2023挑战赛亚军,参与CHiME-7 Task2竞赛以及首届“声华杯”声学技术大赛语音增强赛道获得冠军。
摘要:我们在2023年多模态信息语音处理(MISP)挑战中提出了一种基于音频质量的多策略方案,用于音视频目标说话人提取(AVTSE)任务。该方案根据音频质量的高低采取不同的目标说话人提取策略,平衡了干扰声音的移除和语音的保留,有利于后端自动语音识别(ASR)系统。实验表明,该方案在开发集和评估集上分别实现了24.2%和33.2%的字符错误率(CER),在挑战中获得了第二名的优异成绩。
摘要: 在嘈杂环境中,语音识别(ASR)系统的性能通常会显著下降,而基于音频和视频的视听语音识别(AVSR)系统可以利用不受噪声影响的是视频对受损的音频信息进行补充,提高系统整体的鲁棒性。不过,目前的视听语音识别研究主要集中在融合经过建模的音视频模态高维表征,比如编码器的输出,没有考虑在模态特征建模期间的音视频上下文信息。本文提出了一种基于多层交叉注意力机制的AVSR(MLCA-AVSR)方法,在音频和视频编码器的不同层利用交叉注意力机制融合音视频信息。实验阶段采用了MISP2022-AVSR数据集来验证MLCA-AVSR的有效性,并在测试集上实现了30.57%的最小连接排列字符错误率(cpCER),相较于我们在MISP2022挑战赛中提交的系统降低了3.17%。在融合多个系统之后,cpCER进一步降低至29.13%,超越了挑战赛的第一名,取得了该数据集上SOTA的性能。
参与方式
直播将通过语音之家微信视频号进行直播
讨论群
扫码添加语音小管家,进入语音之家讨论群

为了共创高质量的论文预讲会,我们诚挚邀请所有 ICASSP 2024 作者参与到此次预讲会活动中来,也欢迎大家推荐适合此次预讲会活动的学者。
联系人邮箱
bd@speechhome.com
联系人微信