ASR工业级代码-WeNet代码逐行分析(10)forward小结
目的 小结一下WeNet, bidecoder架构下的, 在Train的时候,涉及encoder/decoder/loss的,所有的forward函数。 要好好研究forward函数,需要: root@1032f8d48655:/# vi…
380 0 0

目的 小结一下WeNet, bidecoder架构下的, 在Train的时候,涉及encoder/decoder/loss的,所有的forward函数。 要好好研究forward函数,需要: root@1032f8d48655:/# vi…
启动脚本 第一个inference的算法 attention rescoring,就在上面part -6 学习了。 本次学习第二个inference算法:ctc greedy search。 这个只需要在运行脚本中增加: decode_mo…
目前的位置: encoder的forward走完了 在所有12层ConformerEncoderLayer的forward执行完毕之后,最后还有个after_norm 来最后搞一次layer normalization。 至此,Encode…
目前的位置 开始训练! 一个batch已经组装好了,开始进入训练 目前的代码位置: > /workspace/asr/wenet/wenet/utils/executor.py(43)train() 42 import ipdb; ipdb…
填坑cmvn cmvn : 计算mean, variance, count of frame这三个量。上次并没有详细分析计算cmvn的细节,这里把这个坑填了。 启动准备 tools/compute_cmvn_stats.py
本文目的是彻底摸清WeNet这个神作的细节,对于一些模棱两可的印象纠偏。我这次学习的版本是自己folk的:https://github.com/Xianchao-Wu/wenet 准备工作 老样子,先交代一下我用的docker,我还是随便找…
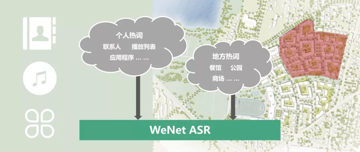
在语音识别的实际应用中,对于常用的词汇识别效果比较好,但是对于一些特有的人名、歌名、地名或者某个领域的专有词汇,例如人名宋星辰、歌名国际歌、地名丽泽商务区以及语音识别专业词汇解码器,可能存在识别准确率不高的情况。对于这些专有词汇,通过在 W…
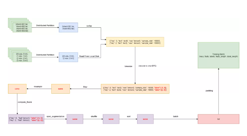
近日,WeNet 中更新了超大规模数据 UIO (Unified IO) 支持,可以支持工业级千万小时级别的语音数据训练,支持云存储 OSS/S3/HDFS 等,并且训练速度更快,接口更简单,更容易使用和调试。 旧有 IO 方案的问题 We…
端到端语音识别技术,如何更好的落地? 出门问问开源端到端语音识别框架 WeNet GitHub star 数已超 1300 今年2月,中国人工智能公司出门问问联合西北工业大学推出了全球首个面向产品和工业界的端到端语音识别开源工具 —— We…
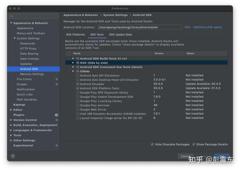
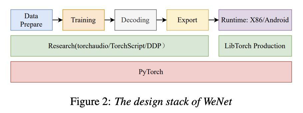
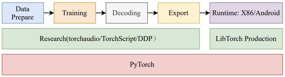
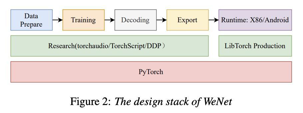
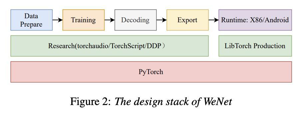
WeNet 是出门问问联合西北工业大学推出端到端语音识别工具,并且开源在 Github 上。为了方便大家使用,本文将教大家如何在 Android 手机中构建一个语音识别系统。 本文的示例运行环境如下所示: CPU (Intel x86_64…