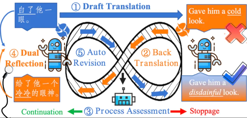
在大模型时代,机器翻译有哪些新变化?

大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
15 0 0

大家好,欢迎来到「AudioCC交我学」专栏! 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术…
来源丨AI理想同学 近日,理想同学发布了基座模型 MindGPT 3.1 ,是具备极速推理能力的智能体语言模型。 MindGPT 3.1 具备如下能力: 极速响应:每秒出字速度最高可达 200 Tokens,相比上一代模型 MindGPT…
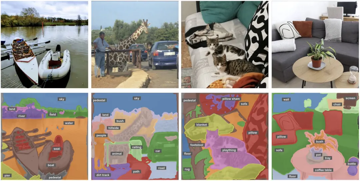
在计算机视觉领域,标注数据一直是“刚需”。但人工标注不仅费时费力,还存在主观偏差,尤其在医学影像、卫星图像等专业领域,更是难以规模化获取高质量标注数据。 为了解决这个痛点,Meta AI 近日正式开源了全新一代通用图像识别模型:DINOv3…
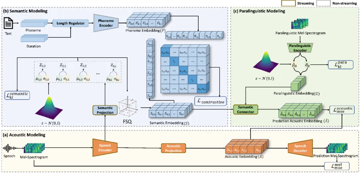
快手科技、天津大学、中科院自动化所与清华大学联合发布了SecoustiCodec,一种跨模态对齐的流式单码本语音Codec。支持语义信息、副语言信息、声学信息的独立编码与重构。可以应用于语音合成、语音对话模型等生成式语音任务。 论文题目:S…
来源丨本原智数、HyperAI超神经 近日,谷歌DeepMind正式发布并开源了全新的生物声学模型Perch 2.0。相较于前代,Perch 2.0 以物种分类为核心训练任务,不仅纳入了更多非鸟类类群的训练数据,还采用了全新的数据增强策略与…
来源丨AI音频时代 AI音乐创作领域又迎来了一个重磅竞争对手!ElevenLabs公司于2025年8月5日正式发布了其最新研发成果——Eleven Music,一款强大的文字转音乐AI模型。据称,这款工具不仅能够生成任意风格的录音室级别音频…
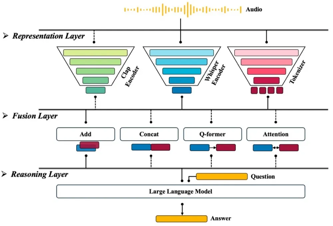
近日,2025年IEEE AASP举办的DCASE挑战赛(Challenge on Detection and Classification of Acoustic Scenes and Events)落幕。作为目前声音事件领域最权威的竞赛…
来源丨新智元 擅长「种草」的小红书正加大技术自研力度,两个月内接连开源三款模型!最新开源的首个多模态大模型dots.vlm1,基于自研视觉编码器构建,实测看穿色盲图,破解数独,解高考数学题,一句话写李白诗风,视觉理解和推理能力都逼近Gemi…
来源丨AIGC开放社区 今天凌晨1点30,OpenAI开源了大模型GPT-oss,一共有1200亿和200亿两种参数,支持Apache 2.0商业化。 开源地址: https://github.com/openai/GPT-oss http…
论文题目:Multi-Input Multi-Output Target-Speaker Voice Activity Detection For Unified, Flexible, and Robust Audio-Visual Spe…