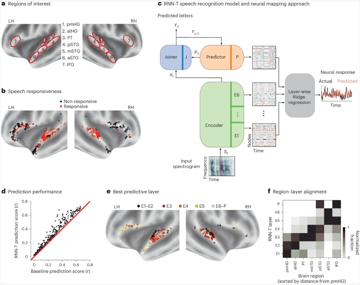
研究发现,人工智能语音识别模型与人类大脑的语音处理机制高度相似

在过去几十年中,计算机科学家开发了许多能够处理不同语言的人类语音的人工智能(AI)系统。然而,这些模型在多大程度上复刻了人类理解口语时的大脑运作机制,目前尚无明确结论。 哥伦比亚大学、IBM研究院和费恩斯坦医学研究所的研究人员最近开展了一项…
28 0 0

在过去几十年中,计算机科学家开发了许多能够处理不同语言的人类语音的人工智能(AI)系统。然而,这些模型在多大程度上复刻了人类理解口语时的大脑运作机制,目前尚无明确结论。 哥伦比亚大学、IBM研究院和费恩斯坦医学研究所的研究人员最近开展了一项…
FireRed-OpenStoryline将复杂的视频创作转化为自然直观的对话体验。兼顾易用性和企业级可靠性,让视频创作对初学者和创意爱好者都变得简单友好。 项目简介 FireRed-OpenStoryline是FireRedTeam团队开…
今天,阶跃正式发布新一代自动语音识别模型StepAudio 2.5 ASR! 这款模型的核心突破在于速度与精度的兼得。我们率先将大语言模型(LLM)的推理加速技术引入语音识别领域,基于 ASR+MTP-5 深度融合架构,实测推理速度提升40…
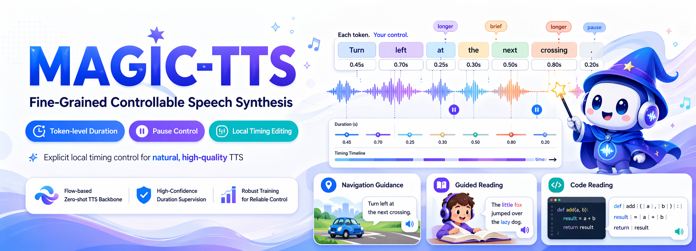
在今天的语音合成系统里,听起来自然已经不再稀缺,但哪里该慢一点、哪个字该拉长、哪个位置该停顿、停多久,依然很难真正交给用户来控制。 但这恰恰是很多真实应用场景在意的问题。 比如导航播报里,“前方路口左转”中的“左转”往往需要更清楚、更突出;…
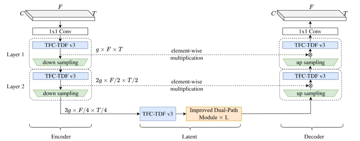
AudioCC交我学 作为学术研究者与实践者的连接点,我们致力于打造一个专注于语音技术的学术交流平台——「AudioCC交我学」专栏。在这里,我们将以简洁、专业的视角,解读听觉认知与计算声学领域的前沿论文,分享技术创新与应用实践的最新动态。…
今天,小米发布MiMo-V2.5-TTS Series与MiMo-V2.5-ASR—— 一套面向 Agent 时代的全链路语音模型系列,覆盖识别与合成两大核心能力,让语音的输入与输出都可以被语言自由调度。 MiMo-V2.5-TTS Ser…
近期,浙江大学研究者提出了WavAlign: Enhancing Intelligence and Expressiveness in Spoken Dialogue Models via Adaptive Hybrid Post-Trai…
Annual Meeting of the Association for Computational Linguistics(简称 ACL)年会是计算语言学和自然语言处理领域国际排名第一的顶级学术会议,由国际计算语言学协会组织,每年召开一…
