语音识别引擎Wenet系列四:进阶话题:Cache

经超哥同意,接下来几篇文章将转载超哥写的《Wenet网络设计与实现》。感兴趣的读者可以关注知乎杨超,同时wenet1.0正式发布( wenet1.0正式发布:更快更高更强更有生产力https://mp.weixin.qq.com/s/CG6…
621 0 0

经超哥同意,接下来几篇文章将转载超哥写的《Wenet网络设计与实现》。感兴趣的读者可以关注知乎杨超,同时wenet1.0正式发布( wenet1.0正式发布:更快更高更强更有生产力https://mp.weixin.qq.com/s/CG6…
作者:忧郁的白衬衫 20121.07.06,GigaSpeech 重磅发布 GigaSpeech:10000小时多领域英语开源数据集发布。GigaSpeech 拥有10000小时的高质量标注音频数据和33000小时的总音频,是有史以来标注数…
2021年2月19日,出门问问联合西北工业大学音频语音与语言处理研究组推出面向产品和工业界的端到端语音识别开源工具 WeNet。WeNet 自发布以来,因为其简洁性、易用性和产品优先 (Production First and Produc…
这次 WeNet 带来的更新是 U2++ 双向建模,其核心思想是同时利用标注序列的前向和后向信息训练模型,在解码时同时利用双向的 decoder 进行 re-score。实验证明,该方法在各个数据集上都能取得一致性的5%~8%的相对错误率的…
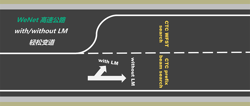
近日,WeNet 中增加了对语言模型(Language Model, LM)的支持。WeNet中选择基于 n-gram 的统计语言模型,结合WFST(Weighted Finite State Transducer)框架和传统语音识别解码技…
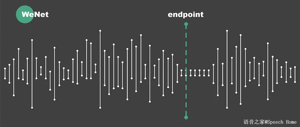
Endpoint 检测是语音识别系统的重要组成部分,可以提高人机交互的效能和质量。它的任务是确定用户何时结束讲话,这对于实时长语音转写和语音搜索等交互式语音应用非常重要。 最近,WeNet 的更新则支持了 endpoint 的检测。有了 e…
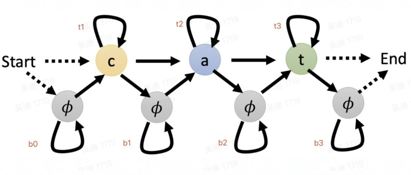
Force alignment(强制对齐)是语音任务中的一个常用模块,在帧级别的语音识别和语音合成任务中应用广泛,同时也是字幕自动打轴、口语评测等任务中的核心算法。强制对齐和识别解码有一定的相似性,识别解码是指给定一个语音识别模型,输入一个…
WeNet更新支持了时间戳。解码器不仅可以返回 Nbest 解码结果,而且还可以返回其中每个字对应的时间信息。 在语音识别一些任务中,字级别的的时间戳和N-best 扮演着重要的作用。例如在视频应用中,语音识别结合字级别的时间戳可以在精确的…
希尔贝壳和出门问问合作,在 WeNet 中更新了对 AISHELL-2 数据集的支持,开放数据准备、训练和解码测试和部署等流程,并开放基于 AISHELL-2 的预训练模型。其中,AISHELL-2 数据由希尔贝壳提供。希尔贝壳开源数据致力…
WeNet是出门问问联合西北工业大学推出的端到端语音识别工具,并且已经开源在Github上。为了方便大家使用,本文将教大家如何在Android手机中构建一个语音识别系统。 本文示例运行的环境为CPU (Intel x86_64) + Mac…