语音与音频学术速递[8.20]

今日论文合集:CS.SD语音与音频 | 共 5 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Geometric Iterati…
155 0 0

今日论文合集:CS.SD语音与音频 | 共 5 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Geometric Iterati…
今日论文合集:CS.SD语音与音频 | 共 6 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. A Multiplication-…
今日论文合集:CS.SD语音与音频 | 共 11 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Adding Voice Clo…
近年来,大规模语音识别模型在普通话识别上取得了显著进展,但中文方言识别仍然面临数据稀缺、地域差异大、声学与词汇分布复杂等挑战。一个常见做法是在预训练 ASR 模型上继续使用方言数据进行微调,虽然能够有效提升方言识别性能,却往往会导致模型原有…
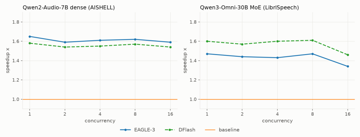
投机解码(Speculative Decoding)可以在不改变模型输出的前提下加速自回归解码。本文介绍我们在 ASR 和 TTS 两类语音任务上的投机解码实践:ASR方向,Qwen2-Audio-7B和 Qwen3-Omni-30B 使用…
多语言语音识别在向低资源语言扩展时,通常需要按顺序适配多种新语言,如何在学习新语言的同时不损害已有语言的性能至关重要。近期,清华大学语音与音频技术实验室(SATLab)提出了一种融合语言均衡梯度投影与经验回放的统一持续学习方法(UGP),利…
今日论文合集:CS.SD语音与音频 | 共 4 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Alignment Drift i…
传统的自动语音识别系统主要遵循"单次通行(Single-pass)"的转录范式,将识别过程视为从音频到文字的开环映射任务。这种范式在交互逻辑上缺乏"反馈-修复"机制,在评价维度上无法区分关键语义错误与无关紧要的字面偏差。本文解读的论文 To…
今日论文合集:CS.SD语音与音频 | 共 9 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. CookVoice: Unifie…
今日论文合集:CS.SD语音与音频 | 共 10 篇。 本文经arXiv每日学术速递授权转载,微信公众号:arXiv_Daily [机构]信息由AI分析生成,可能存在错误,仅供参考,以论文实际显示为准 1. Whisper-Aware LL…
