语音小管家
论文题目:AnyEdit: A Unified Framework for Speech and Singing Voice Editing with Real-World Environmental Consistency
收录会议:NeurIPS 2026
文章链接:https://arxiv.org/abs/2610.15665
项目主页:https://any-edit.github.io/
「现存问题」
播客录完口误、录好的歌曲想改几句歌词,我们只想修改一小段音频,不想全部重录。
但现实里的录音很少干干净净:混着环境噪音、房间回声,唱歌还会带上伴奏音乐。想要局部修改某几句,既要改对文字、保住本人音色,还不能破坏原本的背景声音,这件事一直很难做好。
目前行业主要两套方案,但都各有明显短板:
1.直接端到端编辑:把带噪音、伴奏的音频直接丢进模型修改。但模型会把 “修改内容” 和 “环境噪音” 搅在一起,经常改完后人声变味,原本的背景直接消失错乱。
2.分离‑编辑‑再混音:先把人声和背景拆开,修改干净人声之后,再拼回背景音。 这套方案坑点很多:拆分人声本身就会带来音质损伤,唱歌场景伴奏和人声高度重叠,分离失真会更严重;也很难处理音量渐强渐弱这类动态背景。很多方案干脆把整段音频全部重生成,并不是只改目标片段,原始录音的细微质感直接丢失。
那能不能拿到一段乱糟糟的真实录音,不用拆分人声,只改指定片段,说话、唱歌都能搞定,改完文字、音色、背景全部保留?
AnyEdit 给出了解决思路。 它的核心思路很简单:把 “修改人声内容” 和 “还原环境音效” 两件事拆开做。先在虚拟干净空间完成语义修改,再单独把噪音、混响、伴奏等环境效果渲染回去,全程跳过声源分离这个容易出问题的环节。
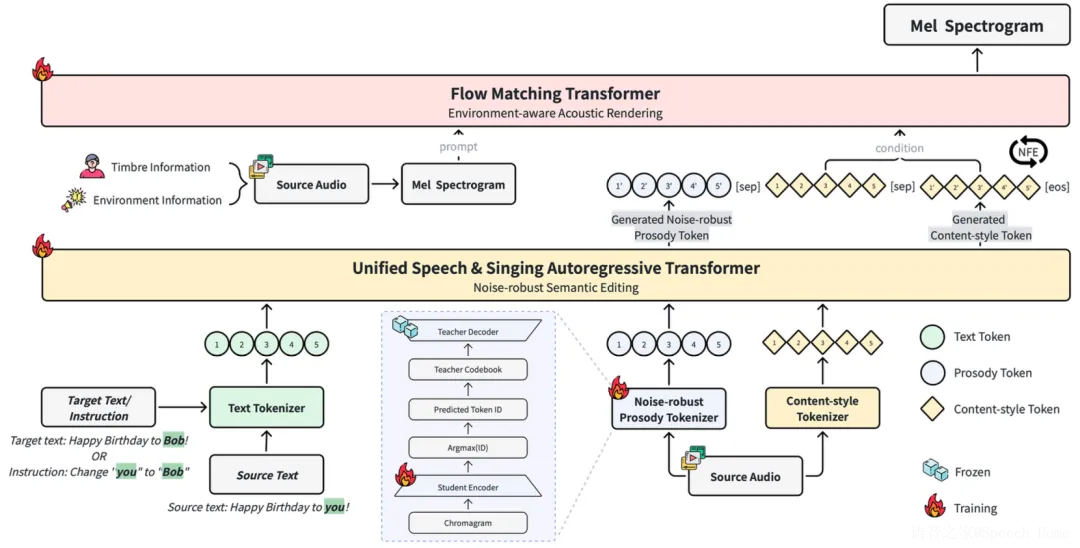
AnyEdit系统架构,分为 (1) 基于自回归的语义编辑模型(AR Transformer)和 (2) 基于Flow Matching的声学渲染模型(FMT)
语义编辑与环境渲染分开处理
不同于传统方案一步到位的生成逻辑,AnyEdit 把整个任务拆解成语义编辑、声学渲染两大环节。先处理人要说什么、怎么说,再把处理好的人声,放回原始录音真实的声场环境中。整套链路包含三大核心组件,协同完成局部音频修改。
1. 从嘈杂录音里,读懂原本的语气节奏
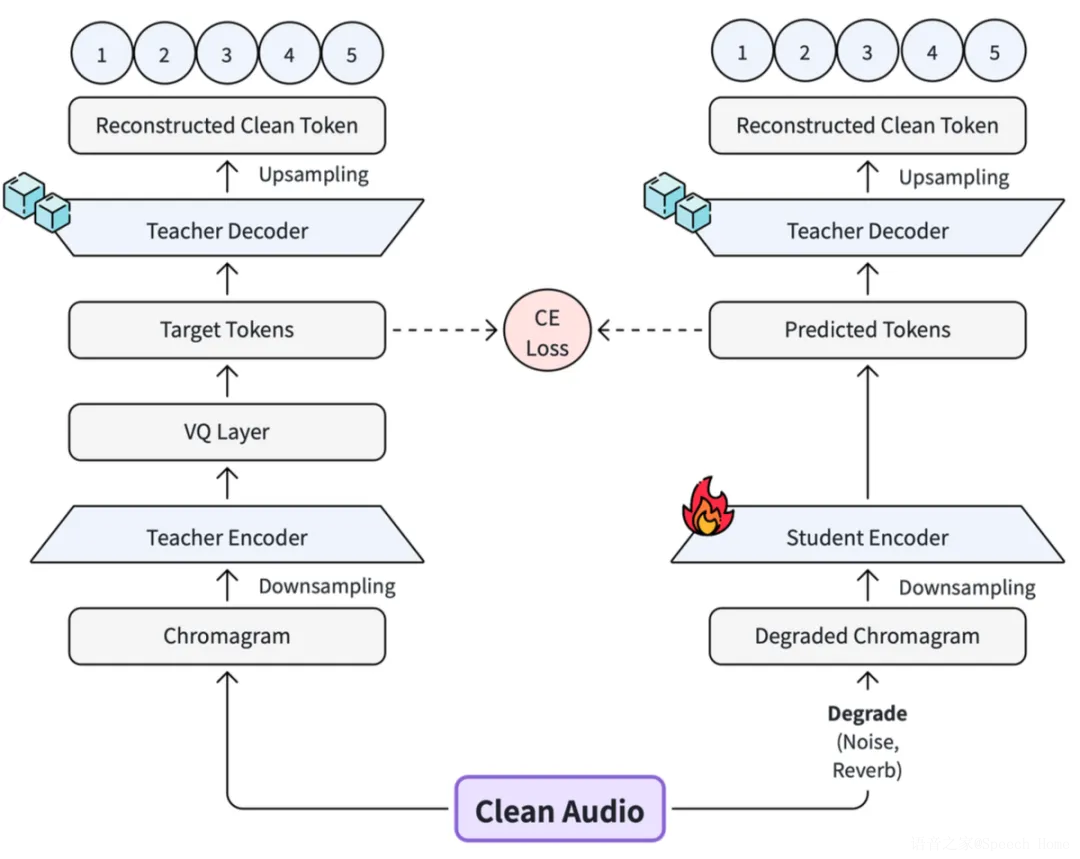
Noise-Robust Prosody Tokenizer训练设计,基于师生蒸馏,学生接收嘈杂录音预测教师模型的干净token序列,从而提升噪声鲁棒性
噪音、回声、伴奏,都会干扰模型识别语速、音高、语调。 这对处理真实世界音频的语音编码器带来了挑战。AnyEdit提出了一种基于师生蒸馏学习的噪声鲁棒语音编码器(Noise-Robust Prosody Tokenizer)。先用大量干净音频训练一个 “老师模型”,学会标准的节奏与韵律;再训练 “学生模型” 专门接收嘈杂录音,逼迫它从充满干扰的音频中,还原出和干净录音一致的语调节奏。 哪怕输入录音环境很吵,模型依旧可以读懂原本说话、唱歌的起伏,给后续编辑打好基础。
2.精准局部编辑,避免无辜片段被连带改动
这一步在虚拟的干净空间完成编辑。我们可以输入想要改成的文字,也可以直接用大白话下达指令,比如 “把这句话改说法”。这里解决音频编辑很常见的 bug:改中间一小段,前后的语气语调却莫名变了。 AnyEdit 会识别原文与修改后文本完全不变的部分,训练时重点约束这一块,强制守住原有语气节奏,避免连带改动。
音频编辑还有一个难题:很难拿到合适训练素材。 想要训练模型改歌词,理想素材是:同一个歌手,同样的旋律,仅仅歌词不一样。 以前大多用 AI 合成歌声来做训练,但合成出来的声音自带机械感,学出来的模型效果也会受影响。
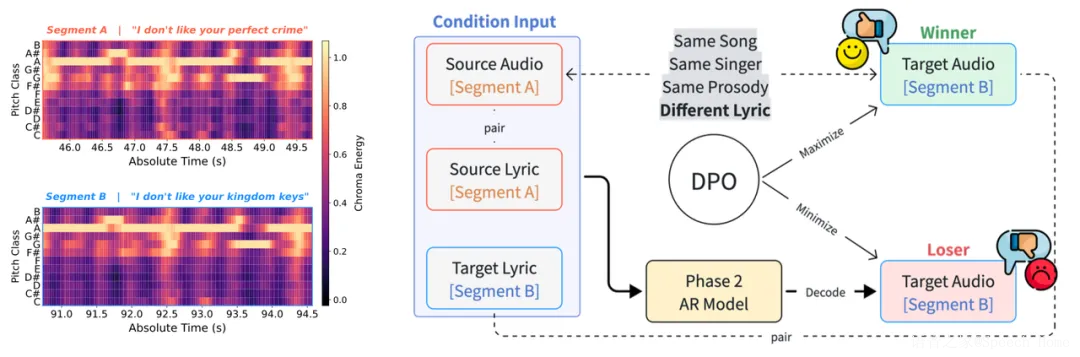
真实数据中挖掘得到的歌声编辑对(左图),以及基于真实数据对的DPO训练流程(右图)
团队换了巧妙思路:流行歌曲大量存在重复段落,同一首歌不同主歌,歌手不变、旋律完全相同,仅仅歌词不一样。程序自动筛选挖掘这类真实演唱片段,攒出几百小时真人对唱样本做偏好优化,不靠合成数据,生成的歌声更加自然。团队基于挖掘得到的数据对,进行了DPO后训练,进一步增强了模型的编辑稳定性。
3.声学渲染:将编辑后的人声融入原始声场
前面两步输出的还只是虚拟的干净人声信息。最后由 Flow‑Matching 模块,把编辑完成的内容融合回原始录音的环境。
训练时一半样本用干净人声,另一半混入噪音、回声、背景音乐。模型学会读懂原始音频的环境特征:噪音大小、房间混响、伴奏风格。修改后的片段会自然继承周边全部背景,不用拆分拼接,也就规避分离带来的各种音质瑕疵。
AnyEditBench:面向真实嘈杂场景的全新评测集
为了公平测试真实环境下的音频编辑能力,研究团队搭建 AnyEditBench 基准数据集: 总计 600 条样本,语音、歌唱各占一半,同时覆盖中英文。分为三大类素材:干净录音、人为叠加噪声混响的模拟音频、网上收集的真实播客与歌曲。
评测不只看文字有没有改对,还要考察:音色是否和本人一致、唱歌旋律会不会跑偏、背景噪音伴奏能否保留;同时加入人工主观打分,做盲听测试,看普通人能不能听出音频经过 AI 编辑。
实际效果:噪音再大,尽量保住背景不翻车
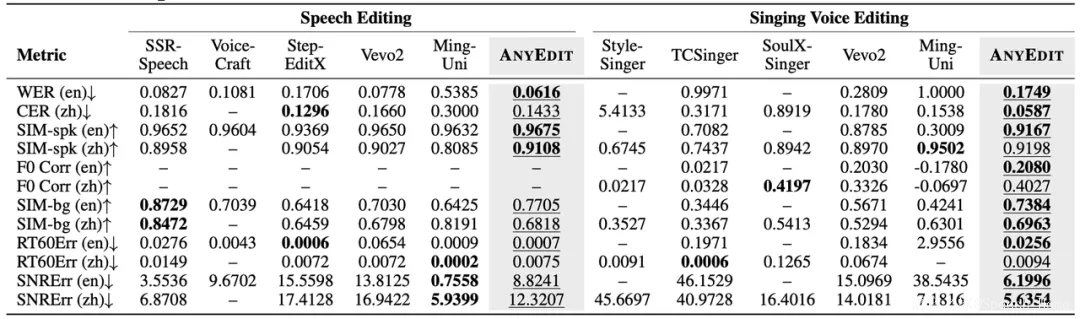
在AnyEditBench上真实世界录音子集上的评估结果,与基线相比AnyEdit取得最优效果。
1. 真实世界录音测试 :面对真实带噪、带伴奏的音频,对比其他方案,AnyEdit 最大优势就是对背景的保留。对照语谱图可以直观看到:其他模型在编辑位置,伴奏、背景直接出现空洞;AnyEdit 修改歌词或文本,背景噪声、伴奏几乎看不出变化。
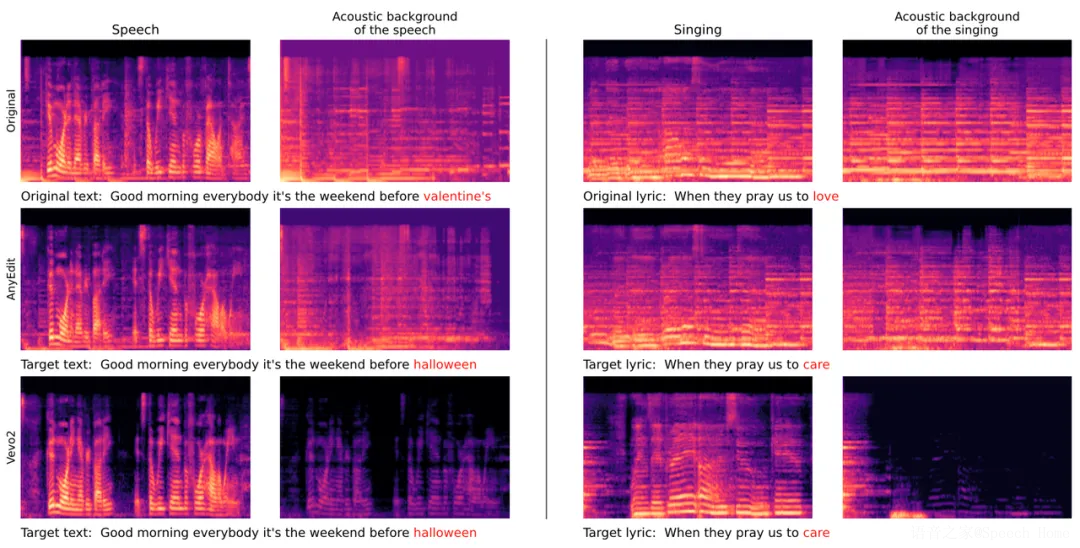
样例分析,基线模型Vevo2编辑时难以保留原始音频的声学特征,而AnyEdit能够精确地保留原始音频的环境声信息,同时实现内容的编辑。
2. 极端恶劣条件测试:即便强噪声、重度房间回声,AnyEdit 依旧做到修改内容准确、保留人声本色、维持背景完整。不少基线模型在这类场景,背景会大面积丢失。
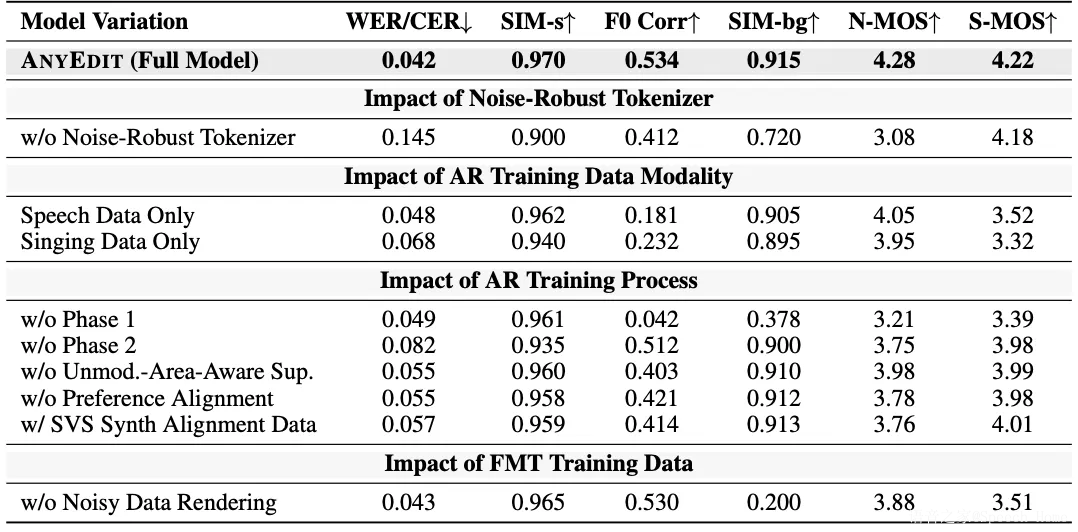
AnyEdit的模块/训练流程/训练数据层面的消融实验结果
消融实验也证明每一项设计都不可或缺:
- 去掉嘈杂环境提取韵律的模块,文字识别错误率大幅上涨;
- 去掉 “保护未修改片段” 的约束,就会出现乱改前后语调的漂移问题;
- 训练歌唱时换成 AI 合成歌声,效果明显变差,证实真人演唱样本的价值;
- 如果最后一步只用干净音频训练,模型完全学不会保留背景噪音。
盲听打分结果同样亮眼:不管说话还是歌唱,自然度、相似度得分优于对比模型;不少样本普通人很难分辨音频被 AI 编辑过。
需要注意的是,现在模型需要大约 10 秒的上下文音频,才可以还原完整的背景环境,处理超长音频片段能力有限,暂时不支持实时编辑。后续计划拓展多语言、实现实时编辑能力。这项技术也存在被滥用风险,可以篡改人声内容。需同步发展伪造人声检测、音频水印等防护手段,防范技术被恶意使用。
「总结」
AnyEdit 最核心的亮点,就是不需要做声源分离,同时实现语音、歌唱的局部音频编辑。
过去修改真实录音,我们总要做取舍:要么改准文字,但背景直接崩坏;要么保住背景,但编辑效果不理想。AnyEdit 把修改内容和环境渲染拆成两个阶段,搭配多项针对性优化,在编辑准确度、人声质感、背景保留三者之间拿到更好的平衡。
伴随着短视频 UGC、播客、音乐二次创作的爆发,这种直接适配现实嘈杂录音的编辑能力,具备非常可观的落地价值。