语音小管家
Faster CosyVoice是 CosyVoice3 语音合成模型的开源 GPU 推理方案。通过 speculative decoding、FlashInfer DiT、跨请求 packed batching、deadline-aware 调度、CUDA Graph 和 CUDA MPS 等一系列优化,在单张 Hopper GPU 上将流式合成的首包延迟(TTFP p50)从 318.8 ms 降至 72.8 ms,音频吞吐(RTFx)从 3.59 提升至 15.06。
CosyVoice3是目前社区流行的 zero-shot 音色克隆 TTS 模型,采用"自回归 LLM + Flow-matching"的两阶段结构:先由 speech-token LLM 逐个生成 25 Hz 的离散语音 token,再由 DiT (Diffusion Transformer) 通过 Flow-matching 将 token 还原成 Mel 声学特征,最后经 HiFT Vocoder 输出波形。这类结构拟人效果好、天然支持流式,但要把它部署成低延迟、高并发的生产级服务并不容易:LLM 的自回归解码和 DiT 的扩散计算各有各的瓶颈,在同一张 GPU 上部署时两个阶段还会互相竞争资源。
Faster CosyVoice针对这条推理链做了系统性的优化。它不只加速单个模块,也处理了两阶段共享 GPU 时的资源竞争、变长请求 padding 和流式任务调度等工程问题,对其他"LLM + Flow-matching"结构的 TTS 系统同样有参考价值。
整体架构
下图是 Faster CosyVoice 的整体架构。服务由 vLLM worker 和 token2wav worker 两个进程组成:前者运行自回归 speech-token LLM(配合 DSpark draft model 做 speculative decoding),后者负责 DiT Flow-matching 和 HiFT Vocoder,中间由 deadline-aware scheduler 衔接。两个进程可选通过 CUDA MPS 在同一张卡上并行执行。
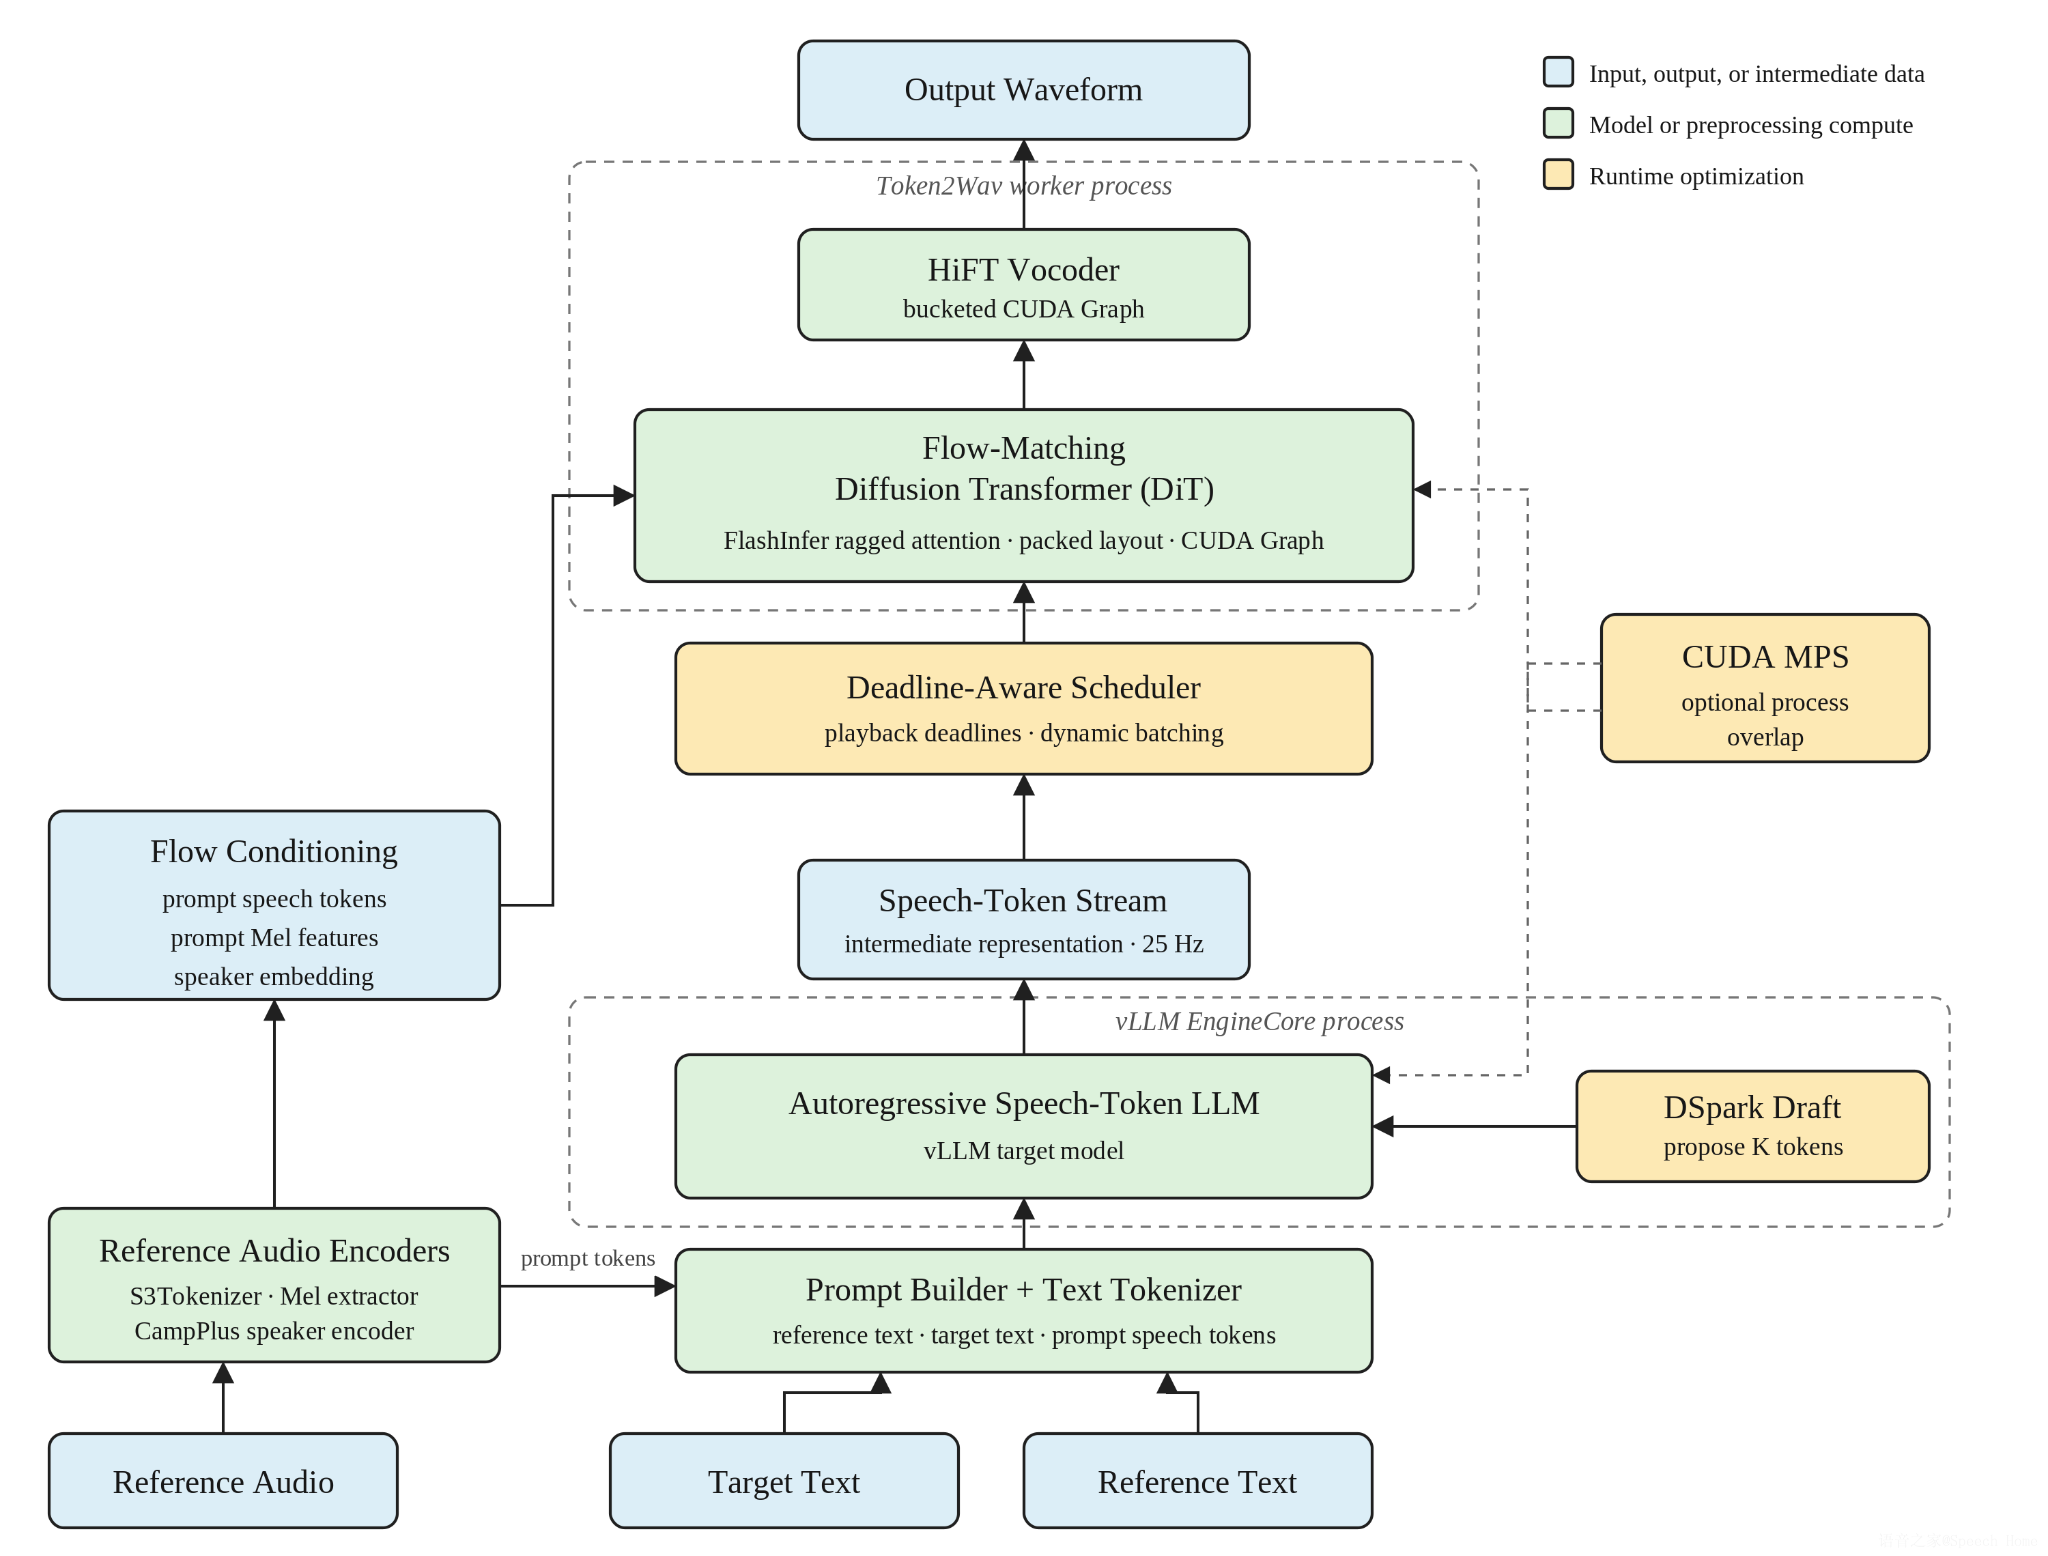
Faster CosyVoice 架构
优化手段
DSpark speculative decoding
speech-token LLM 的自回归解码是首包延迟的大头之一。Faster CosyVoice 引入一个轻量 draft model,一次提出多个 speech token,由 target LLM 并行验证,从而减少 decode step 数量。
FlashInfer DiT
DiT 是 token2wav 阶段的计算主体。这里使用 FlashInfer算子库重写了 DiT 的关键路径:将 padded SDPA 改成 ragged attention,避免对 padding 部分做无效计算,并融合了 QKV、partial RoPE 和 AdaLN 相关操作。
跨请求 packed batching
流式场景下不同请求的 Mel 长度差异很大,常规 padded batch 会浪费大量算力。Faster CosyVoice 将多条请求的有效 Mel 声学特征直接拼接成 packed batch 计算,不引入 padding。
Deadline-aware scheduling
流式合成的本质约束是"音频生成速度必须跑在播放速度前面"。调度器实时跟踪每条 stream 的 buffer 还能播放多久:即将耗尽的请求优先调度,新到请求的首 chunk 也会高优处理,避免个别请求在高并发下 under run。
CUDA Graph
DiT 和 HiFT Vocoder 的单步计算由大量小 kernel 组成,launch 开销不可忽略。服务内置了一组经过验证的 graph bucket,配合固定的 streaming hop 让请求 shape 稳定命中 bucket,设置 --streaming-cuda-graph 开关即可启用。
CUDA MPS
vLLM worker 和 token2wav worker 是两个独立进程,各自持有独立的 CUDA context。默认情况下,GPU 在多个 context 之间只能分时执行:硬件在较粗的时间片边界上于两个 context 间来回切换,同一时刻只有一个进程的 kernel 在跑。于是 LLM decode 的间隙里 token2wav 计算插不进来,反过来也一样,GPU 上留下大量空泡。
CUDA MPS (Multi-Process Service) 通过一个常驻的 daemon 把多个进程提交的 kernel 汇聚到同一个共享 context 下执行,省去了 context 切换,两个进程的 kernel 得以在 SM 粒度上并发:LLM 没占满的 SM 可以同时跑 token2wav 的计算。需要注意,MPS 并不会让单个 kernel 本身变快,收益完全来自两个阶段计算的相互重叠——这正好契合"LLM + token2wav"流水线的负载特点。
性 能
测试在单张 NVIDIA Hopper GPU 上进行:固定参考音频与参考文本,15 秒 warmup 后测量 60 秒。TTFP 指从发起请求到客户端收到第一块可播放音频的时间;RTFx 指测量窗口内生成的音频总时长与墙钟时间之比,越高越好,1 表示实时。
累积消融
下表在单并发下逐项叠加优化,每一行都包含此前步骤的全部优化,所有请求均完整返回、首块音频长度均为 760 ms:
| Step | 累积配置 | TTFP p50 | TTFP p95 |
| A0 | vLLM target-only + Torch Flow | 318.8 ms | 392.9 ms |
| A1 | A0 + DSpark LLM | 267.4 ms | 325.3 ms |
| A2 | A1 + FlashInfer DiT | 146.0 ms | 159.7 ms |
| A3 | A2 + packed DiT batching | 137.7 ms | 148.7 ms |
| A4 | A3 + DiT CUDA Graph | 121.0 ms | 127.8 ms |
| A5 | A4 + HiFT CUDA Graph | 106.5 ms | 113.3 ms |
| A6 | A5 + CUDA MPS | 72.8 ms | 82.0 ms |
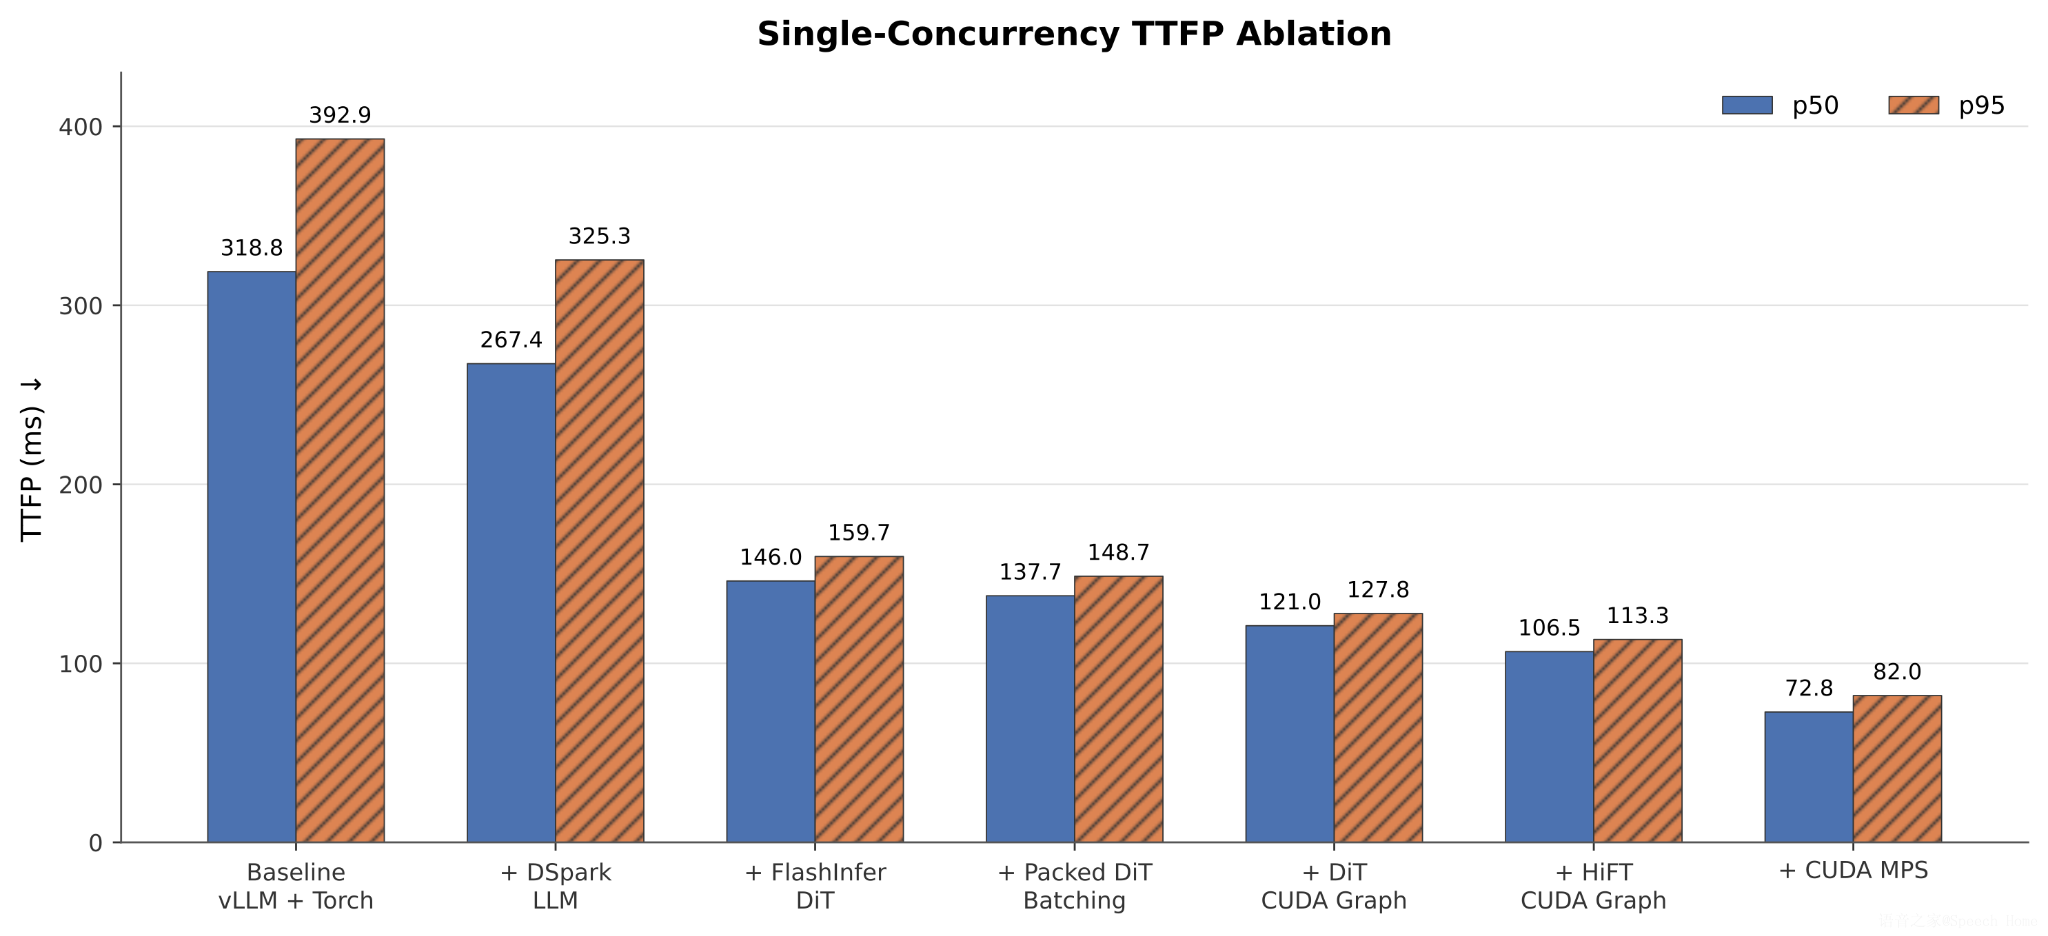
Faster CosyVoice 单并发 TTFP 累积消融:p50 与 p95
从 A0 到 A6,单并发 TTFP p50 降低 77.2%,p95 降低 79.1%。其中收益最大的两步是 FlashInfer DiT(p50 从 267.4 ms 降到 146.0 ms)和 DSpark speculative decoding(从 318.8 ms 降到 267.4 ms),说明 baseline 的延迟主要来自 DiT 和 LLM 这两个模型的计算本身;而在计算优化基本做完之后,CUDA MPS 又把 p50 从 106.5 ms 进一步降到 72.8 ms,说明两阶段同卡部署时的调度空泡同样不可忽视。
与其他框架对比
我们在相同的固定并发负载下,将 Faster CosyVoice 与 Triton Inference Server 方案(TensorRT-LLM + TensorRT)和 vLLM-Omni 进行了对比。固定并发 C 表示同时运行 C 个 worker,每个 worker 等当前请求完整结束后才发送下一条。
TTFP p50(越低越好):
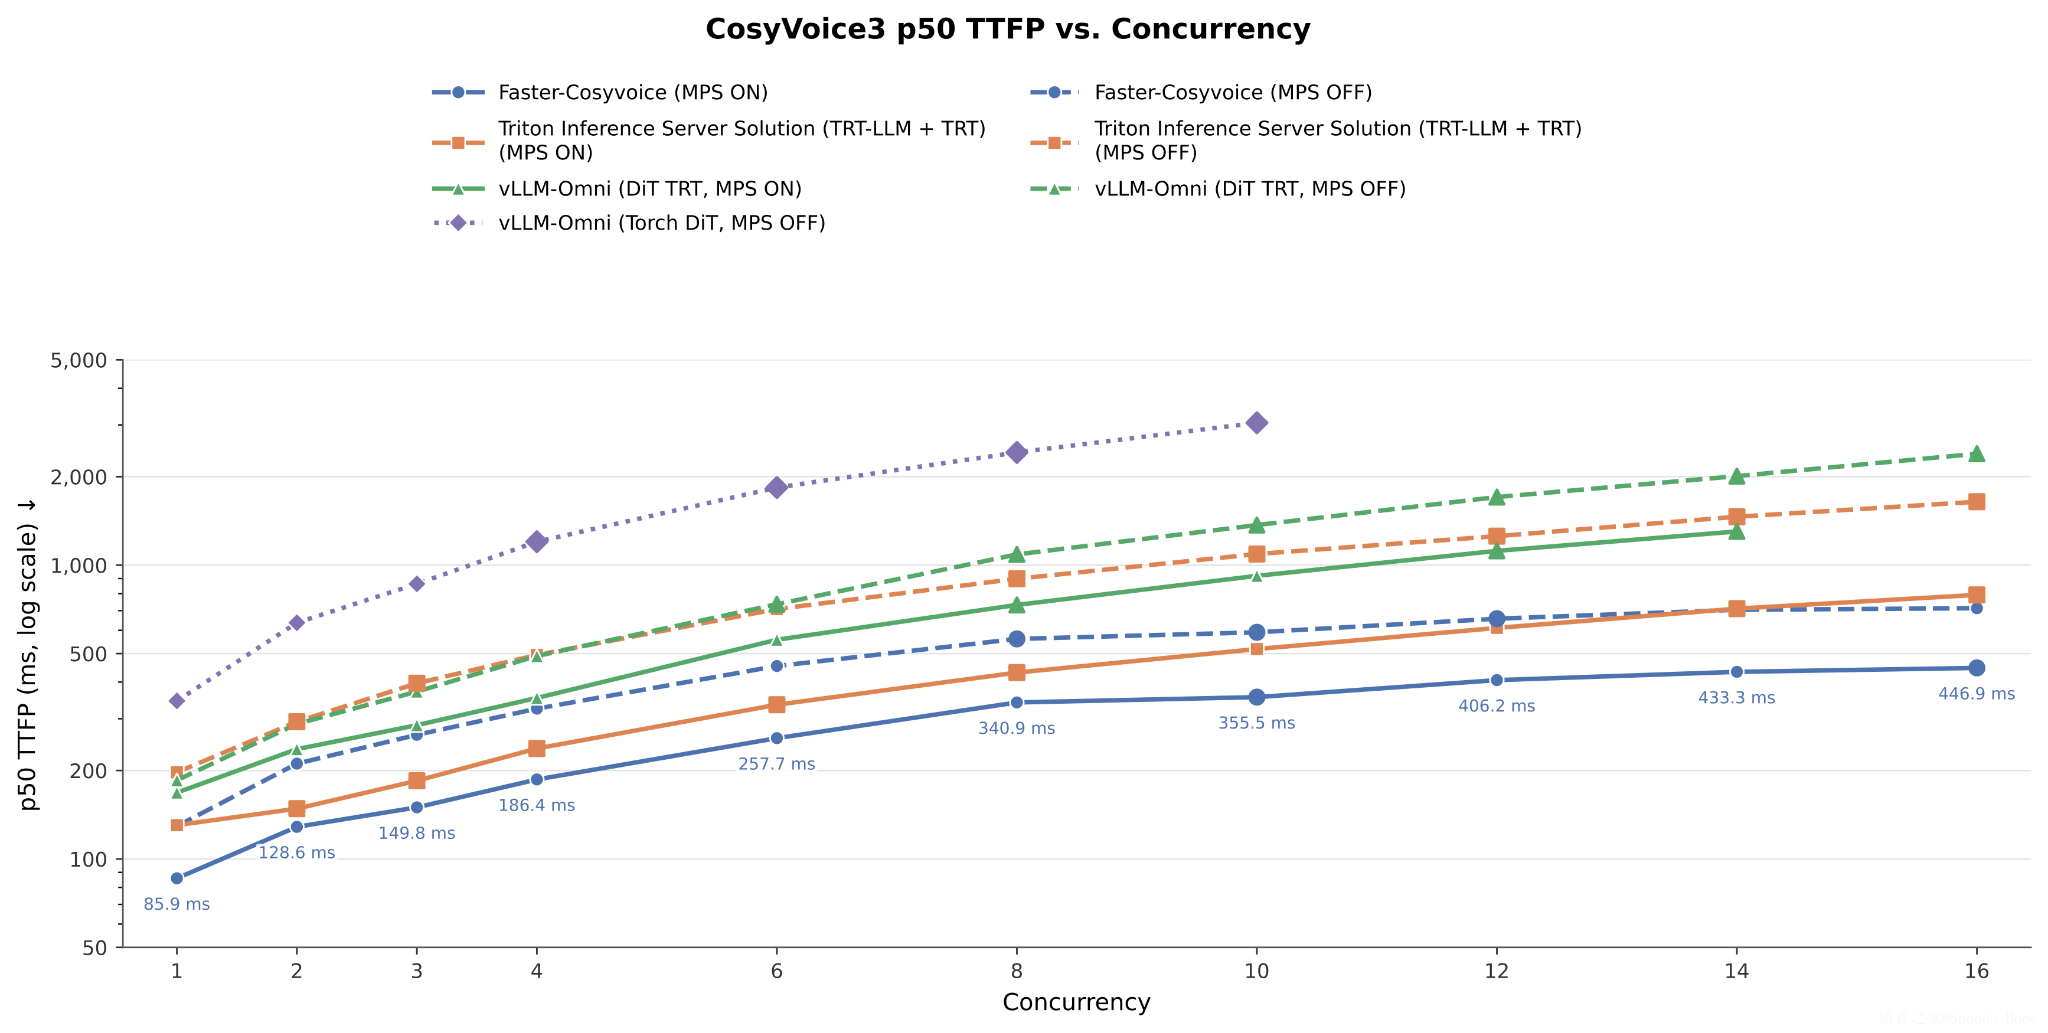
CosyVoice3 固定并发 TTFP p50
TTFP p95(越低越好):
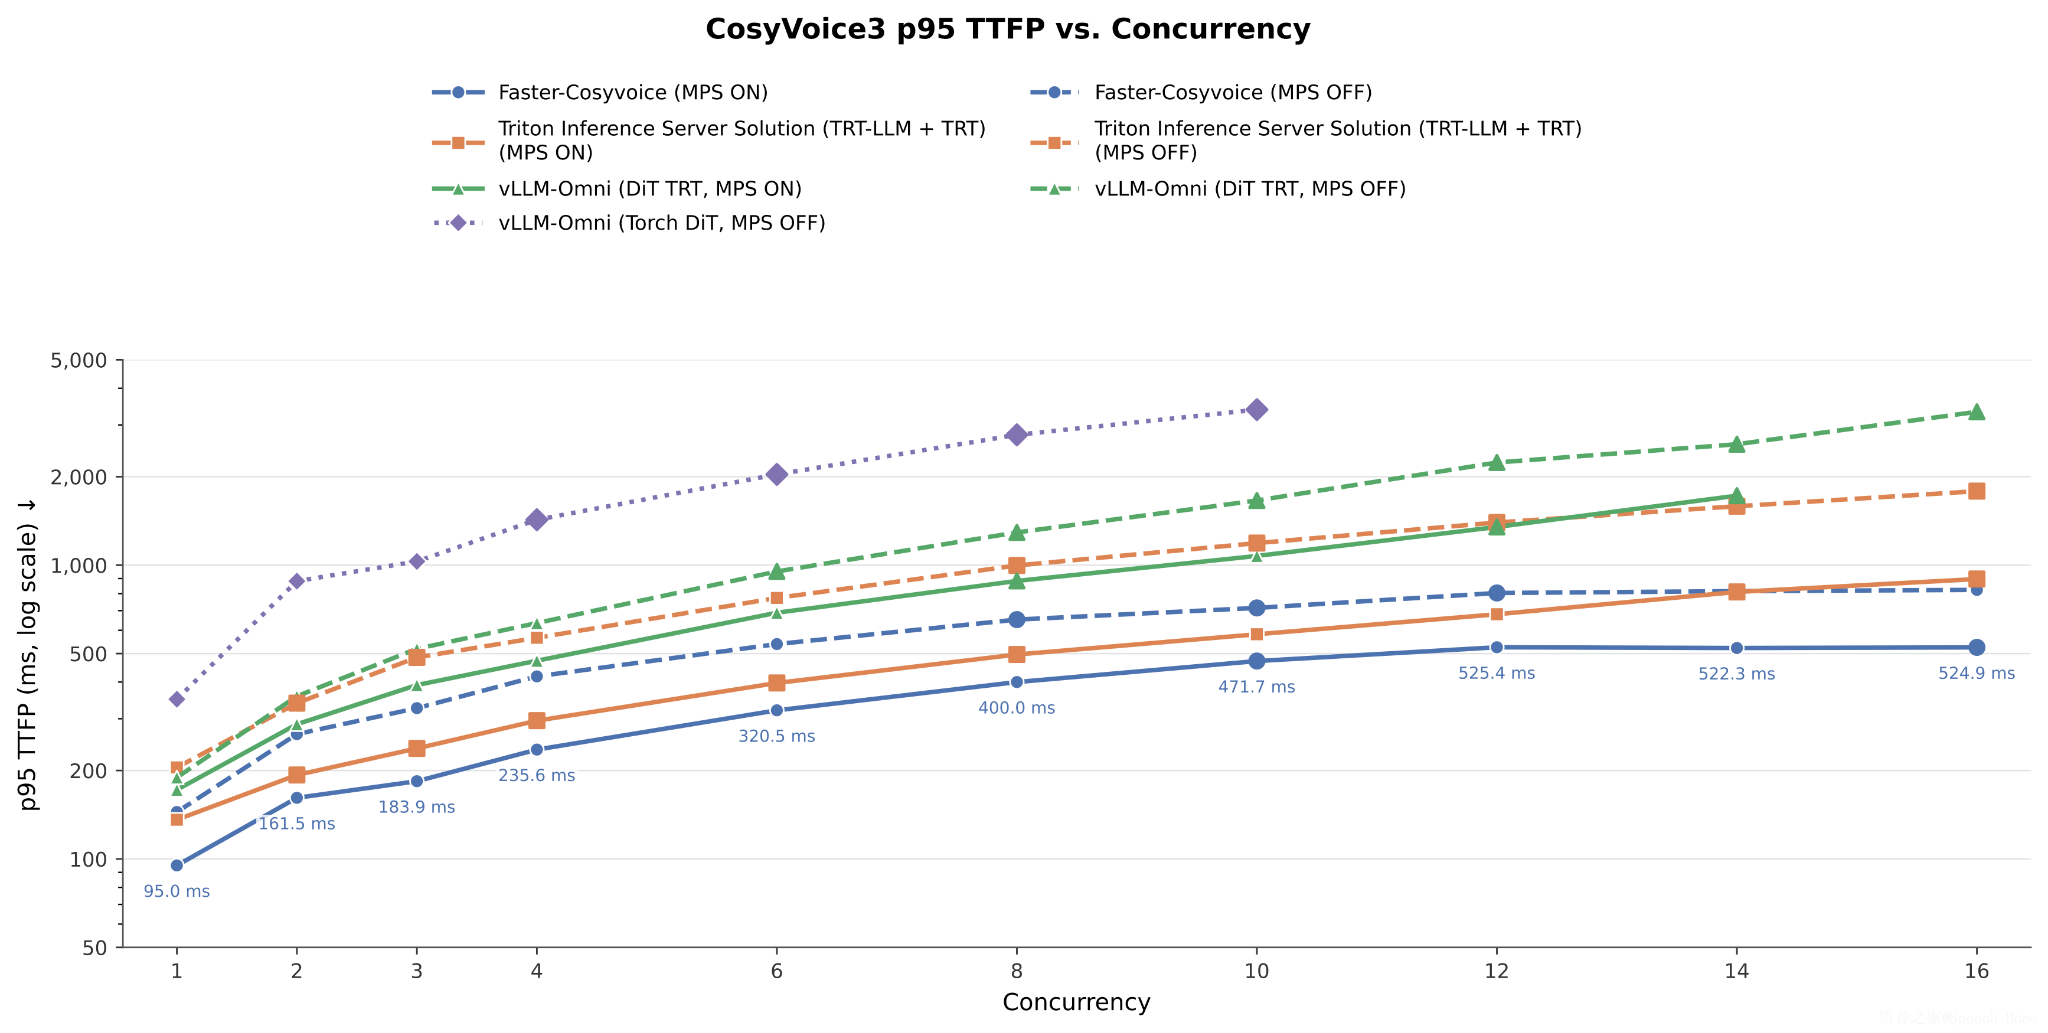
CosyVoice3 固定并发 TTFP p95
音频吞吐 RTFx(越高越好):
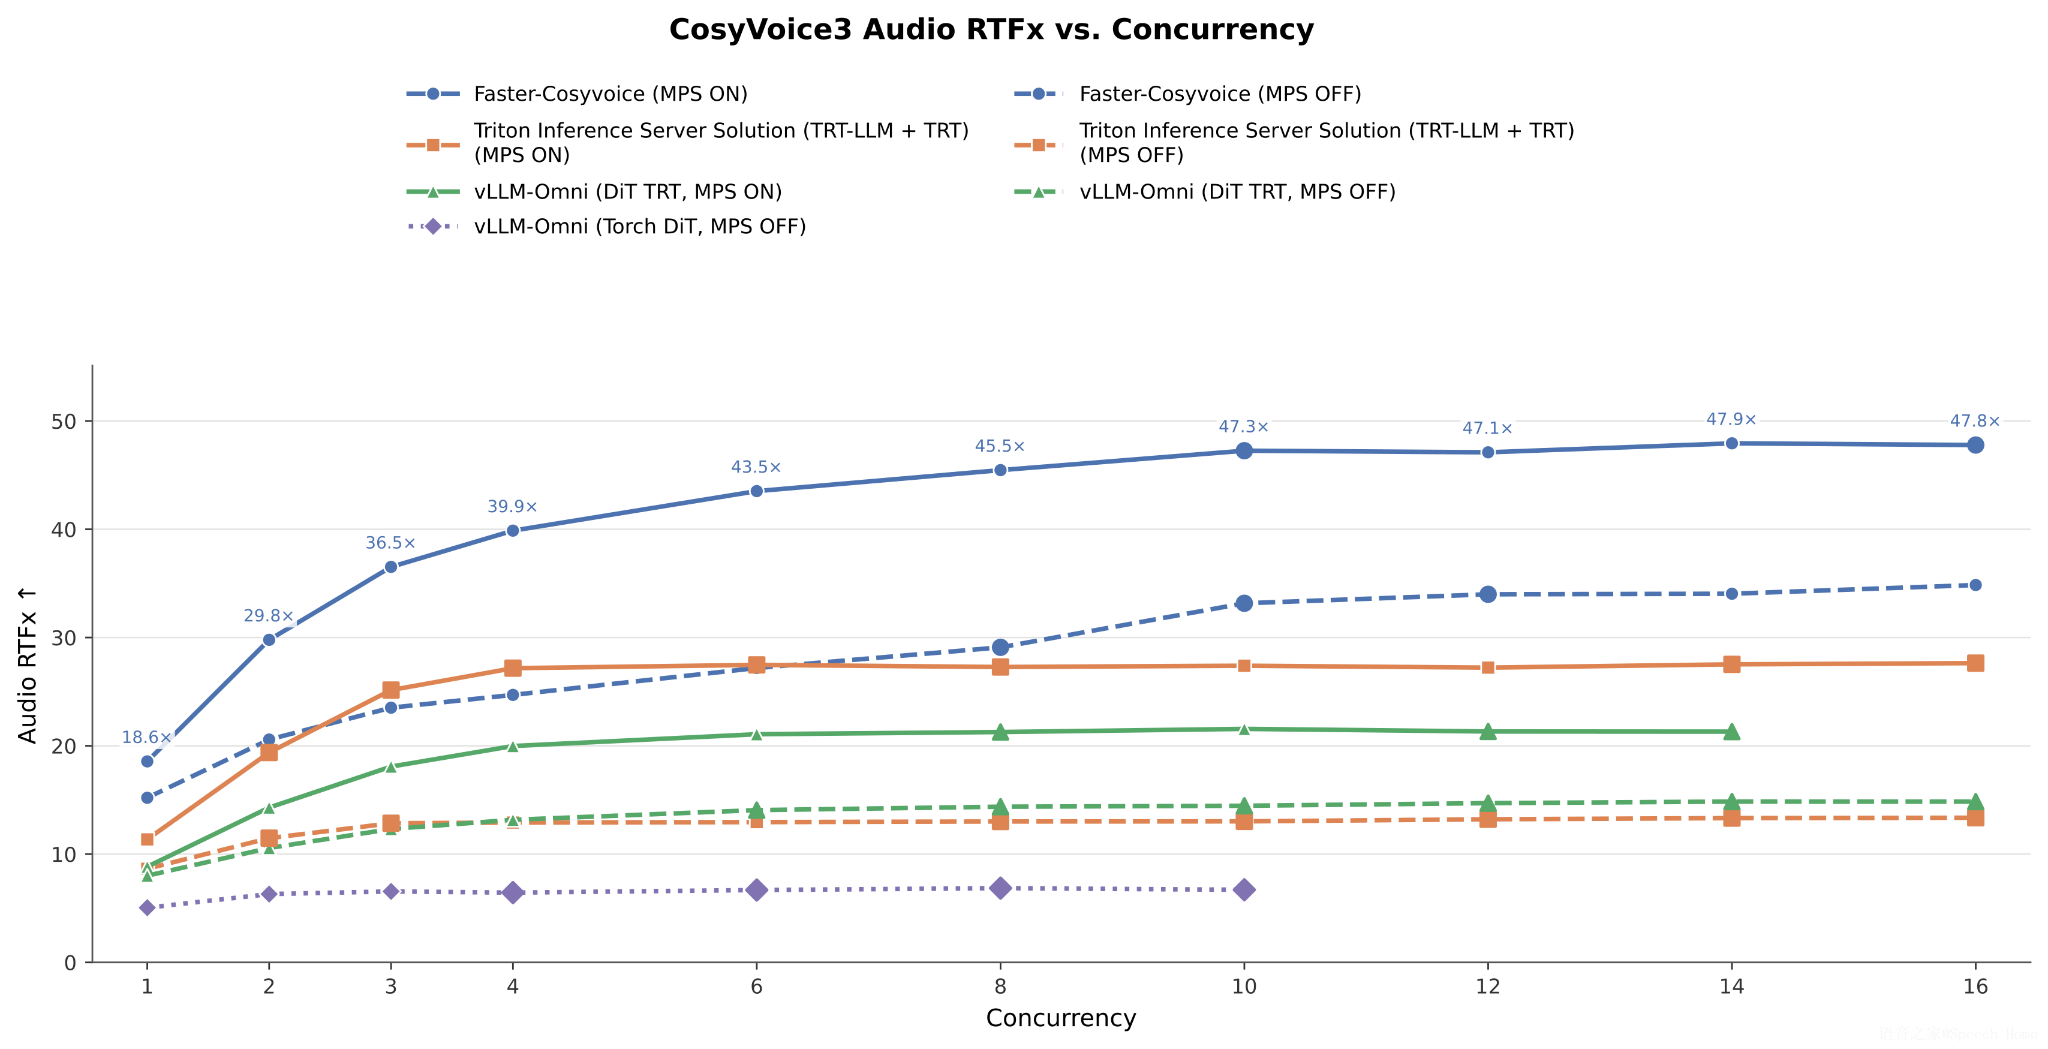
CosyVoice3 固定并发音频吞吐 RTFx
可以看到,Faster CosyVoice 在各并发档位上同时保持了更低的首包延迟和更高的吞吐:单并发 TTFP p50 为 72.8 ms;并发 8 时 TTFP p50 仍维持在 324.3 ms,RTFx 达到 30.37,即单卡每秒可生成约 30 秒音频。
快速上手
安装只需 uv sync:
git clone https://github.com/yuekaizhang/faster-cosyvoice.git
cd faster-cosyvoice
uv sync --frozen启动服务。speculative decoding、FlashInfer DiT、packed batching 和 deadline-aware scheduler 是内置默认;下面的命令额外开启 speaker encoder TensorRT 和 CUDA Graph:
uv run --frozen faster-cosyvoice-server \
  --host 0.0.0.0 \
  --port 8000 \
  --speaker-encoder-tensorrt \
  --speech-token-chunk-size 25 \
  --speech-token-chunk-growth 1 \
  --streaming-cuda-graph
发送一条 zero-shot 音色克隆的流式请求:
uv run --frozen python examples/stream_client.py \
  --ref-audio ref.wav \
  --ref-text "参考音频的准确文本。" \
  --target-text "这是一次 zero-shot voice clone 请求。" \
  --out speech.wav
服务同时提供 OpenAI 格式的 POST /v1/audio/speech 接口,支持先注册音色再按名称复用,方便接入现有的对话应用:
curl http://127.0.0.1:8000/v1/audio/speech \
  -H 'Content-Type: application/json' \
  -d '{
    "model": "faster-cosyvoice",
    "input": "Hello from Faster CosyVoice.",
    "voice": "demo",
    "response_format": "wav"
  }' \
  --output speech.wav
如需进一步开启 CUDA MPS(需在服务进程外单独启动 daemon)、做离线批量推理或自定义 CUDA Graph bucket,请参考仓库中的使用指南和 Benchmark 文档。
总 结
Faster CosyVoice 展示了"LLM + Flow-matching"两阶段 TTS 系统的一条完整优化路径:LLM 侧用 speculative decoding 减少 decode step;DiT 侧用 FlashInfer ragged attention、算子融合和 packed batching 消除冗余计算;再用 CUDA Graph 压缩 kernel launch 开销,用 deadline-aware 调度保障流式播放不断流,最后用 CUDA MPS 填补两阶段同卡部署的调度空泡。这些优化叠加后,单张 Hopper GPU 上 CosyVoice3 的流式首包延迟降低 77.2%,吞吐提升至 4 倍以上。
项目地址:https://github.com/yuekaizhang/faster-cosyvoice
引用链接
[1] Faster CosyVoice: https://github.com/yuekaizhang/faster-cosyvoice
[2] CosyVoice3: https://github.com/QwenAudio/CosyVoice
[3] Faster CosyVoice: https://github.com/yuekaizhang/faster-cosyvoice
[4] FlashInfer: https://github.com/flashinfer-ai/flashinfer
[5] 使用指南: https://github.com/yuekaizhang/faster-cosyvoice/blob/main/docs/usage.md
[6] Benchmark 文档: https://github.com/yuekaizhang/faster-cosyvoice/blob/main/docs/benchmark.md