西工大音频语音与语言处理研究组
声纹识别是语音领域一个重要的问题,一个鲁棒性强的声纹模型也能够让许多下游任务(语音分离,说话人日志等)受益。然而,声纹识别一个重要的痛点在于说话人人数的多少,这也间接影响着语种,信道的多样性。为了丰富开源语音语料库,为训练声纹大模型提供强有力的支持,武汉大学联合中国移动九天人工智能团队和昆山杜克大学,基于YouTube数据,开源了超过11万的音视频说话人识别数据集VoxBlink2,其总时长超过了1.6万小时,相关的下载方式和模型已开源,该论文已被 InterSpeech2024 接收。数据集仅用于研究性质,非商业用途。发布的数据集仅包含YouTube 视频链接、时间戳和说话者ID标签,不包含音频或视频数据,用户有责任决定是否下载视频数据,以及他们下载数据的预期目的在其国家/地区是否合法。
数据集网站:
数据集下载方式:
元文件和模型:
论文地址:https://arxiv.org/abs/2407.11510
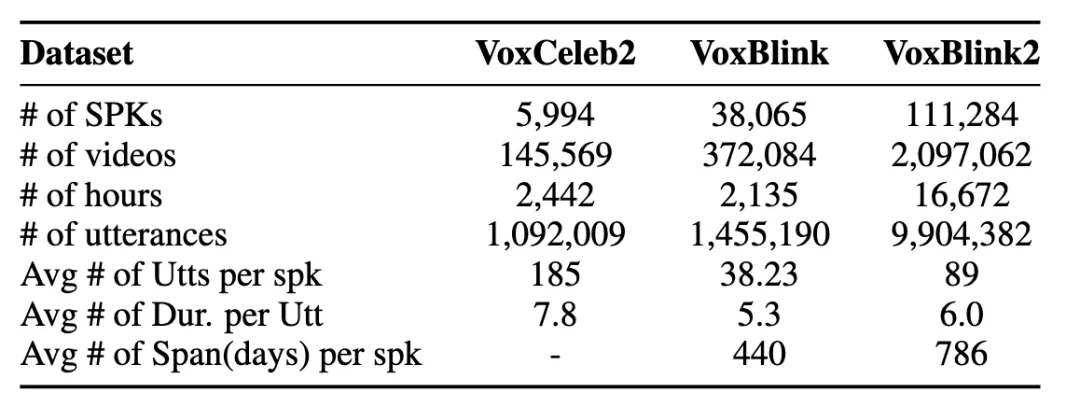
VoxBlink2数据集由9904382个高质量的音频片段及其相应的视频片段组成,这些片段来自于YouTube上的111284名用户。到目前,它是最大的公开可用的音视频说话人识别数据集,将说话人人数扩大了1个量级。和之前提出的VoxBlink不同,其在单音频时长和单说话人时变上都拥有更优异的特性。另外,它也提供了更丰富的元信息(视频主题,发布时间和标签)和弱文本标注,统计数据如下图所示:
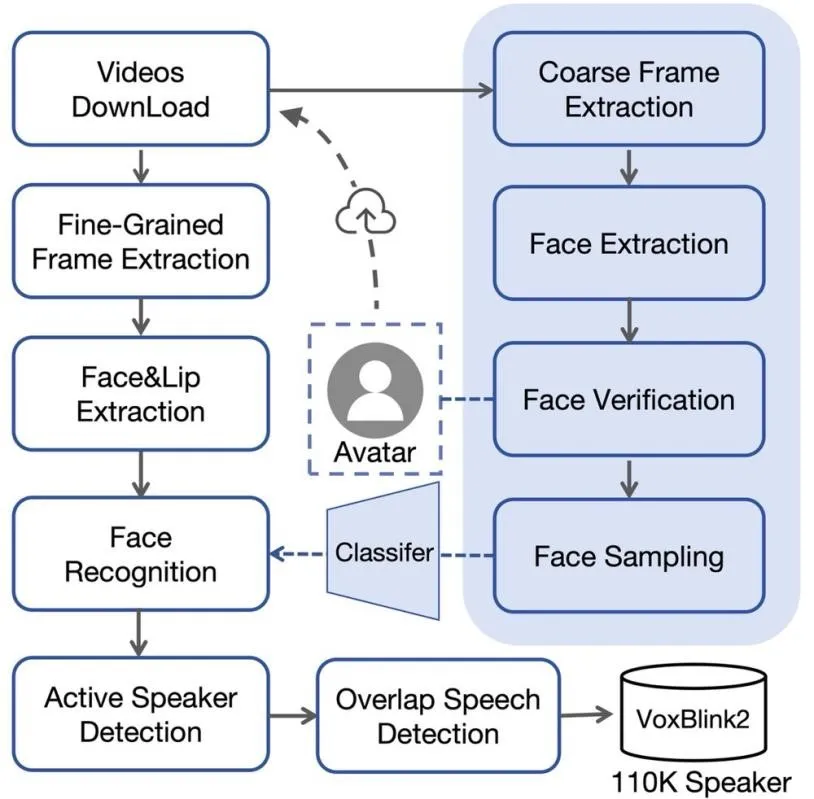
候选人准备:首先收集了约十八国语种的关键词列表用作用户检索,然后收集包含用户人脸作为头像的用户视频,方便起见,我们只选取前一分钟的用户视频用于后续处理;
人脸提取&检测:使用较高的fps来抽取视频帧,并通过MobileNet获取视频帧中的人脸,另外我们使用预设好的IOU阈值来确保获取的视频轨仅包含单个说话人;
人脸识别:使用预训练的集内人脸识别器来对视频轨的人脸进行逐帧的识别,确保当前说话人下的视频和音频片段来源于同一个人;
活动说话人检测:利用人脸提取得到的唇动序列和经过人脸识别筛选得到的相应音频,通过一个Audio-Visual-based Seq2Seq的多模态活动说话人检测器,输出得到发声的片段,并通过混叠检测再次筛选去除多说话人的片段,提高音视频的质量。
粗力度人脸提取:使用一个较低的FPS来提取视频帧,并使用同样的人脸模型进行人脸提取;
人脸验证:提取目标用户头像和视频人脸的嵌入,并输出人脸相似度得分;
人脸采样&训练:根据相似度得分进行人脸带权采样,每个说话人取上限为10张人脸用于训练基于ResNet的集内人脸识别器。经过简单的人工采样发现,比起VoxBlink,VoxBlink2的数据准确率从72%提高到了92%。
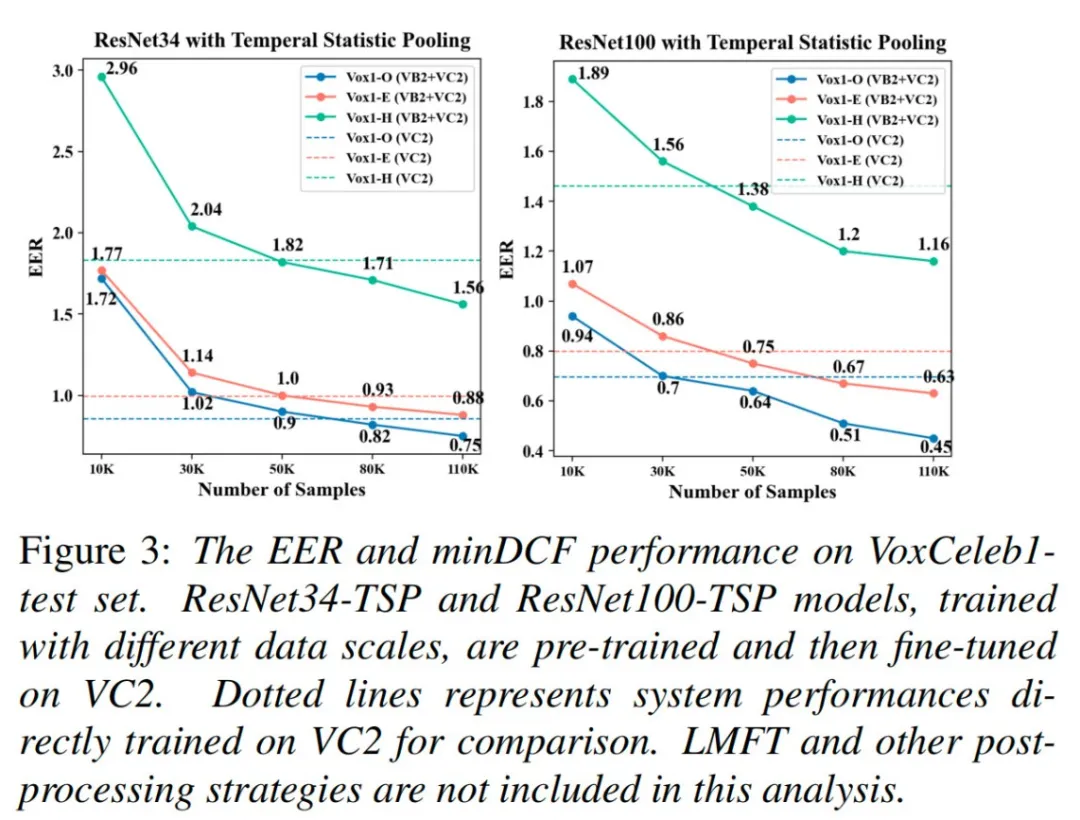
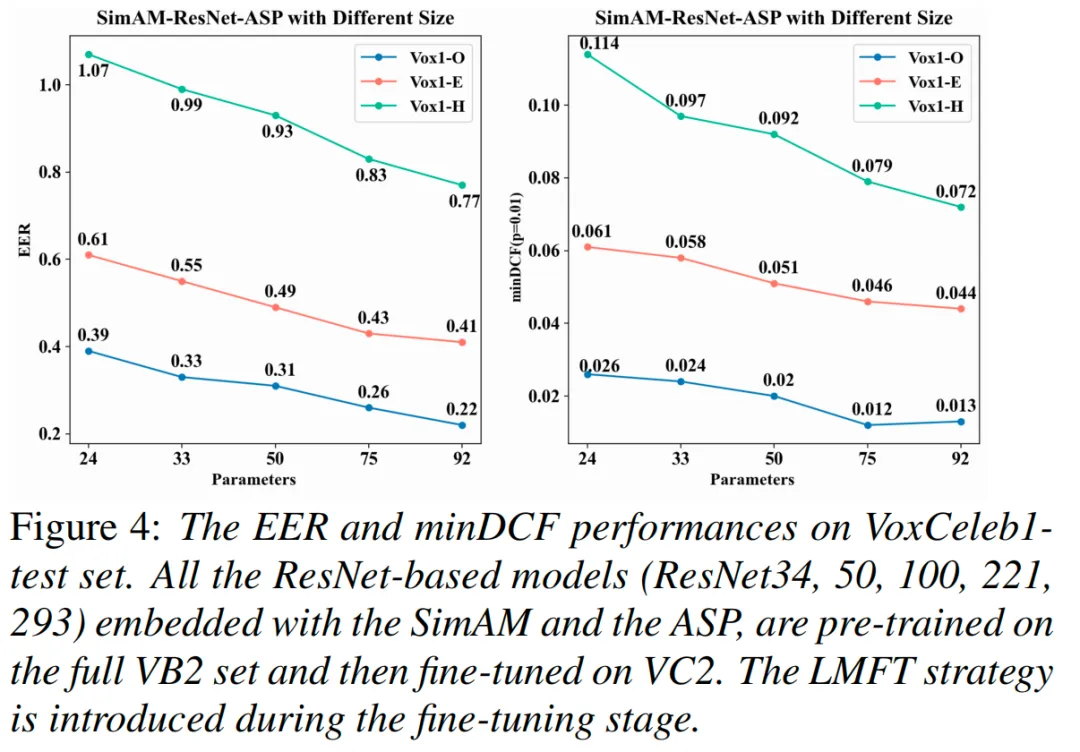
为了进一步促进声纹基线模型的发展,我们开源了不同大小的声纹模型用于研究者使用,其中包含了基于ResNet的2D卷积模型和基于ECAPA-TDNN的时序模型,另外我们也提出了一个较大的基于Simple Attention Module的超大模型ResNet293,其在Vox1-O数据集上经过Score Norm和QMF的后处理后可以达到0.17%的EER和0.006%的minDCF,其他的模型评测结果参考: