
声浪

SoulX-Transcriber:Soul App与西工大开源端到端多人对话转录模型

近日,Soul AI Lab与西北工业大学音频语音与语言处理研究组、Moonstep AI,开源了端到端多人对话转录模型SoulX-Transcriber。 作为一款面向长音频、多说话人场景设计的语音理解模型,SoulX-Transcrib…
27 1 0
ElevenLabs发布Music V2:AI音乐迈入可编辑创作阶段
来源丨AI音频时代、Renee 创业随笔 近日,ElevenLabs 发布了新一代音乐模型 Music v2,目前已经可以在 ElevenMusic 和 ElevenCreative 中使用。 Stable Audio 3.0刚刚升级后(S…
19 0 0
ICME 2026|语音对话系统中的语义打断检测:基准测试、指标和模型
在自然的人机对话中,“系统能否被打断”以及“何时应停止发言并转而倾听用户”是决定交互自然性的关键问题。理想的语音对话系统(Spoken Dialogue System, SDS)不应只是机械地遵循“你一句、我一句”的轮替模式,而应像人与人交…
24 0 0
AI 制造 AI:全球首个完全由 AI 编写的生产级训练框架 ForgeTrain 发布并开源
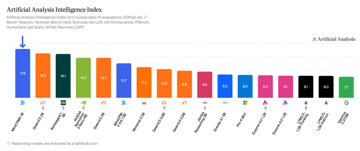
近日,清华大学自然语言处理与社会人文计算实验室与面壁智能、OpenBMB 开源社区正式发布ForgeTrain——全球首个完全由 AI 编写、零人类代码介入的生产级大模型训练框架。 它不是一个实验原型,而是一套可以直接投入生产、创造价值的“…
26 0 0
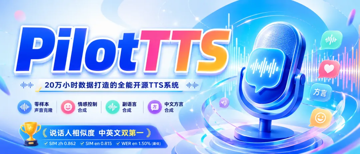
高德语音用20万小时数据做出来的开源TTS,说话人相似度拿了第一 ,支持11种情感+14类方言
论文链接:https://arxiv.org/abs/2605.27258 项目主页:https://amapvoice.github.io/PilotTTS/ GitHub Repo:https://github
35 0 0
Dasheng AudioGen:语音、音乐、音效一次生成,让 AI 成为“声音导演”
上海交通大学 X-LANCE 实验室与小米联合发布的 Dasheng AudioGen,不再独立建模语音、音乐、音效生成任务,而是让 AI 像“声音导演”一样理解真实世界音频中多种声音的复杂关系,并端到端生成自然、协调的混合音频场景。 在线…
24 0 0
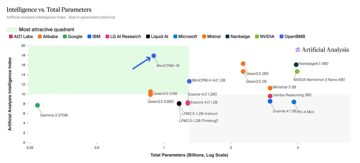
2B 以下全球最优、开放数据集……MiniCPM5-1B 正式发布并开源!
来源丨清华大学自然语言处理与社会人文计算实验室 昨日,清华大学自然语言处理与社会人文计算实验室与面壁智能、OpenBMB 开源社区正式发布并开源最新一代端侧文本基座大模型——MiniCPM5-1B。 MiniCPM5-1B 再次刷新模型的智…
45 0 0