STAR-VAE:让音频潜在空间「按信息重要性」排列,重建与生成双双达到 SOTA

来源丨阿里语音AI 阿里团队的最新研究STAR-VAE已被机器学习顶级会议ICML 2026接收。这项工作聚焦音频生成中一个长期被忽视、却决定效果上限的底层环节——音频 VAE(连续 tokenizer),并提出了一种通用且即插即用的正则化…
33 0 0

来源丨阿里语音AI 阿里团队的最新研究STAR-VAE已被机器学习顶级会议ICML 2026接收。这项工作聚焦音频生成中一个长期被忽视、却决定效果上限的底层环节——音频 VAE(连续 tokenizer),并提出了一种通用且即插即用的正则化…
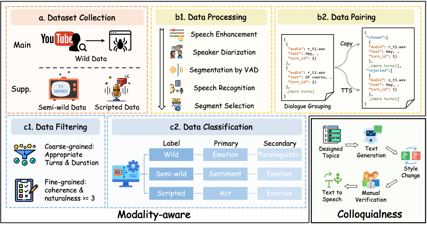
近日,浙江大学团队提出的论文SDiaReward: Modeling and Benchmarking Spoken Dialogue Rewards with Modality and Colloquialness被ACL 2026 Ma…
今天,和大家分享阿里语音交互模型 Fun-Realtime-AudioChat 的全面升级(现已更名为 Qwen-Audio-3.0-Realtime),为大家带来这套完备的实时语音交互对话方案。 亮点速看 1. 根据语境动态调整语气与情感…
来源丨魔搭社区 通义万相开源 Wan-Dancer,一款音乐驱动的人像舞蹈视频生成模型。输入一张人物照片和一段音乐,即可自动生成节奏精准、动作流畅、风格鲜明的高质量舞蹈视频。首次突破分钟级时序瓶颈,支持15秒到3分钟的超长连贯输出,覆盖中国…
近年来,音频语言模型(Audio Language Model, ALMs)推动语音理解从传统单任务系统走向统一的音频到文本生成范式。在这一框架下,说话人验证、语音识别、说话人识别与时间戳标注等任务都可以被重新组织为可交互、可解释的生成式任…
本期分享国防科技大学与湖南师范大学近期发表在IEEE Transactions on Neural Networks and Learning Systems的一篇语音人脸多模态学习的综述文章。 【论文标题】A Survey on Huma…
以下文章来源于433的3号同学,作者贾彦 一、结论先行 过去四年,音频智能的核心范式发生了五次迁移: 先形成可复用的两类听觉前端。Whisper 提供稳健的语音语义表征,解决“说了什么”;CLAP 提供通用声音—文本对齐,解决“这是什么声音…