
INTERSPEECH 2026 | WhispEar: 把你的悄悄话转成正常语音

以下文章来源于Amphion 在隐私通话、声带受损恢复等场景中,耳语转正常语音(Whisper-to-Normal, W2N) 技术至关重要。但这一领域长期被一个“死结”困住:数据极度匮乏。 耳语缺乏声带振动和基频,声学线索严重退化,导致转…
62 0 0

以下文章来源于Amphion 在隐私通话、声带受损恢复等场景中,耳语转正常语音(Whisper-to-Normal, W2N) 技术至关重要。但这一领域长期被一个“死结”困住:数据极度匮乏。 耳语缺乏声带振动和基频,声学线索严重退化,导致转…

以下文章来源丨NJU语音实验室 南京大学与Video Rebirth 等单位联合提出并开源 Foley-Omni。区别于仅同时支持多种单任务的通用生成模型,Foley-Omni 进一步面向完整视频音轨生成,在统一框架中联合建模语音、音效与音…


近日,HKUST Audio 团队推出新一代联合音视频生成模型 Talker-T2AV。该模型面向talking head 场景,将传统 TTS 从单一语音生成进一步拓展到 文本到音频+视频联合生成,能够同时生成自然语音与同步的人脸运动,为…

本期分享中国科学技术大学语音及语言信息处理国家工程研究中心研究团队近期发表在IEEE Transactions on Audio, Speech and Language Processing期刊上的2篇关于超低码率语音编解码器的研究。 0…


近日,Soul AI Lab与西北工业大学音频语音与语言处理研究组、Moonstep AI,开源了端到端多人对话转录模型SoulX-Transcriber。 作为一款面向长音频、多说话人场景设计的语音理解模型,SoulX-Transcrib…
来源丨AI音频时代、Renee 创业随笔 近日,ElevenLabs 发布了新一代音乐模型 Music v2,目前已经可以在 ElevenMusic 和 ElevenCreative 中使用。 Stable Audio 3.0刚刚升级后(S…
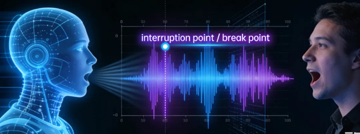
在自然的人机对话中,“系统能否被打断”以及“何时应停止发言并转而倾听用户”是决定交互自然性的关键问题。理想的语音对话系统(Spoken Dialogue System, SDS)不应只是机械地遵循“你一句、我一句”的轮替模式,而应像人与人交…

