
IEEE T-ASLP | 面向资源受限场景的高效说话人深度表征学习训练框架

随着深度学习技术在语音领域的广泛应用,说话人验证(Speaker Verification, SV)系统正朝着更深、更大的神经网络架构演进。以 ResNet101、DF-ResNet 等为代表的深度嵌入提取器显著提升了系统性能,但其高昂的…
20 0 0

随着深度学习技术在语音领域的广泛应用,说话人验证(Speaker Verification, SV)系统正朝着更深、更大的神经网络架构演进。以 ResNet101、DF-ResNet 等为代表的深度嵌入提取器显著提升了系统性能,但其高昂的…

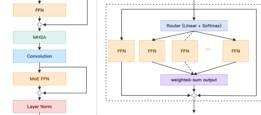
基于热词检索与强化学习的 LLM-ASR 上下文偏置新框架。 论文:Contextual Biasing for LLM-based ASR with Hotword Retrieval and Reinforcement Learning…
来源丨新智元 你有没有发现,你让AI读一篇长文章,结果它读着读着就忘了前面的内容? 你让它处理一份超长的文档,结果它给出来的答案,牛头不对马嘴? 这个现象,学术界有个专门的名词,叫做上下文腐化。 这也是目前AI的通病:大模型的记忆力太差了,…

在生成式 AI 技术日新月异的背景下,合成语音的逼真度已达到真假难辨的水平,随之而来的语音欺诈与信息伪造风险也愈演愈烈。作为应对手段,语音鉴伪技术已成为信息安全领域的研究重心。 然而,当前的语音鉴伪模型正面临严峻的「泛化性挑战」:许多在特定…
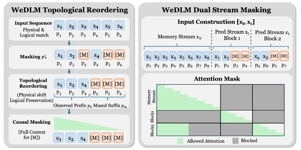
来源丨机器之心 讯微信 AI 团队提出 WeDLM(WeChat Diffusion Language Model),通过在标准因果注意力下实现扩散式解码,在数学推理等任务上实现相比 vLLM 部署的 AR 模型 3 倍以上加速,低熵场景更…

语音情感识别(Speech Emotion Recognition, SER)旨在从语音信号中自动识别说话人的情感状态,是实现自然人机交互和情感计算的关键技术。随着大型音频语言模型(Audio Language Models, ALMs)的…
写在前面 回复整个2025年的TTS发展,可以看到一个非常明显的趋势就是:大模型正在重新构建语音合成的范式。遥想2023年年初,我还在思考如何基于fastspeech的框架来打磨各个module的细节来提升表现力,训练数据最多也就在数百小时…
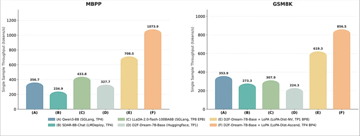
在大语言模型(LLMs)领域,扩散大语言模型(dLLMs)因其并行预测特性,理论上具备超越传统自回归(AR)模型的推理速度潜力。然而在实践中,受限于现有的解码策略,dLLMs 的单步生成往往局限于 1-3 个 Token,难以真正释放其并行…

近日,来自香港大学和字节跳动的研究团队提出了一种简单有效的框架 ——JoVA,它支持视频和音频的 Token 在一个 Transformer 的注意力模块中直接进行跨模态交互。为了解决人物说话时的 “口型 - 语音同步” 问题,JoVA 引…
